
https://juejin.im/post/5e2159215188254e1c43a585
一个测试同学的,互帮互助。
-
85 个赞 / 98 条回复
-
56 个赞 / 18 条回复
-
55 个赞 / 46 条回复
-
48 个赞 / 38 条回复
-
39 个赞 / 78 条回复
-
9 个赞 / 7 条回复
-
8 个赞 / 8 条回复
-
8 个赞 / 13 条回复
-
6 个赞 / 2 条回复
-
6 个赞 / 11 条回复
-
5 个赞 / 2 条回复
-
软件测试行业的新规则:技术越来越先进,为什么有些测试人员反而越来越不值钱了? at 2026年10月29日
我是看出来了,第一你是真闲,能写这么多。第二你这套理论受众也确实多,都比较同意 “软件测试不是一场永远追逐新工具的竞赛,也不是一场用技术给同行排座次的游戏。”,也就是说明了真的有很多人被新工具伤害到了。
我也被伤害过,但是我运气好,挺过来了。
AI 的发展特别快,包括你举的例子:
“他问了几个问题。
第一,系统推荐执行的测试,依据是什么?如果需求本身存在遗漏,或者变更影响分析不完整,系统如何发现那些没有被识别出来的风险?
第二,AI 可以调整自动化操作,但它调整之后,如何证明测试仍然验证着原来的业务规则,而不是为了完成任务,绕开了原本应该检查的条件?
第三,发布页面上的质量结论,是建立在完整、可信的验证证据上,还是只是把现有工具的执行结果汇总到了一起?”
我觉得都是一年前的困惑了,现在早就不是在研究这个了(甚至 deepseek 4.1pro 都已经突破这些问题了),大家还是要真的用起来 AI,来面对一些更有挑战的问题。
我更喜欢能实际落地的文章,这篇空谈太多,我自己不喜欢,耽误大家喜欢了,不好意思。 -
软件测试行业的新规则:技术越来越先进,为什么有些测试人员反而越来越不值钱了? at 2026年10月29日
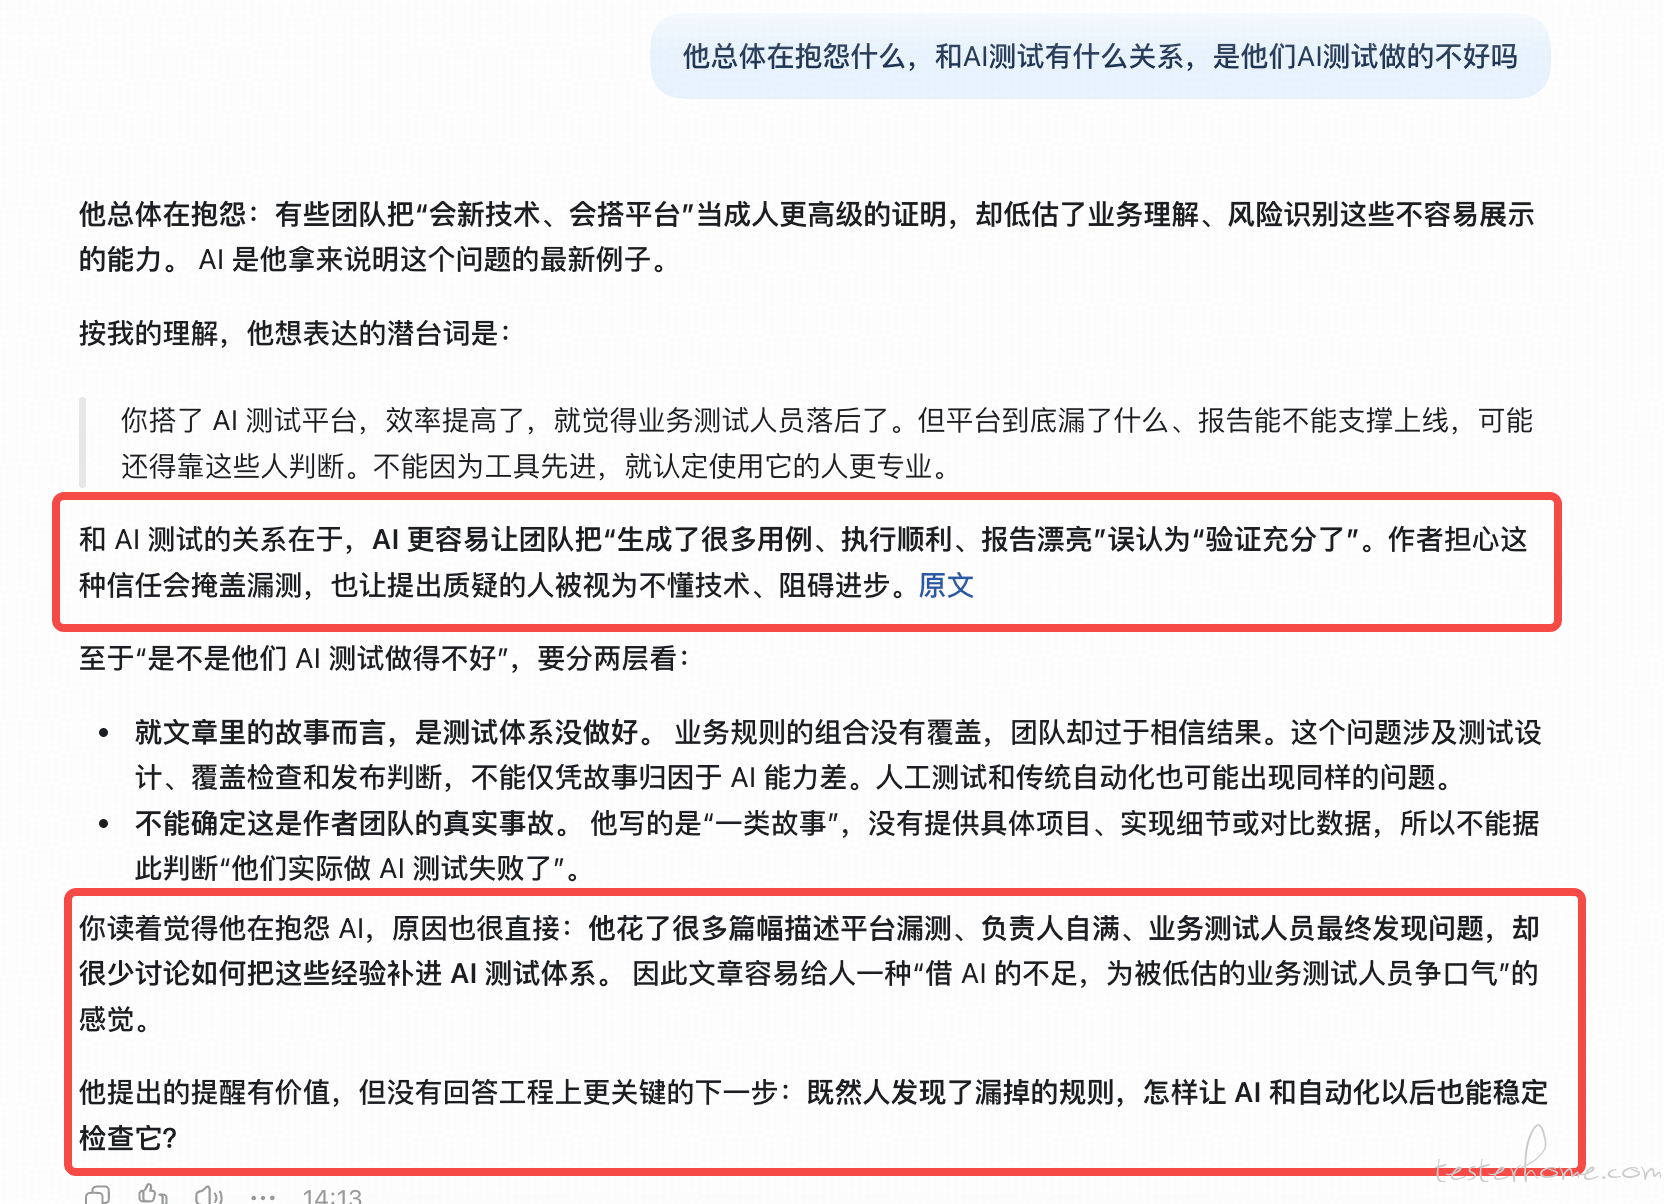
-
软件测试行业的新规则:技术越来越先进,为什么有些测试人员反而越来越不值钱了? at 2026年10月29日
评价一个事物好不好,是要看长期的量化结果,一个特例就开始否定了不是什么好习惯。
AI 时代,最值钱的不是代码了,而是 AI 的规则。
说了这么多,都是在说 AI 的结果不可信,这本质上是 AI 的规则不可信,是要优化规则,我觉得更有价值的是把之前 AI 规则差在哪里,发现问题之后 AI 规则怎么迭代的更好,你对规则的认识有了什么上升,而不是在这唱衰和抱怨。
没想到这么久了大家还没认识到这个。 -
测试技艺 | 在 AI 极速发展下重塑 at 2026年10月26日
这篇文章最核心的一句话是:AI 可以帮测试人员干活,但 “该测什么、怎样才算对、值不值得这样测”,仍然需要人判断。
- 作者一直想让机器自己完成测试,但每前进一步,都会发现新的困难。
他的经历大致是:
- 最开始用自动化工具操作界面,发现有些控件操作不了。
- 改成识别图片、模拟点击,能操作了,但界面稍微变化就容易失效,维护很累。
- 再尝试让 AI 自己探索操作,又遇到训练数据、计算资源和效果不稳定的问题。
- 后来用大模型生成测试脚本,发现模型会写错;为了提高可靠性,又需要人整理场景和规则。 这个故事要说明的是:生成或执行脚本只是测试的一部分,真正难的是让它持续、可靠地解决实际问题。 作者分享的是这一路的尝试和代价。
- 技术先进,不代表适合你的问题。
作者反复强调,要看实际场景、成本和质量目标。一个工具展示时很惊艳,放进自己的项目后,可能需要大量准备和维护,收益未必抵得过投入。原文
拿我们的情况举个例子——这是我的解释:
假设 AI 十分钟生成了 100 条自动化用例,但你还要花两天修数据、纠正预期、排查误报。那么 “十分钟生成 100 条” 这个数字,并不能说明效率提高了。
反过来,它只帮你写了 5 条,但准确覆盖一个经常出问题的支付流程,而且以后维护很省心,这就有实际价值。
所以作者关心的是:最后解决了什么问题,总共花了多少代价。
- AI 能操作、能写脚本,不等于它知道业务结果是否正确。
文章认为,测试仍然需要理解人的需求、建立评价标准,并判断系统有没有满足这些需求。这些工作不会因为工具升级就自动消失。原文
还是用支付举例:
商户发起一笔付款,接口返回成功,页面也显示成功。
到这里,机器已经能证明 “请求发出去了,页面有成功提示”。但你真正想知道的是:
- 钱有没有准确到账?
- 有没有多扣、多记一笔?
- 手续费对不对?
- 重复回调后会不会再入一次账? 操作走完了,与业务做对了,是两件事。
AI 可以帮助检查这些问题,但首先要有人把 “对” 的标准说清楚,并提供可信的判断依据。这就是测试人员仍然重要的地方。
- 对 AI 的宣传,要看证据,不能只看演示。
作者提醒,少量特定场景上的成功,不能直接证明换个项目也好用;要在自己的实际任务里评价效果。原文
这也不意味着必须搭一个复杂的盲测平台。我们刚才说的日常观察就能提供有用证据:
这次 AI 有没有漏关键场景?生成的用例能不能抓住错误?我纠正它花了多久?下次类似任务有没有改善?这些观察比 “它能自动生成多少代码” 更接近我们关心的价值。
文章后面还讨论 AI 将来能否理解个性化需求、能否生成没有缺陷的软件,那部分是作者的设想,没有给出确定答案。你不需要顺着那些宏大问题想下去;对现在的工作,最值得记住的就是:让 AI 承担更多执行工作,人把精力放在业务预期、风险判断和结果可信度上。
-
【求助】请教各位大佬一个困扰我很久的问题。 at 2026年10月22日
你这是比较低端的工作方式,甚至是没有岗位空间的,如果工作这么简单,那一个脚本就能做了,还要人干嘛。
会用 不等于 用好。 -
AI 测试:大家对齐下 at 2026年10月21日
说下我的最新进展吧,完全用 AI 做测试比之前预计的要累,QA 这个岗位不会消失,QA 是个力气活。
我验证的,仅 pc 浏览器功能的产品,是可以达到 AI 100% 覆盖的,所以大会上说的,5% 靠手测是完全可能的,并且和普通的理解不同,是 100%AI 都能覆盖,但是有 5% 的核心功能人类不放心所以要复查下,5%-10% 应该是这么来的。
但是这个 100% 的 AI 覆盖比想象中要累,原因是 AI 的质量标准太高了,举例吧,如果外包能设计出 20 条用例,正式最资深人能想到 50 条,那么 AI 能想到 100~150 条,会不会更多我还不知道,因为我在尝试并且 AI 大模型也在快速发展。
20 条用例耗时 1 天比如,如果 AI 测这 20 条确实洒洒水,一小时搞定了,但是要测 100~150 条的极其深入的测试,AI 的耗时也少不了,所以整体的测试耗时并没有下降太多,跟研发的开发时间仍然是一个合理的比例。
并且还有一个弊端,极其发散的用例,创造的场景和复现 bug、验证 bug 的深度也是非常恐怖的,研发可能改几遍也改不好,所以研发的能力,造数的能力等,都耗时很高。
所以回到最初的说法,QA 是个力气活,极端的质量仍然是明珠,很难摘的。
当然肯定有公司对质量是得过且过,甚至我都见过有些 QA 对自己的工作也是得过且过,那不在我上述范围内。
其实 QA 是一个靠运气吃饭的工作,就啥都不测、糖化,但是线上就不出问题事故,照样很稳……都是玄学。 -
34 岁运营转软件测试,是不是选择错了? at 2026年09月28日
QA 的生死线:QA 测试质量显著高于研发的自测。
如果达不到,基本就看命了,比如你亲哥是研发负责人,或者是你可以在极短的时间内比项目组的人更懂业务,提出更有价值的业务方向或者 bug。
靠自学迈过生死线的,现在连硕士、博士都找不到工作,你比他们学习能力更强吗?也不排除有,但是看你的问题描述没看出来。 -
你说你会 AI 测试,那你是怎么实现 AI+ 软件测试的呢?(附带 5 层 AI 质量管理体系) at 2026年09月28日
写了很多又撤回了,你能看到,有缘的话就私聊吧。不想动太多人的蛋糕。
-
AI 越来越强了,为什么测试人反而越来越累!(为打工人发声) at 2026年09月28日
测试不是例外啊,AI 对 QA 的提升是非常非常非常巨大的,从高质量到高效率都是巨大的提升,AI 不会让质量保障的水平降低,相反是提高到了一个非常高的水准。
真不知道业内为什么在说测试越来越忙,是反向宣传吗……也是,再宣传岗位都没有了。
再说需求多就累的事情,QA 确实有效率的上限,但是据我的估计,AI 加持下的 QA 的上限被打穿的话,真的是超负荷的在跑的话,每个月 AI token 的成本是非常高的,如果是国外的模型是肯定过 2 万人民币的(估计 40 亿 token+),国内的模型也得大几千,AI 的 token 额度都到了么就在这里喊打穿了……
并且 token 能花到 40 亿的 QA,我觉得都不会喊累,因为那真是乐在其中。 -
LLMCase-V4 从策划文档到测试用例 - 开篇 测试用例生成三问 at 2026年09月28日
这平台没什么大用甚至没用。
LLM 确实可以做生成用例的事情,但是不应该这么用。
看了后面的服务设计,从一开始 LLM 就不是这么用的, “屎上雕花” 的项目。
https://juejin.im/post/5e2159215188254e1c43a585
一个测试同学的,互帮互助。