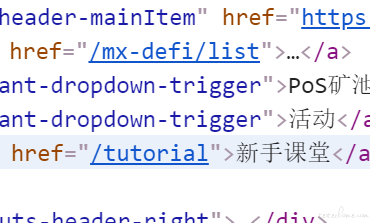
想写一个脚本,遍历带有域名的 url,检查状态码是否有异常。遇到一个问题,requests 返回的内容里面没有 a 标签。
网页的内容都在这个 div 里面,但是 requests 返回的数据里面为空
import requests
from bs4 import BeautifulSoup

headers = {
    "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.111 Safari/537.36",
}
resource_list = list()


def get_urls(url):
    r = requests.get(url)
    print(url)
    print(r.text)
    soup = BeautifulSoup(r.text, 'html.parser')
    urls = soup.find_all("a")
    if not urls:
        return
    if urls:
        for i in urls:
            try:
                if i['href'] not in resource_list:
                    status_code = requests.get(i['href']).status_code
                    if status_code not in (200, 0):  # code 不对则打印出来
                        print(i['href'], status_code)

                    if "https://www.mxc.ai/" in i['href']:  # 判断是否含有域名
                        resource_list.append(i['href'])
                        get_urls(i['href'])
            except Exception:
                pass