前言
六月初的时候老板找我沟通,希望我放下手中智能体产品的测试,投入到云产品团队的 Agent 沙箱产品中去。 老板说的很严肃,这个产品过去一直没有测试人员,也没有产品人员,一直都是开发团队内部闭环。 因为这是一个十分偏向底层的产品, 涉及到虚拟机和容器底层,要跟操作系统,文件系统,网络打交道。 开发团队那边总监几乎明说了担心测试团队的能力是否能 hold 住这里。 所以领导三令五申不能掉链子,并且那边开发团队有 20 人,而我只有一个人。 最多偶尔临时调一个应届生来顶一下。
事情大概就是这么个情况,好在几年前我一直是玩 docker 和 k8s 的,算是有底子,所以也不是很慌。于是在 6 月底正式进入 agent 沙箱团队, 到今天已经有 2 个月半。 我也把这两个月半里接触到的测试内容在这里分享出来。
什么是沙箱
相信各位都对 Agent 并不陌生,即便是非技术岗也或多或少的在用 AI 来提升自己的工作效率。大家可以使用 Agent 来编写代码, 处理数据,编辑文件等。但大家有没有想过,让 AI 来操作用户本地的文件和系统,其实是一件非常危险的事情。AI 万一抽个风就可以把你的系统改坏, 误删文件,又或者启动数个很消耗资源的任务把你的机器干爆。
基于以上原因,大多数任务是不能放在用户本地跑的。而是在远端服务器中,独立开辟一个小的的空间,专门运行用户的任务,任务结束后再返回给用户,这样才足够的安全。这个沙箱需要有足够的隔离性,运行在里面的任务不能操作服务器,也不能影响其他用户的沙箱(每个任务有独立的沙箱)。所以虚拟化方案就呼之欲出了。也就是说:沙箱,就是虚拟化产品(虚拟机和容器都属于虚拟化的范畴。)
虚拟机和容器各自的优缺点
沙箱需要满足的以下几个条件:
- 性能:沙箱的启动和销毁要达到毫秒级,看过我的《三万字长文讲解大模型性能测试》的同学应该还记得,TTFT(首 token 延时)是最重要的性能指标,直接影响用户的留存率。如果按照传统虚拟机方案,启动一下要十几秒甚至几十秒的(不仅仅是启动操作系统,还有系统上面的用户业务进程,磁盘挂载等),那么用户早就跑光了(毕竟首 token 要几十秒才返回,用户不会有这个耐心)。
- 安全(隔离):沙箱与沙箱之间隔离,互不影响,这个隔离要是内核级别的隔离,否则一个沙箱搞崩内核,整个机器包括其他沙箱全部报废。所以容器方案也不行(容器是不隔离内核的,它通过 linux namespace 机制来做逻辑隔离)
- 用户环境定制:每个用户的任务都有很多不同的环境依赖,如何让用户快速定制自己的环境依赖是一个很重要的问题。
所以虚拟机满足隔离性,但性能太差,而容器满足快速启动但没有内核级别的隔离。我们究竟要怎么做呢?
沙箱的一般技术方案
我用 AI 画了一张图如下:
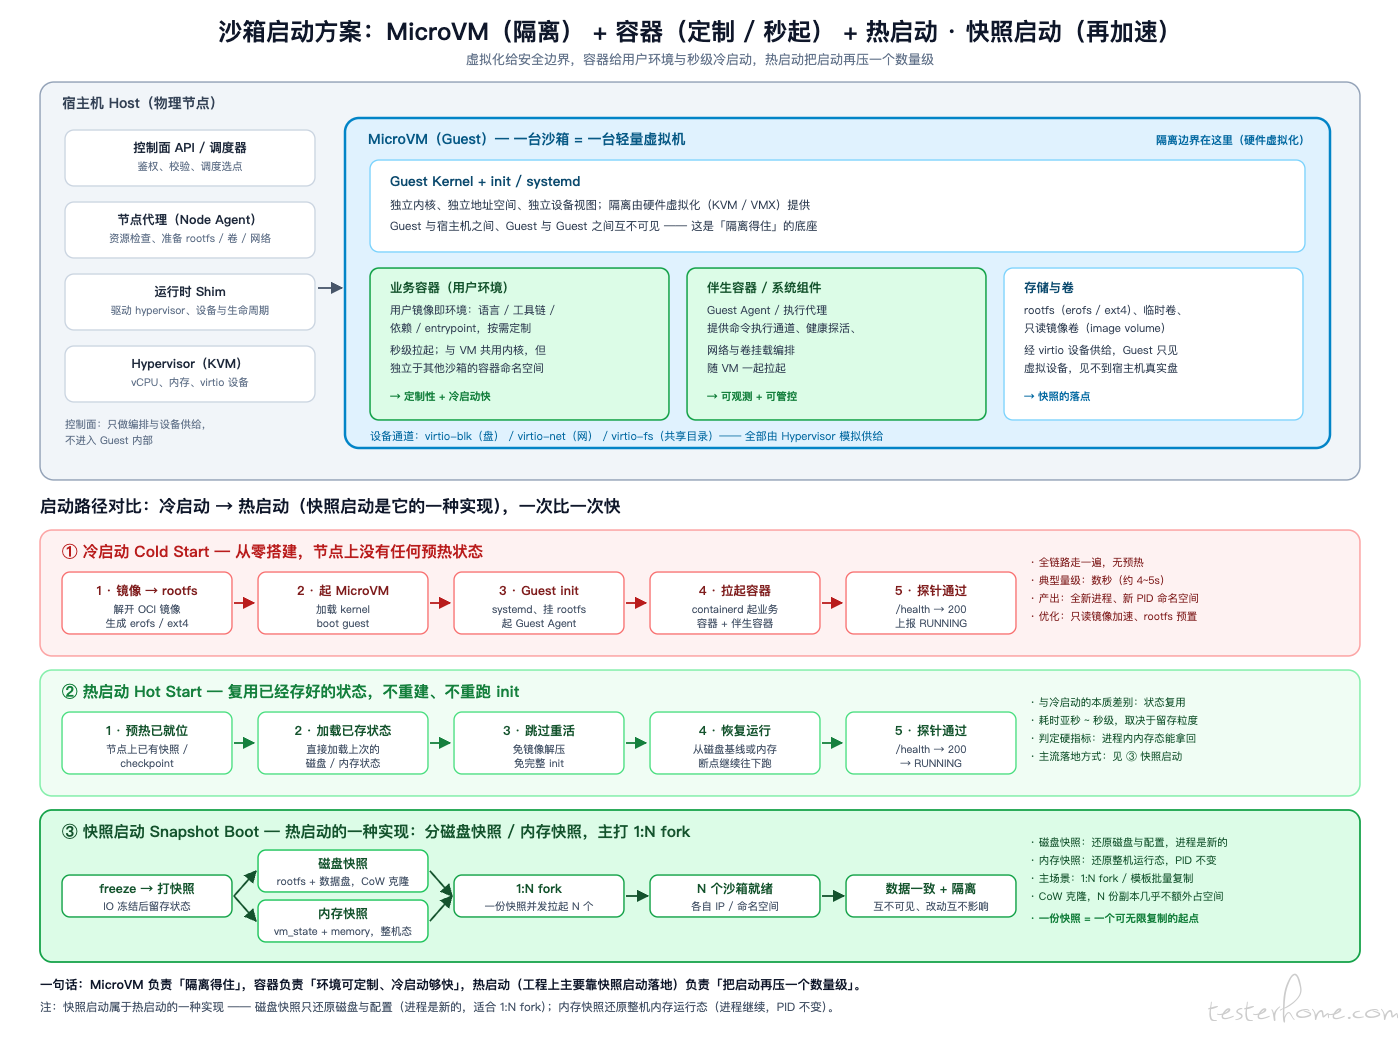
用一句话来总结: 虚拟机 + 容器 + 内存快照
- microvm:极轻量级的虚拟机方案,用来保证内核隔离。
- 容器(containerd):虚拟机内启动容器,用于定制用户的执行环境。通过 dockerfile 可以快速制作环境依赖。
- 快照:保存内存状态,包括 CPU 寄存器等,这个机制能保证把制作快照时的进程执行状态保存下来, 之后启动的时候就不用从 0 开始启动进程,保证毫秒级的沙箱重建过程。
冷启动/热启动/快照启动
- 冷启动:没有预先保存任何磁盘或者内存快照,一切从 0 开始启动,包括启动虚拟机,容器以及业务进程。启动速度是最慢的,可能动辄 10 几秒甚至几十秒
- 热启动:事先保存好了磁盘和进程的运行状态(内存),启动时直接利用快照恢复磁盘和内存。速度极快,一般在毫秒级别。毕竟避免了从 0 开始启动的过程。在 Agent 沙箱场景中广泛使用,尤其在沙箱的暂停和恢复场景中。
- 快照启动:也属于热启动的一种,算是一种特殊情况。 通常用于 1:N 的 fork 场景。就是用同一个快照去创建 N 个沙箱,通常在 Agent team 的场景中使用。(普通的热启动做不到恢复 N 个沙箱)
为什么沙箱需要暂停和恢复
一个用户可能同时需要 N 个沙箱,每个沙箱都处理不同的任务。 这是一个巨大的资源开销,大家想这样一个场景,当你跟模型对话了几轮后可能就停下来去做别的了,这时你很可能要很久之后才会再回来继续对话甚至可能从此就不管了。 如果这个时候沙箱仍然处于运行状态,就是极大的资源浪费。所以产品一般会在用户停止对话的一段时间后就把沙箱回收掉。但这个时候问题来了, 如果你把沙箱回收掉了, 那之前执行过的任务,保存的文件,启动的进程,想要再一点点恢复回来,那就是相当耗时的(有的甚至就恢复不回来)。所以这时候产品往往不是简单的销毁沙箱,而是把沙箱 “暂停”,也就是打个快照后再销毁沙箱,这个快照保存了磁盘和内存的信息,用户重新唤起对话的时候,可以做到毫秒级的沙箱重建,也就是热启动的效率。
以上便是沙箱最重要的主流程了。沙箱属于虚拟化领域,没有 UI,几乎没有产品文档,只有 API 文档,团队中的人默认每个人都应该熟悉虚拟化技术。这就是底层产品的运作逻辑,不会有人给你详细讲解产品逻辑,因为如果要讲,那就相当于把整个 linux 虚拟化技术和操作系统,文件系统,网络等知识都给你讲一遍。这个根本不现实。这也是我常说的,对于技术型产品来说,技术就是它的产品逻辑,这是这类产品的硬性门槛。要讲解这个产品的测试体系比较困难,所以我打算通过下面几个实际的测试场景来展示一下做这个类型的产品测试,一般都在做什么。
举例几个主要的测试场景。
制作快照 -- 冻结 IO
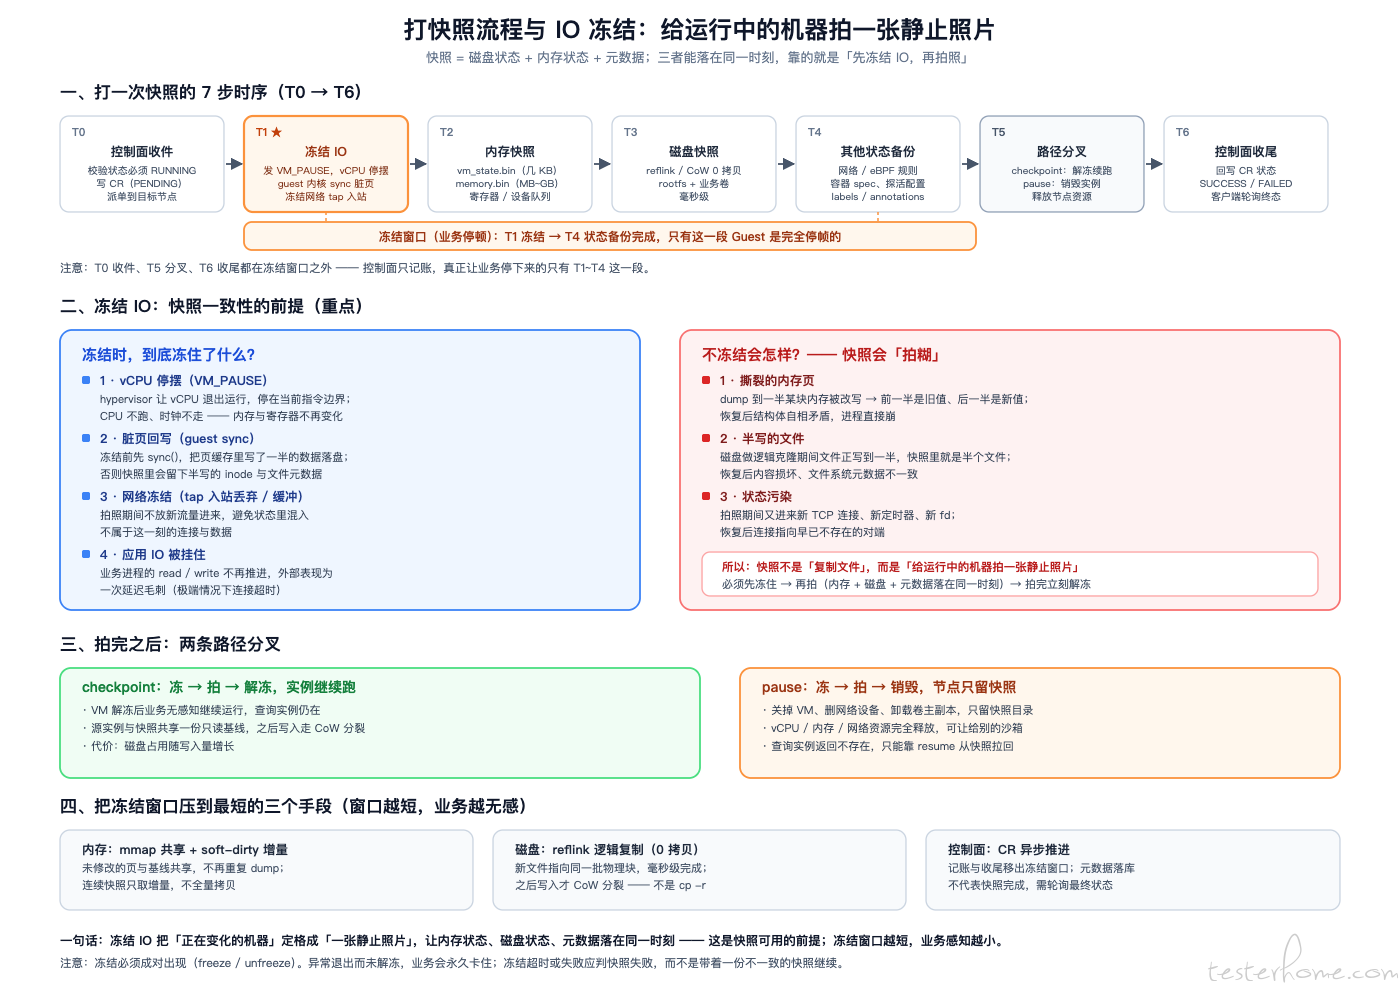
上图是一个制作快照的示意流程图,我们关注在 IO 冻结这个事情,IO 冻结分为 vm 冻结和 cgroups 冻结,他们各有不同。但大家暂时可以不用了解细节。我们只需要知道,打快照的过程是需要把当前沙箱中的运行状态保存下来(包括内存和 CPU 寄存器),还需要把内存中的文件缓存(dirty page)sync 到磁盘中。所以 IO 冻结的过程中,需要保证把缓存都写入到磁盘里再打快照,否则就会丢数据。
这里需要解释一下这个机制,以防对 linux 文件系统不了解的同学看不懂。简单来说就是如果用户想要写一个文件,它不会直接操作内存,而是先把要写的东西先写进内存中(page cache),然后按一定策略(文件系统和内核相关参数)sync 到磁盘中。所以冻结 IO 后,第一步就是要先把缓存写到磁盘里。所以我们的第一个性能测试场景,就是需要测试在不同 dirty page 规模下(还没写入到文件中的缓存)的冻结 IO 速度。
我们先看使用 dd 模拟脏页(dirty page)的命令:
# 一次性写 1GB(bs=4M × count=250),数据只进 page cache
dd if=/dev/zero of=/data/test.bin bs=4M count=250 conv=notrunc

# 循环覆写,让脏页稳定在文件大小附近
nohup sh -c 'while true; do
  dd if=/dev/zero of=/data/test.bin bs=4M count=250 conv=notrunc
done' > /tmp/io.log 2>&1 &
这里需要注意的是:
- 别加 oflag=direct 或 conv=fsync,前者绕过 page cache 直接落盘,后者写完立刻刷掉,脏页攒不起来。 这跟使用传统的 dd 进行 IO 压力的场景不同。 传统 IO 压力目标是测试磁盘性能,所以一般都要加 oflag=direct ,但我们虽然也是在模拟 IO 压力,但目标是把脏页积攒到一定规模,必须走缓存这条路径。
- conv=notrunc 是关键:覆写同一个文件而不是重新截断,脏页量才能稳定在文件大小附近,不会越攒越多。 因为我们要测试不同规模下的性能,所以要保证写入缓存的大小是可以控制的,不能越写越大。
- 写完要等一会再测,脏页爬到目标值需要时间。所以这也是 conv=notrunc 这个参数的意义, 因为我们是不知道什么时候脏页写到正好我们期望的大小。
- 控制脏页上限的内核参数:vm.dirty_ratio,默认值 20,硬上限:脏页占可用内存的百分比,超了之后发起写的进程自己同步回写。 所以我们测试的时候要把它设置成合理值,否则怎么模拟都打不到我们希望的规模。其实还有一些其他参数,但影响不大。
如果要查看当前脏页规模:
# 容器视角(cgroup v1,字节)
awk '/^dirty/{d=$2} /^writeback/{w=$2} END{printf "dirty=%.1fMB writeback=%.1fMB\n", d/1048576, w/1048576}' /sys/fs/cgroup/memory/memory.stat
所以我们的测试流程是:
- 制作包含 dd 命令的镜像。
- 使用镜像启动沙箱,利用 dd 命令模拟 drity page 规模。
- 触发 IO 冻结,观察 IO 冻结的耗时。
经过我当时第一次的测试,发现 IO 冻结的效率很差,drity page 的规模越高,耗时越久。于是跟开发同学一起排查, 把 IO 冻结的方案从 vm freeze 改成 cgroups freeze,这两个的区别简单说就是 vm freeze 在 io 冻结的一瞬间会等待已经发起 io 的系统调用的返回,而 cgroups 不会等。所以 cgroups freeze 会更快。但调整过后,大概在 2G 这个规模的时候, 时间也来到了 30s,性能依然很差。 这个时候我开始怀疑 dirty page 写入到磁盘的这个过程是否有问题。 虽然我们曾经测试过磁盘的基本读写性能, 但那是对磁盘的基础性能测试,而没有在沙箱中进行 IO 读写测试。于是我再沙箱中安装 fio 命令,在沙箱中进行了一次 IO 写性能测试。结果发现顺序写的性能只有 150M/s。 跟负责存储那边的开发同学沟通,才发现沙箱场景中他们给开了 IO 限频,避免少量沙箱就打爆存储 IO。所以又跑去跟沙箱/存储/客户进行沟通,要提供动态修改限频的功能,如果用户有大量 IO 的场景,可以根据需要给沙箱放开限频。
以上是这个场景的相关测试介绍,下面我们再看另一个。
制作快照 -- FD 规模
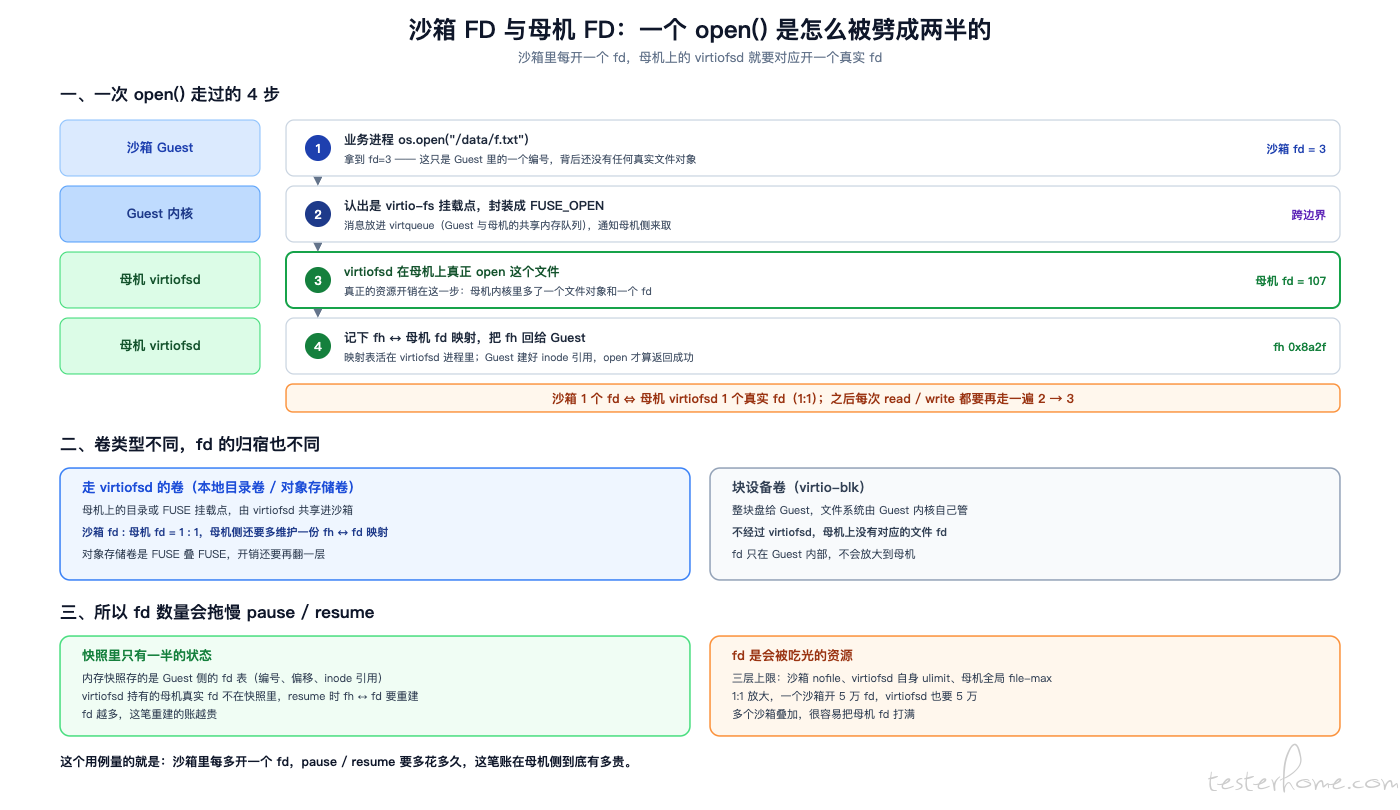
要解释这个场景,就要说一下虚拟化技术的一些底层原理。 我们都知道在 linux 中打开一个文件后会获得一个 fd(文件描述符),我们通过 fd 来对文件进行操作。但在虚拟机中,文件系统是虚拟化出来的, 所以实际上在虚拟机里拿到的 fd 不是真的 fd。 在虚拟机与宿主机(母机)中间有一个进程叫 virtiofsd,它会负责维护一张表,表中保存的是虚拟机打开的 fd 中对应宿主机真实 fd 的映射关系。
也就是虚拟机中拿到的 fd 是假的,之所以能正常工作是因为宿主机上的 virtiofsd 把它转换成了真实的 fd 进行操作。 真实的流程是: 虚拟机中系统调用(操作 io)→ Guest VFS(虚拟集中的虚拟文件系统)→ virtio-fs 驱动(封装成 FUSE 消息)→ virtqueue(与宿主机通信的核心,也是虚拟化技术的核心) → virtiofsd(转换成真实的 fd)→ 宿主机 VFS → 真实文件系统 → 真实 fd 操作
所以基于这个核心流程我们需要测试两个场景:
- 沙箱的跨机恢复:沙箱在机器 A 中打了快照(要保存下来当前沙箱中已经打开的 FD),然后再机器 B 中进行重建,这是要测试在跨机恢复场景中,virtiofsd 的 fd 映射是否还能映射到真实的 fd 上了。会不会本机恢复 fd 没问题,但跨机就出了问题。
- 不同存储设备的恢复:本地磁盘,云盘,对象存储等不同存储设备的挂载,并打开了 fd 后,进行快照动作。 验证这些存储设备在沙箱重建场景中是否都没有问题。
- 不同 fd 规模下的快照和重建性能:既然我们知道了 virtiofsd 要维护这样一张表,那如果用户在不同的存储设备下打开了不同规模的 fd,各自的性能如何?这是我们需要测试的,事实上经过测试,由于 cosfs 本身的性能问题,在打开大量 fd 后,沙箱的快照和恢复时间很长,后面甚至直接出现失败的情况。
镜像加速
要解释这个特性也有点困难,看过我很早期的 docker 相关文章的同学应该还有印象,我单独讲过容器的文件系统,最最早期的联合文件系统方案再到后来的 overlayfs2 的方案,整个虚拟化技术也是一点点在演进的,这个要是从头讲太麻烦了,有兴趣的同学可以去翻我以前讲云原生,docker,k8s 的那些教程。所以当时也说过文件系统是分层的,走的是写时复制(cow,也是快照技术的核心之一)。而现在主流的方案又出现了一个新的只读文件系统:erofs。对于比容器技术中默认的 overlayfs2,erofs 的一些特点决定了它比 overlayfs 的性能更好,比如:
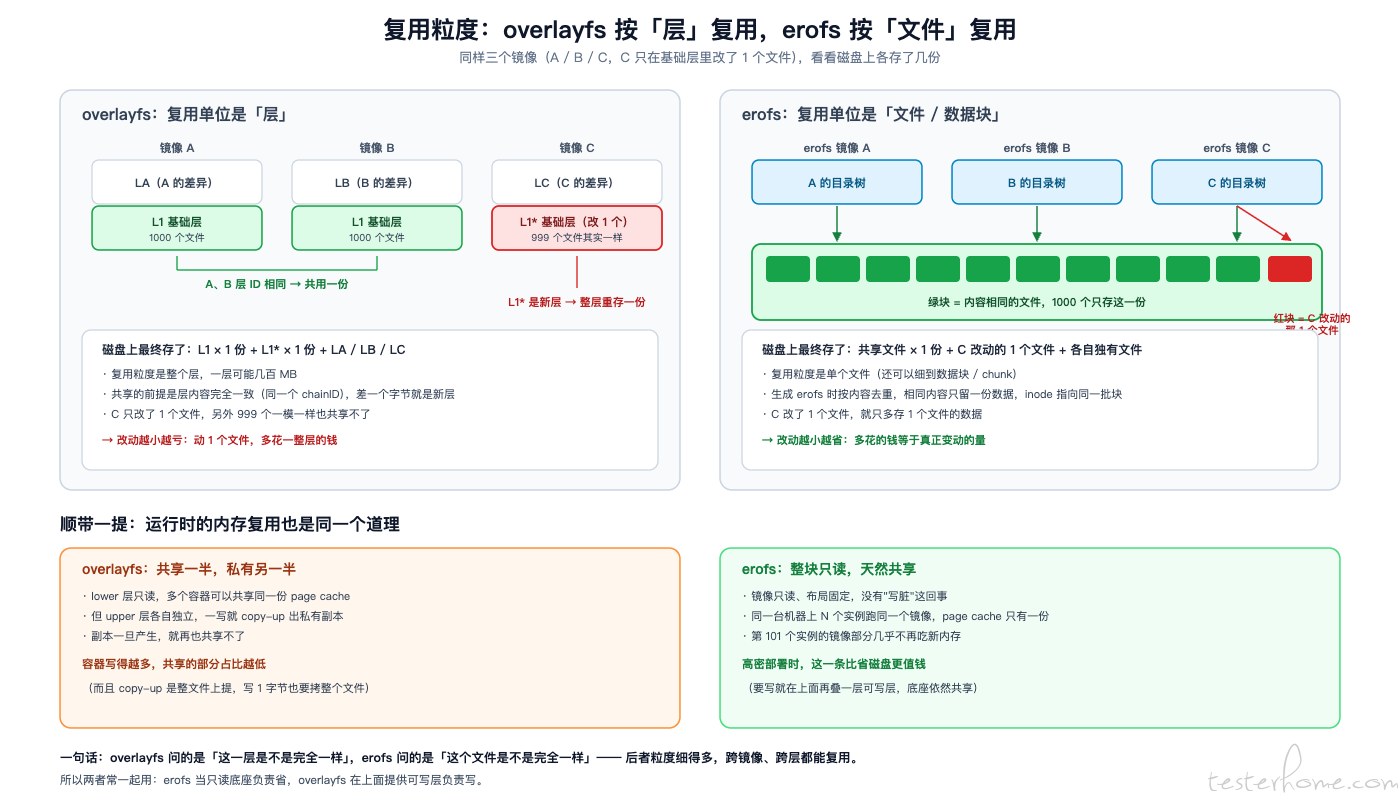
- erofs 是单层的:以前的文章中我也说过,容器技术中的文件系统,层数越多,io 损耗越大。
- erofs 是可以切片并复用的:基于 overlayfs 的容器是多层的,我以前讲过它也有复用机制,但它是以层为单位复用的。而 erofs 是单层,它可以把文件按块(block)进程切分。当多个镜像中有相同的文件的时间,就可以服用,节省磁盘开销。
同时针对镜像加速还会实现成按需读取,老的技术是先把远端的镜像完整的 pull 到本地,然后启动容器。而现在的镜像加速技术,可以做到先把镜像的元数据下载下来,然后就可以启动了。也就是说沙箱启动后,看到的文件都只有元数据,只有用户真的操作某个文件的时候, 才会到远端把文件下载下来。同时镜像还会做三道缓存:
- 本地缓存
- 远程缓存(内存)
- 远程硬件存储设备
所以我们在针对镜像做性能测试的时候,除了要测试不同的镜像体积外,还需要:
- 测试按需读取和本地读取的性能差距,尤其对比小文件和大文件的顺序读。毕竟虽然按需读取减少了镜像下载的时间(其实就是加速了沙箱的启动时间),但按需读取会不会因为网络和远程存储的性能问题导致 IO 性能过差。
- 走本地缓存的耗时, 远程缓存的耗时以及走硬件存储设备的耗时。
- oci 格式镜像(容器标准格式)转换成 erofs 的镜像加速过程的性能与稳定性
- 大规模启动沙箱时的性能,以及在 IO 读写过程中,给缓存服务注入设备,验证是否会因为缓存的故障导致 IO 错误。
其他场景介绍
上面三个测试场景都与性能和容灾有关, 我本来也想介绍介绍一些功能测试,但又不是那么好介绍的。 大家可以理解功能测试,就是在测虚拟机,测容器,测 k8s。测试人员要自己制作测试镜像, 用不同的参数和策略启动沙箱,验证这些参数和策略是生效的,比如启动沙箱带什么内核参数,网络策略,健康检查的策略,挂载不同的文件存储。
比较麻烦的就是有两点:
- 虚拟化技术被认为是通用技术,产品上不会有专门的文档介绍业务逻辑。
- 抛开产品本身,配合沙箱使用的不同的存储设备以及第三方服务也需要学习。
这里单独针对第二点举个例子,cosfs 是一个对象存储,沙箱可以挂载 cosfs 来完成用户对于存储的需求。 但 cosfs 本身的特性不了解清楚可能就会在沙箱运行时踩到坑。比如所有对象存储都是没有更新某个字段的功能的,对象存储要么创建全新的,要么整个对象进行更新。虽然 cosfs 可以用 FUSE 来模拟一个文件系统, 但它仍然没有这种能力,对它来说,所有东西都是对象。所以一般对象存储比如 cosfs,在挂载到容器或者沙箱(走 FUSE 形式)后,会有这样的行为:
- 文件顺序写:走分段传输,写操作不会立刻同步到远端,而是积攒到一定大小后(按配置,比如 8MB,16MB)分段传输到远端。
- 文件乱序写:由于不是顺序写,基于我上面讲到的特点,它没办法走分段传输更新到远端。所以写操作一般会在写到/tmp 里,等所有数据都写入到文件后,才整体更新到远端。
而我们的场景就出在乱序写上,由于只能写到/tmp 里而且没有限制写入大小。 所以沙箱中针对 cosfs 的乱序写,如果写的过大,就会打爆磁盘。而在 Agent 场景里,处理大数据也不是一个很罕见的场景,所以就会触发这样的问题。 而如果在测试中我们不懂这个原理,虽然会按一般测试理论去模拟写入大文件,但这时候是没有意识去专门乱序写的,不懂就很难覆盖到。
尾声
本来是想写个万字长文的,但最近工作比较忙,时间少。 我现在牙又疼的难受,实在写不下去了。。。。。 所以就先科普到这里。测试这类产品困难的地方,就是对这种技术领域的知识储备不足引起的。这些逻辑都不会写在产品文档里, 事实上可能产品文档就写了一句要对接 cosfs 存储,至于 cosfs 有什么特性,对接有什么坑,是不可能写在文档里的, 只能是测试人员自己对 cosfs 的学习和理解来兜底。同样的上面说的制作快照中,冻结 IO,FD 映射表,这些也不可能写在需求文档里,甚至也不在技术文档里。这些都是通用的虚拟化技术,默认团队中的每个人都是懂的。 对于技术型产品来说, 技术就是业务。 这也是我一直说的,技术对于测试人员的重要性,有了一定程度的技术水平,才能叩开对应工作岗位的大门。 最后再宣传下我得星球, 后续教程都会在星球更新: