AI测试 面对 AI 测试,你是主动接住,还是等着被"优化"?

2023 年我拍着胸脯说:AI 测试就是个噱头。 2024 年,我被自己打脸了。 2026 年,我开始用它换饭吃。
一、那通电话
上周三晚上十点,老张给我打电话。
他比我大三岁,做了十多年功能测试,在上一家公司算"业务活字典"——哪张表的哪个字段有坑,哪个页面在什么分辨率下会错位,他都门儿清。
电话里他停顿了两次,才把话说完整:
"我们公司上了 AI,测试这边优化了一半人。我也在名单里。你那边……有没有岗位介绍一下?"
我不知道该怎么接。
挂掉电话我翻了一下最近的招聘 JD。真实情况是:岗位没消失,消失的是"不需要懂 AI 也能干"的岗位。
几乎每一条测试岗 JD 里都有一句:
熟悉 AI 辅助测试、有 AI 生成用例 / 自动化落地经验者优先。
"优先"这两个字最要命。它不是门槛,它是排序。当 200 份简历里 60 个人写了"有 AI 自动化落地经验",剩下 140 个人连被看见的机会都没有。
所以这篇文章不是来贩卖焦虑的。我想认真聊一件事:
面对 AI 测试,你是主动接住它,还是站在原地等它来决定你的去留?
这两件事的差别,不是态度问题,是两年后的收入问题。
二、2023 年,我坚信 AI 测试是噱头
2023 年,我试过市面上几乎所有的"AI 生成测试用例"。结论非常统一:
它生成的是"正确的废话"。
你给它一段需求,它给你:
- 打开登录页面
- 输入正确的用户名和密码
- 点击登录按钮
- 验证登录成功 这段话有什么问题?
没问题。也没有任何用。
因为真正难的部分它一个字都没碰:用户名从哪来?密码从哪来?"登录成功"是断言 URL、断言昵称、还是断言某个接口返回 200?失败的场景要不要造?弹窗挡住了按钮怎么办?
更致命的是定位器。它会一脸严肃地给你写:
page.get_by_text("提交").click()
而你打开页面发现:这页有三个"提交",两个是隐藏的,剩下那个是
那时候我的判断是:AI 测试 = PPT 测试。 演示效果拉满,落地全靠人肉填坑。
这个判断,对了一半。
错的那一半是:我以为"它现在不行"等于"它永远不行"。
三、第一次真香:我让 AI 帮我写关键字用例
我们当时的框架是关键字驱动,一条用例就是一段 JSON:
{
"keyword": "click",
"locator": {"type": "text", "value": "登录"},
"desc": "点击登录按钮"
}
逻辑不难,但极其枯燥。一条复杂用例 40 个步骤,敲一遍 40 分钟,敲错一个字段名跑不起来,报错还特别难看。
于是我干了件事:把关键字框架的说明文档、目标页面的静态 HTML、再加一份写得好的历史用例,一起喂给 Qoder CN,让它按 JSON 格式吐用例。
我当时的提示词大概长这样
"""
你是自动化测试工程师。下面是关键字框架支持的所有关键字:
[粘贴关键字文档]
下面是目标页面的 HTML 结构:
[上传 HTML]
下面是一条合格的用例范例,请模仿它的写法:
[粘贴历史用例]
现在请根据需求"新增一条订单并提交",输出 JSON 用例数组。
"""
第一次跑通,我盯着屏幕愣了十几秒。
40 分钟变成了 3 分钟。
但这次我没有立刻怀疑它,因为有几个细节和以前完全不一样:
第一,它真的能看见页面。
Qoder CN 支持直接上传静态 HTML。也就是说,它不是在"根据经验猜一个网页长什么样",它是真的在读你给它的那个页面。它指着 跟你说"我用这个属性定位",这个 belong 不是我告诉它的,是它从 HTML 里读出来的。
这是质变。 我 2023 年判断"AI 测试是噱头",最大的依据就是"定位器全靠编"。这一条,被推翻了。
第二,它守格式。
我把关键字文档一起喂进去,它输出的字段名、嵌套层级、枚举值,基本不用改。以前最烦的"手滑打错 locator 还是 locators",直接消失。
第三,它给的是结构,不是散文。
以前 AI 给我写"步骤 1、2、3、4",我还得人肉翻译成代码。现在它直接吐一段能塞进框架的结构体。
那两周我的真实体感是:
写用例这件事,从"敲键盘"变成了"描述需求"。
一条 40 步的用例,从 40 分钟压到 5–8 分钟(含人工检查)。一天下来多出来的不只是时间,是意愿——以前看到一条边界场景,我会想一下"值得写吗",因为成本高;后来顺手就写了。
这个变化很小,但它其实很关键:
它把"写自动化"的门槛,从"会不会",降到了"愿不愿意"。
那年我们组的用例数涨了将近 3 倍。不是团队突然变强了,是成本结构变了。
四、甜头只甜了一次:我成了 AI 的人工 I/O
甜头是真的。但我很快发现,它只甜在"我一个人、一条用例、一次性"的场景里。
一旦乘上"团队 × 数量 × 时间",甜头就被吃干净了。
我认真记了一周的账,看看这 6 小时到底花在哪:
我在干的事 时间占比
打开页面、登录、点进目标页、另存 HTML(弹窗要单独存一遍)35%
把关键字文档、规范、范例重新粘一遍 15%
把生成的 JSON 贴回框架、调格式、跑一遍 25%
报错了,把错误信息复制回去再问一遍 20%
真正在思考"这条用例该验什么" 5%
只有 5% 是值钱的。
剩下 95%,我在干一件事:
当 AI 的人工 I/O 设备。
而且是极其低质量的那种。我手动保存的 HTML 只能覆盖我眼前那一屏 —— 弹窗里的字段、Tab 切换后的内容、换个角色才出现的按钮,全都不在。于是"它看得见页面"这件事,就退化成了"它只看得见我想给它看的那一屏"。
它推得越认真,错得越远。 因为它有依据,而依据是残缺的。
更麻烦的是三件事,靠"我勤快一点"根本解决不了:
一、经验不能沉淀。 我调好的提示词在我脑子里、在我的记事本里。换一个人,从零开始。团队 8 个人,就是 8 套土办法。
二、质量不能度量。 这个月生成了 200 条脚本,多少能一次跑通?多少改了两处才跑通?多少是"跑过了但其实什么都没验"的假绿?我一个数字都说不出来。没有数字,就没有改进方向。
三、一致性不能保证。 同一个人隔一周写的两条用例风格都可能不一样。100 条用例 100 种写法,三个月后维护的时候你会想辞职。
所以我停下来问了自己一个问题:
我到底是在"用 AI",还是在"给 AI 打下手"?
这个答案一旦想清楚,后面的事就顺出来了。
如果这五件事能交给机器——打开页面、准备上下文、跑一遍、看报错、记经验——那我需要的就不是"更勤快",而是一条流水线。
于是我开始把这个手工活,从"我的操作习惯",改造成"平台的固定流程"。
把这五件事变成五段产线
手工时代我干的事 产线里谁干 你拿到什么
打开页面、登录、进弹窗、另存 HTML 扫描器(带登录态,能进弹窗、能翻页) 拿到的是活页面,不是照片
贴关键字文档、贴规范、贴范例 Conftest 模板 + 断言关键字 + 技能库 上下文变成常量,不用每次重贴
贴回框架、改格式、跑一遍 生成即执行 生成完立刻知道能不能跑
复制报错、再问一遍 失败自动回收 → 自愈会话 有轮次上限地自己修,修不好就老实失败
记经验、写文档、口口相传 质量看板 + 定位器映射表 经验变成数据,不跟着人走
这就是 UI 自动化 这个模块的由来。它不是"又一个 AI 生成脚本的工具",它是把那 95% 的手工动作,拆成流水线的五个工位。
具体落到功能上,大概是这样几块:
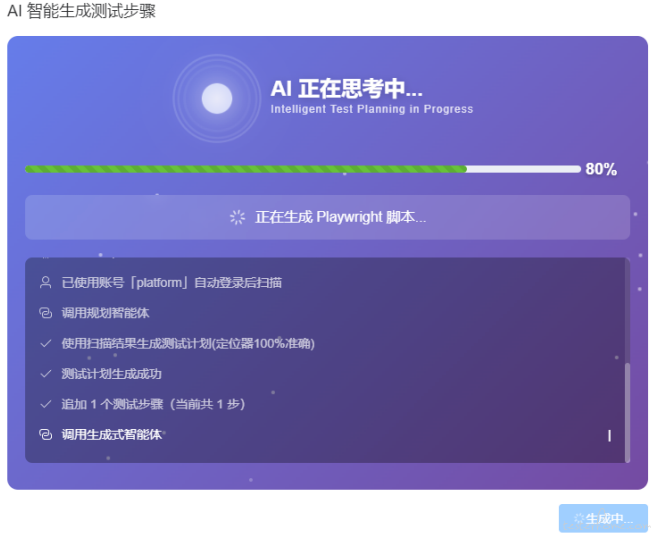
① 扫描与缓存——让"看见"变成可复用的资产
同一个页面,扫一次就够了。缓存不是简单存个文件,它按 项目 / URL / 是否登录 / 登录账号角色 / 本次扫描范围 分别隔离。
这条"账号维度"是我踩了大坑才加的:不隔离的话,A 角色扫出来的页面,会被拿去给 B 角色生成脚本 —— 而 B 打开同一个 URL 看到的是 403 拦截页。于是生成出来的东西全是拦截页上的元素,看起来有依据,一跑全错。
缓存还有"硬过期"和"软过期"两层:到点就删;而命中但已经放得有点久的缓存,会强制重扫一次再交给模型 —— 不让过期的事实去污染生成。
② 定位器映射表——生成之前先立规矩
生成的脚本,里面每一个定位器,都必须能在这次扫描的映射表里找到出处。找不到的,直接拦下来,不许进执行环节。
这一道闸门的价值,比后面所有的自动修复加起来都大。因为它把"AI 写得对不对"这个模糊问题,变成了一道可以判定的题。
③ 规划与生成拆成两个角色
先规划步骤,再写代码。规划那一步就把定位器和页面元素对齐一遍,写代码那一步只负责按模板落成脚本。
别让它一边想业务一边想语法。 两件事挤在一个回合里,它一定顾此失彼。
④ 断言不许自由发挥
断言必须调用平台预置的断言关键字,不许自己拼。
这一条一开始我很抗拒,觉得限制了 AI 的能力。后来发现恰恰相反:它是防"假绿"的核心。 模型最擅长的不是验证,是"写出看起来在验证的代码"。你给它自由,它就会给你 assert "成功" in page.content() 这种漂亮但毫无意义的东西。
⑤ 自愈:挂了得自己看见
执行失败不回滚成"你要不要重跑一下",而是自动把日志、截图、失败步骤收回去,改脚本、再跑。有轮次上限,救不回来就明确失败。
这里有个原则我一直坚持:自愈可以救不回来,但不许装成功。 假绿比红灯可怕一百倍。
⑥ 看得见它在点哪
浏览器跑在容器里,你可以实时看到画面:它在哪个元素上卡住、点完之后页面变成了什么样。
这解决的是心理障碍。以前 AI 生成的脚本一挂,我第一反应是"这什么鬼";现在我能看着它挂,然后知道是页面变了,还是它理解错了。这两种情况的处理方式完全不同。
⑦ 质量看板:把"玄学"变成四个数字
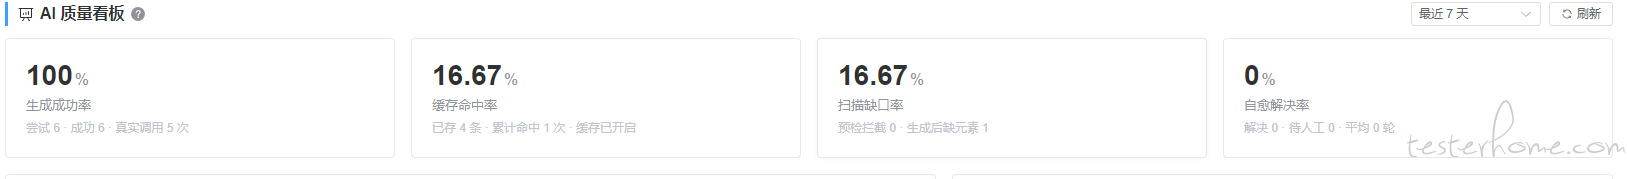
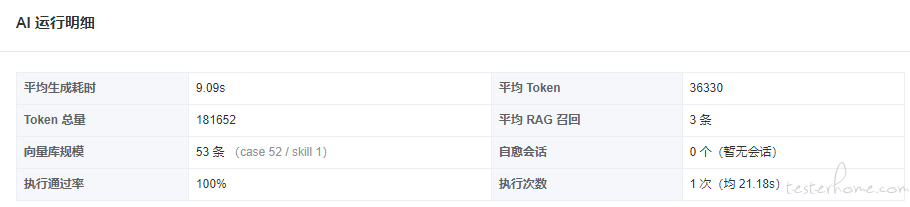
平台原来只有一个通过率,它能说明用例挂没挂,但回答不了真正该问的问题。所以后来补了四个:
生成靠不靠谱 —— 成功率、缓存命中率、平均耗时/token
为什么生成不出来 —— 拦截率、缺元素率、以及最常扫不到的 Top 元素
自愈到底救回多少 —— 解决率、平均迭代轮次
RAG 有没有在起作用 —— 召回条数、向量库规模
第三条尤其重要。自愈率低于某个水平,说明问题不在模型,在你的扫描覆盖率。 这个判断,靠感觉是永远得不出来的。
⑧ 技能库:好写法不跟着人走
调好的写法沉淀下来,下次直接复用。团队里谁摸索出了对付某个组件的姿势,其他人不用重新踩一遍。
现在整个流程长这样:你在页面上写一句人话——
"用管理员账号登录,进入订单管理,筛选最近 7 天的数据,点开第一条待审核订单,在弹窗里把承运方改成 A 公司,保存,然后断言列表里这条订单的承运方是 A 公司。"
点一下生成。它会自己登录、自己进页面、自己扫出这一屏的真实元素、规划步骤、生成脚本、跑起来。
一个中等复杂度的用例(登录 → 列表 → 筛选 → 详情弹窗 → 表单 → 保存 → 断言),手写加调试两个小时;现在生成 20 来秒,人工校对 15 分钟。
但真正的差别不是这个数字。
真正的差别是:第一次跑通的正确率,从"基本不能跑",变成了"能跑,改一两处"。
这两句话之间隔的不是 3 倍效率,是"能不能进生产"。
所以我对"平台"这件事的理解也变了:
平台的价值,不在于它比 Qoder 聪明多少 —— 它聪明的地方是一样的,因为底层可以就是同一个模型。
平台的价值在于:它把"我"这个环节,从流程里去掉了。
前者叫"用工具",后者叫"运营一条产线"。
五、手写 vs 平台化 AI 生成:四个维度,不吹不黑
这一节我尽量诚实,包括 AI 输的地方。
维度 纯手写 Playwright 平台化 AI 生成
单条用例耗时 1.5–3 小时(含调试) 15–30 分钟(含人工校对)
100 条用例的边际成本 线性增长,人越多越快,也越贵 明显下降,首次成本高、复制成本低
页面改版后修复 逐个文件改选择器,靠 grep 找 重扫页面 + 更新元素映射,脚本模板不动
失败定位 看一行 stack trace 扫描快照 + 步骤规划 + 生成日志 + 执行截图,四段对齐;再看质量看板确认是偶发还是系统性缺口
新人独立产出 2–4 周 第一天能出脚本,第二周能改对脚本
复杂交互/非常规控件 人更强,稳定 仍需要人兜底,别指望它一次到位
- 效率:线性成本 vs 边际成本 手写自动化的成本是 用例数 × 复杂度,这是一条斜率恒定的直线。团队扩 3 个人,产出扩 3 倍,成本也扩 3 倍。
AI 生成的曲线不一样:第一次很贵(要建元素库、要调提示词、要定模板),之后每一条都趋近于"免费"。
但这里有个坑我必须点出来:如果你的页面天天改版,元素库天天过期,那这条曲线会重新塌回直线。 缓存和元素映射不是一劳永逸的,它是需要维护的资产。
- 可维护性:比"生成"重要十倍 很多人只关心"能不能生成",不关心"三个月后还能不能改"。这是致命的。
手写脚本的可维护性瓶颈是人的记忆:半年前那个 div.el-form-item:nth-child(3) input 是谁写的、为什么这么写、删了会怎样,没人知道。
AI 生成的可维护性瓶颈是一致性。如果它每次自由发挥,你的仓库里会出现 100 种写"输入框"的方式——那不是可维护,那是垃圾场。
所以我后来做的最重要的一件事,不是让模型更聪明,而是给它上镣铐:
生成的脚本必须走统一模板(登录、等待、断言、收尾,格式固定)
表单填写不许手写选择器,必须调用统一的表单解析入口
模板约束的价值,大于模型能力的提升。 这句话我越来越确信。
- 可观测性:AI 测试真正的分水岭 这是最容易被忽略、也最能区分"玩具"和"生产工具"的维度。
手写脚本挂了,你只需要回答一个问题:哪一行报错了。
AI 生成的脚本挂了,你必须回答三个问题:
它当时看到的是什么页面?(扫描快照)
它用了哪个元素、哪个定位器?(元素映射 + 生成日志)
它为什么决定这么写?(步骤规划记录)
如果这三个问题答不出来,你面对的就是一个黑盒。一个不能解释自己为什么错的测试工具,比没有工具更可怕,因为它会消耗你排查的时间,还给你假的安全感。
所以真正的门槛不是"生成",是留痕。每一次扫描、每一次规划、每一次生成、每一次执行失败,都要能回放。
- 学习成本:前置降低,后置抬高 这条最反直觉。
前置确实降低了:以前新人要学 Playwright 语法、元素等待、strict mode、iframe 切换、弹窗作用域,2–4 周才能独立写一条不掉链子的脚本。现在他第一天就能生成。
但后置抬高了:生成出来的脚本跑挂了,他得能改对。
而"改对"需要的知识,恰恰是原来那套:为什么这里要等、为什么 strict mode 报错、为什么 force 点击了但页面没反应。
AI 把"写"的门槛打下来了,把"判断"的门槛顶上去了。
所以我的结论很残忍:
AI 不会让你不用懂自动化,它只会让"不懂自动化的人"更快地暴露出来。
懂原理的人,用 AI 是放大器,10 倍产出; 不懂原理的人,用 AI 是复印机,把错误 10 倍复制。
六、Playwright Agent 踩过的五个坑(以及我是怎么爬出来的)
这一节是全文最实在的部分。不讲实现,只讲现象和解法——因为这些坑你用任何工具都会遇到,跟你用不用我的东西没关系。
坑 1:AI 看得见页面,但看见的是"快照"
现象:脚本里那个定位器,在快照里确实存在、也确实唯一。跑起来要么命中 3 个(列表循环渲染),要么根本不存在(权限差异),要么是隐藏的占位元素(Element UI 的隐藏 input)。
为什么:它不是编的,它是照着照片推的。而快照缺了三样东西:运行时状态、当前账号的权限、以及折叠在弹窗/二级页里的内容。
这里最危险的不是"编",是"有依据的编" —— 它比纯幻觉更难被发现,因为它能指着 HTML 说"你看,我这里是有的"。
解法:实时扫描 + 三重校验。
生成前:在真实浏览器里跑一遍,拿到的是活页面的元素,不是静态文件
生成中:只给当前步骤需要的元素子集,不给整页(对抗上下文漂移)
生成后:对脚本里每个定位器做一次存在性 + 唯一性静态校验,不通过就拦下来,不许进执行环节
这一步拦下的问题,比后面所有自动修复加起来都多。
坑 2:它会用"看起来对"的写法写等待
现象:满屏 time.sleep(3)。本机跑得挺好,进 CI 就开始飘,今天过明天挂。
为什么:因为 sleep 是"最不容易立即报错"的方案。模型天然倾向于选那个"当下不报错"的写法。
解法:在提示词层禁掉,在规则层改写。
提示词里明确"禁止固定等待,必须等待页面加载完成或元素可交互";再加一道后置规则,把残留的 sleep 全部改写成显式等待。
这条坑的本质是:AI 优化的目标常常是"别报错",而你要的目标是"别假过"。 这两个目标不是一回事。
坑 3:force=True 是个甜美的陷阱
现象:按钮明明可见,click() 报元素被遮挡。加上 force=True,不报了,世界清净了。
但有些组件,加了 force 之后点击"成功"了,页面一动不动。
为什么:force 跳过的是可交互性检查——它绕过了遮挡,也绕过了组件自身的挂载状态。某些基于 Vue 的组件,点击事件绑在外层容器上,你 force 点了一个还没真正就绪的子节点,浏览器认为"点到了",业务认为"没点"。
解法:区分"被遮挡"和"未就绪"。
只有当目标真的被别的元素挡住时才允许 force,并且必须配合"先滚动到可视区 + 等待可交互";导航类、菜单类元素禁止 force,一律走正常的语义点击。
更重要的是:点击之后必须有断言兜底。 点完不校验 URL 变化或关键元素出现,这个点击就等于没写——因为脚本会"假装成功"。
假绿比红灯可怕一百倍。
坑 4:把 AI 猜的跳转写成硬断言
现象:AI 觉得"点完应该跳到 /order/list",于是写了 URL 硬断言。实际上路由带了 query 参数,或者根本没跳转、只是切了个 tab。脚本忽过忽挂,查半天以为是环境问题。
为什么:模型把"合理推测"当成了"确定事实"。
解法:给断言分级。
需求里明确写了的、业务上确定的关键路径 → 硬断言,必须过
AI 自己推测的跳转 → 降级为软校验,超时只记警告不判失败
这条规则救了我无数个深夜。 断言不是越多越好,断言的准确率比覆盖率重要。
坑 5:上下文一长,它开始"忘事"
现象:一个多弹窗的长流程,生成到第 8 步,它把上一个弹窗的字段填到了当前弹窗里;或者凭空造出一个"所属容器",而这个容器在这个页面根本不存在。
为什么:上下文腐烂。长流程里塞进了整页几百个元素,信息密度被稀释,模型开始抓错重点。
解法:给每一步划定作用域。
把长流程拆成"步骤 → 容器(页面级还是弹窗级)",每一步只告诉模型"你现在在哪个容器里,你能用哪些元素",而不是把整页一次性倒给它。
顺带一个很多人会踩的衍生坑:扫描缓存必须带维度(上面提过一次,这里再说一次,因为它值得说两次)。缓存如果不区分账号/角色,就会出现"A 角色扫的页面,拿去给 B 角色生成脚本",而 B 打开这个页面看到的是 403 拦截页。于是生成出来的东西全是拦截页上的元素——看起来对,一跑全错。
七、最后说点扎心的
我一直觉得,"AI 会不会取代测试"这个问题问错了。
真正在发生的事是:
它把"会写脚本"这件事,从稀缺技能变成了基础能力。
十年前,会用 Selenium 是加分项; 五年前,会写 Page Object 是加分项; 现在,"能让 AI 生成一坨能跑的脚本"是加分项; 明年,这就是默认要求。
而每次技能从"加分"变成"默认",都会有一批人被筛掉。筛掉他们的不是 AI,是"这个技能我已经会了"这句话。
老张的问题不是不会 AI。他的问题是——他一直在等公司告诉他"我们上 AI 了,你去学一下",而不是自己在两年前就去试一次。
我 2023 年也判断错过,我说它是噱头。
但我和他唯一的区别是:我判断错了,但我还在动手。
判断错了不可怕,站着不动才可怕。