
从 Appium WebView 痛点到 OCR 驱动的自动化测试
一、问题背景:传统自动化方案的三大痛点
在接手微信 H5 自动化测试之初,我们沿用了业界常见的 Appium 方案,但很快踩到了三个难以绕过的坑:
-
痛点一:Appium 配置复杂。
Appium Server + Node.js + 各平台 Driver的环境链路长、依赖繁琐;Desired Capabilities 配置项多且易错,安装过程耗时耗力,环境一致性难以保证。 - 痛点二:WebView 切换困难。 操作微信 H5 必须先切换到 WebView Context,过程繁琐且不稳定;X5 内核调试模式开启麻烦,部分页面甚至无法切入,自动化频繁中断。
- 痛点三:元素定位不稳定。 H5 页面动态 class 名、无 id、Shadow DOM 等问题,导致 XPath / CSS 定位器非常脆弱,页面结构稍有变化即失效,维护成本极高。
uiautomator2
为了更轻量化地控制设备,我们引入了 ——一个基于 Python、深度封装 Google 官方 UI Automator 的 Android 自动化框架。
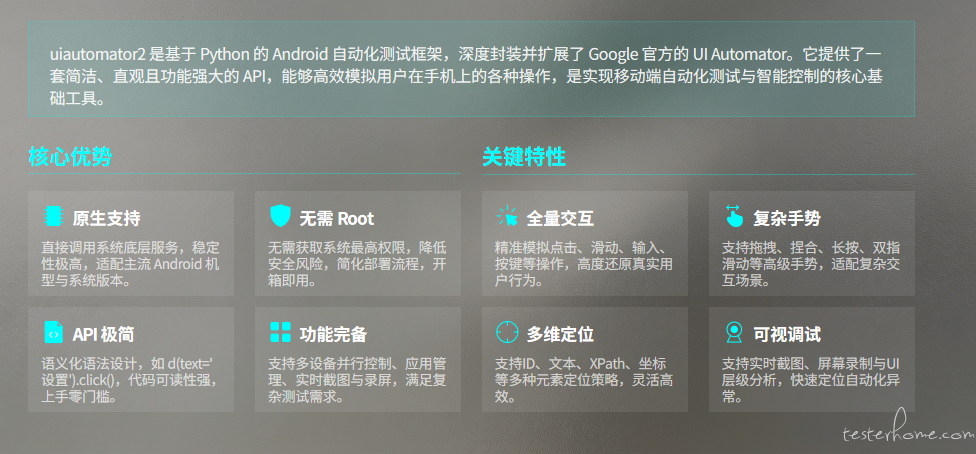
它的核心优势十分突出:原生支持系统底层服务、无需 Root、API 极简(如 d(text='设置').click())、功能完备(多设备并行、截图录屏、手势模拟、UI 层级分析)。
二、破局思路:放弃 DOM 定位,改用视觉识别
核心思想一句话概括:摒弃对 DOM 结构的依赖,模拟人类视觉交互逻辑。
通过 OCR 识别屏幕上的文本,精准计算目标位置坐标,直接驱动设备执行点击操作。这样做带来三个直接收益:
- 无需切换上下文——彻底告别 WebView 与原生层的切换困扰,脚本执行更流畅稳定;
- 全端技术兼容——无视前端实现技术,H5、原生 App、小程序,只要屏幕上有可见文本就能定位;
- 逻辑直观稳定——完全基于用户可见的文本定位,与用户操作逻辑一致;只要界面文案不变,脚本就始终有效。
整个执行闭环只有五步:
01 屏幕截图  →  02 OCR 识别  →  03 文本匹配  →  04 坐标计算  →  05 模拟点击
实时捕获当前画面   提取画面所有文本   检索目标关键词   定位目标中心点   执行设备触控操作
OCR 定位原理:从识别到点击
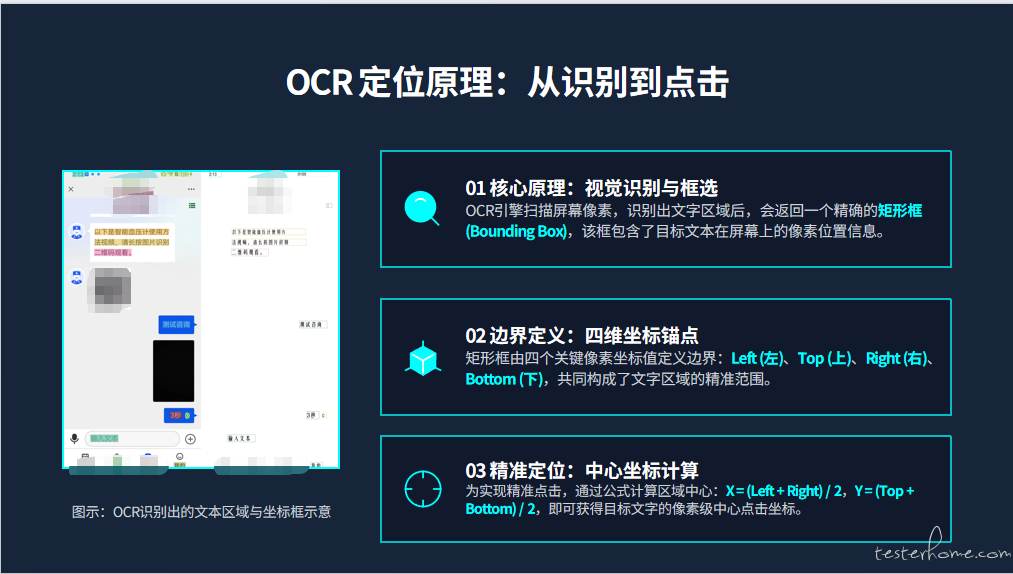
OCR 引擎扫描屏幕像素,识别出文字区域后会返回一个精确的矩形框(Bounding Box)。这个矩形框由四个关键坐标定义边界:
-
Left(左)、Top(上)、Right(右)、Bottom(下)
为了实现精准点击,只需计算区域中心:
X = (Left + Right) / 2
Y = (Top  + Bottom) / 2
得到的就是目标文字的像素级中心点击坐标。整个过程完全不关心页面是 H5 还是原生,也不关心 DOM 长什么样。
三、OCR 引擎选型对比
确定方向后,我们调研了四个主流开源 OCR 引擎。
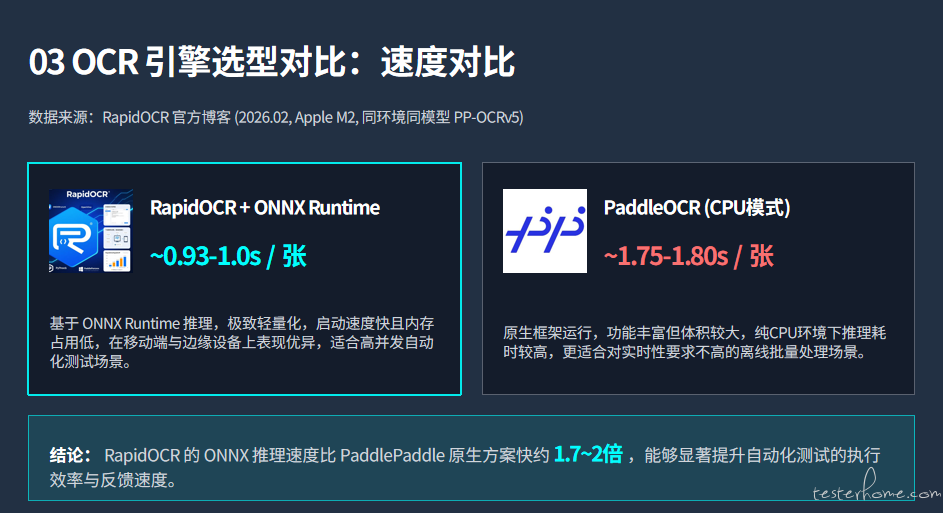
3.1 速度对比
-
RapidOCR + ONNX Runtime:约
0.93–1.0s / 张。基于 ONNX Runtime 推理,极致轻量化,启动速度快、内存占用低,在移动端与边缘设备表现优异。 PaddleOCR(CPU 模式):约
1.75–1.80s / 张。原生框架功能丰富但体积较大,纯 CPU 环境下推理耗时较高,更适合离线批量处理。极致性能: CPU 推理速度比原生 PaddleOCR 快 4–5 倍,单张图处理低至 0.21 秒;基于 PP-OCRv5,中文识别准确率达 98.7%。
轻量部署: 核心安装包仅 14.9MB,内存占用峰值约 500MB,支持 INT8 模型量化进一步压缩。
全平台覆盖: 支持 Windows、Linux、macOS、Android、iOS,提供 Python、C++、Java、C# 等多语言 API。
极简易用: 核心 OCR 功能仅需 3 行代码,集成门槛极低。
活跃社区: GitHub 超 7,500 Star,高频更新,每月 PyPI 下载超 330 万。
数据来源:官方数据
四、项目 OCR 实现方案
4.1 复用同一张图片坐标
可以把上一次识别信息存在self.results这个实例变量中,当is_ocr is False时就不调用识别接口,直接查询结果
# 是否重新识别 若是同一个页面没有布局变化时可不重新识别 True重新识别
if is_ocr:
    self.results = self.recognize_text()
4.2 非文本类目标定位策略及多机型定位
核心痛点:
1 文本类天然适配多机型
2 面对"+"号、语音键等无文本的纯图标按钮,传统 OCR 因为识别不到文字而失效。而且不同手机分辨率不一样导致其他机型不一定可以定位到。
非文本类多机型定位解法分两步:
- 定位锚点(Anchor)——用 OCR 识别图标附近的已知文本(例如输入框旁的"输入文本"),作为坐标基准锚点;
- 动态偏移(Offset)——以锚点中心为原点,按屏幕百分比计算像素偏移量,精准映射到目标图标位置。
实现(consult_chat_page.py):
# 定位锚点并计算偏移量
matches = self.ocr_service.find_text(text="输入文本", is_ocr=True)
x, y = (matches[0].center_x, matches[0].center_y)
self.click_with_offset(x, y, offset_x=0.63, offset_y=0)  # 向右偏移 63%
4.3 密码输入
核心痛点: 如 支付时手机截图或者录取视频是黑屏
坐标获取:adb shell settings put system pointer_location 1
点击密码时策略
- 划定动态范围——为每个数字键定义基于屏幕百分比的动态区域,摒弃单点坐标,消除机械点击特征;
- 随机坐标生成——在预设区间内实时随机生成点击坐标,模拟人手点击的微小偏差;
-
模拟操作间隔——点击后随机等待
0.15~0.6秒,复刻真人思考和操作的时间节奏。
核心实现:
def click_password_key(key):
    x1, x2, y1, y2 = KEY_AREAS[key]                 # 定义按键区域百分比
    x = random.randint(int(x1 * screen_w), int(x2 * screen_w))
    y = random.randint(int(y1 * screen_h), int(y2 * screen_h))
    device.click(x, y)
    time.sleep(random.uniform(0.15, 0.6))           # 随机延迟
五、其他手机系统框架
iautomator2 是 Android 平台专属的自动化框架
鸿蒙平台可调研 HMNextAuto https://github.com/ziguiway/hmnextauto
IOS 平台可调研 tidevice + facebook-wda https://github.com/openatx/facebook-wda