前言
上一次用 skill-up 为例分享了针对 skill 的评测工作。在与星球内的同学进行沟通的时候,大家针对这类开源工具的兴趣还是比较大的。 所以本次以 langfuse 为例,我们看看智能体评测的一般形式。
PS:其实我本身是不太推荐用开源工具的,因为如果评测做的深入,一定会引入一些自家产品的特点或者定制化需求,使用开源方案在后期可能就不会很便利。目前很多团队都选择自研平台的方式来满足自身的需求,以前不用自研是因为开发成本太高,但现在有了 AI 其实开发成本并不是很高了。
智能体的评测特点
虽然我们总说评测工作,但其实评测工作在面对不同的场景, 它的评测方法和指标都是不一样的。 比如:
- 传统 AI 模型:比如机器学习模型,计算机视觉,这些都是答案比较固定,非常容易做自动化评测的。
- 大模型(文字或者视觉生成):答案不固定,很多场景需主观评测。
- 智能体:不仅答案不固定,而且需要评测推理过程/token 消耗/链路轨迹
所以智能体的评测是比较麻烦的,它不仅要对最终结果负责,还要评估运行过程是否合规,这一点在上一篇 skill 评测的教程中已经讲解过了。
举个我自己踩过的例子。我得 UI 自动化的 Skill,输入一句「把登录 - 搜索 - 提交表单这条流程写成自动化用例」,它最后交回来一份能跑的测试代码,交付物完全正确。但打开执行记录会发现,它写完代码之后,根本没有跑最后那步测试。而我在 skill 里明确写了写完代码后,一定要运行测试。所以虽然最终交付物,也就是我们的测试脚本是没问题的,但它没有按照我的预想去运行的行为,也是缺陷。
同类的还有:
- 本来该查本地知识库,没查到,又去调了一次网络检索:多烧了一轮 token,多调用了一次工具。
- 工具参数写错了,报错重试三次,最后蒙对,结果对,但过程很脆,浪费了很多 token 和时间。
- 明明一步能完成,绕了五步,能跑,但成本翻倍。
所以智能体评测要同时看两样东西:最终交付物,以及中间那条调用链。
这也是为什么你需要一个能存 “调用链” 的工具,而 Langfuse 就是干这个的,它其实被人喜欢主要是因为可观测性,而不是它能帮你算什么指标,事实上它基本上算不了什么指标,大多数指标还是要用户自己定义,计算并上报。 它最大的优势是把整个调用的过程,在图形界面上展示给了用户。
Langfuse 是什么
- 一个 trace 存储与查看平台:每次调用记成一条树状记录,能看到每一步的输入、输出、耗时、token、报错
- 一个评分容器:你算出来的分数,通过
create_score()挂到 trace 或某个具体节点上 - 一个数据集 + 实验平台:数据集版本化,多次 run 并排对比
- 一套看板与告警:成本、延迟、质量分趋势,超阈值通知
它不是:
- 不是评测框架,不自带指标。具体的指标需要用户自己去计算,它主要负责 “可观测”
- 不是万能的自动化评分器。平台托管的 LLM-as-a-Judge 能用,但要配模型连接,而且它评的是单次的。 很多人其实会选择自己编写裁判模型并调用, 只是把结果上报到 langfuse 上。
这一点新人最容易误解:以为装上 Langfuse 就有评测能力了。实际上它给你的是观测和对比,指标本身仍然是用户的领域知识,并且需要用户自己来实现。
简单来说,它的主要功能是提供一套上报接口,让用户以前跑的评测脚本的结果上报到 langfuse 上,达到一个很容易观测的效果。毕竟对于智能体的评测来说,它不再是像以前那样面对结果进行评估,而是针对运行轨迹中的每一次思考过程,每一次工具调用都要纳入评估当中。所以提供一个便于观测运行轨迹的能力就是 langfuse 最主要的目标之一。
比如:
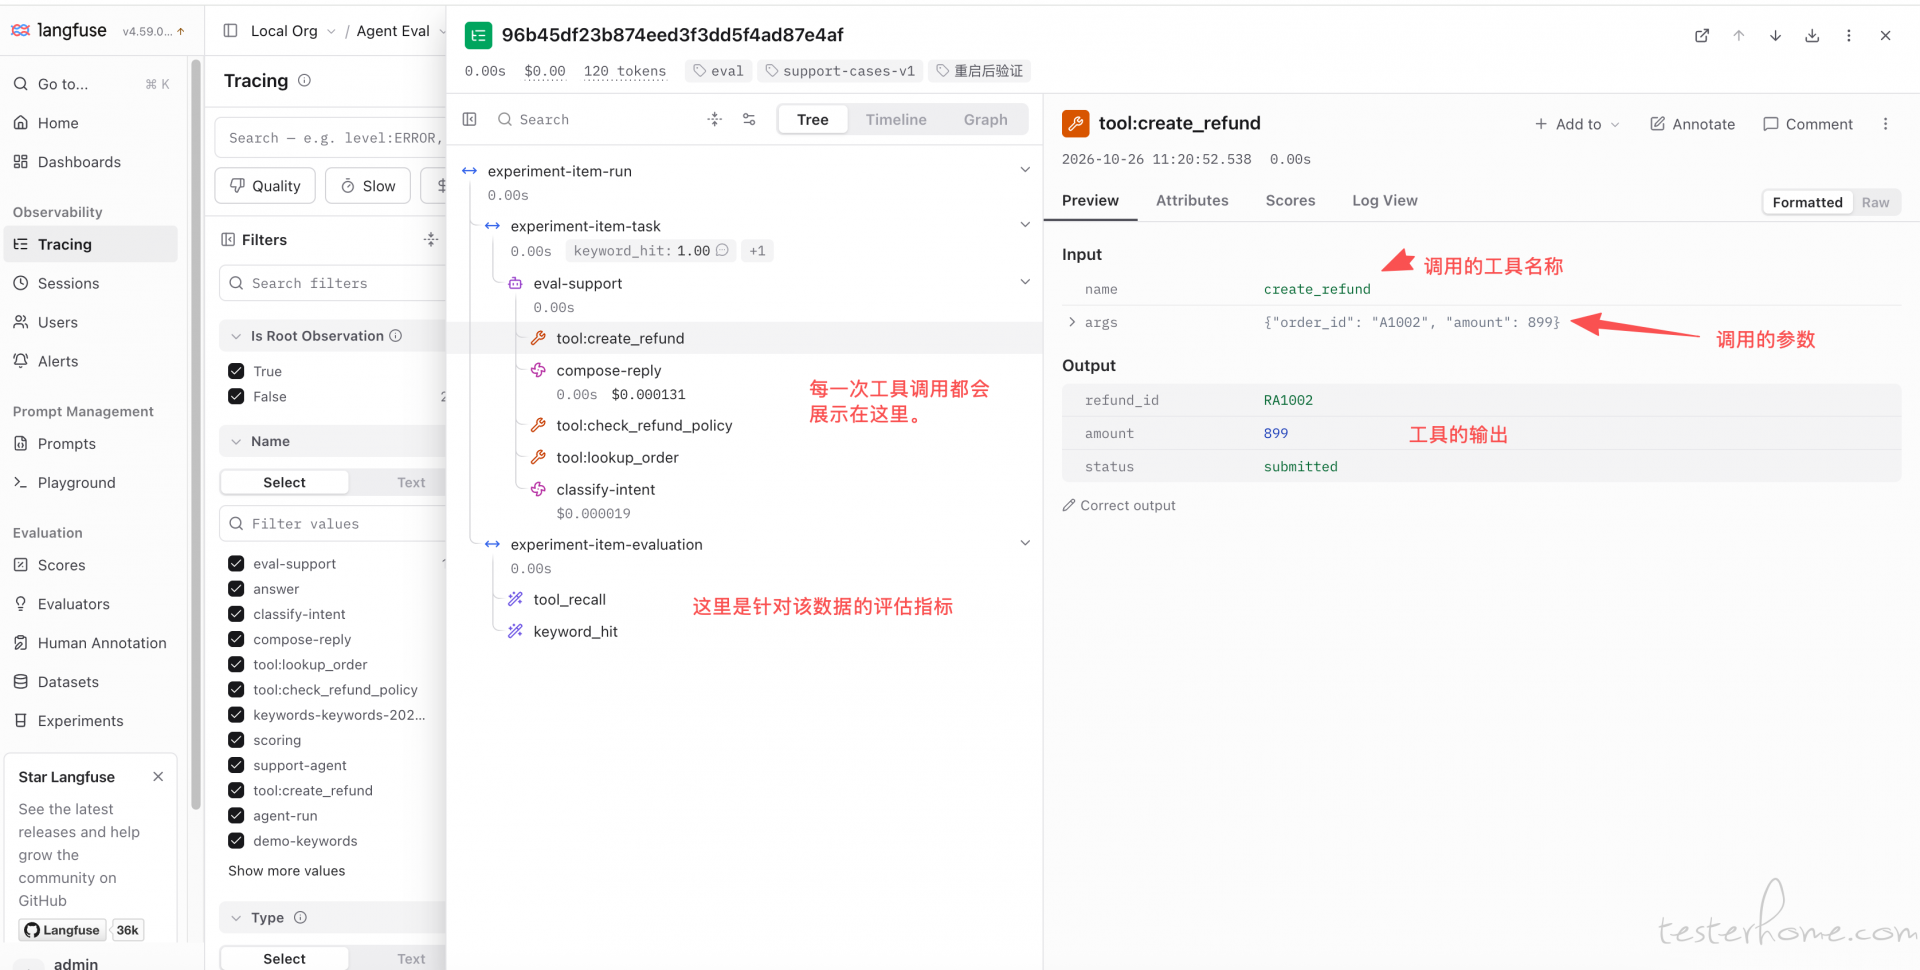
以上的调用链路和指标都是用脚本跑出来然后上报给 Langfuse 的。
部署:6 个容器
如果需要把 langfuse 部署在本地,我建议通过 docker 来部署。并且 Langfuse 不是单容器应用。最小可用要 6 个:
| 组件 | 作用 | 端口 |
|---|---|---|
langfuse-web |
UI + API | 3000 |
langfuse-worker |
异步消费事件、跑托管 Judge、导出 | 3030(内部) |
postgres |
事务数据(项目、数据集、prompt) | 127.0.0.1:5432 |
clickhouse |
观测数据(trace / observation / score) | 127.0.0.1:8123 |
redis |
缓存与队列 | 127.0.0.1:6379 |
minio |
S3 兼容对象存储(原始事件、附件) | 9090 / 9091 |
资源要求:4 核 8GB 起。
如何接入 Langfuse
Langfuse 的 SDK 就会默认把结果上报上去,在 UI 上呈现出来。 这个是比较简单的,但很明显,我们的实际工作中不会这么简单,如果我们要测试一个智能体。 那么要按下面的方式来。
如果我们要测一个 Agent
因为 Langfuse 主要提供一套上报接口,里面的各种模型调用和评测工作一般都是用户自己编写脚本完成的。所以我以我自己的情况为例。它的流程如下:
                        ┌─────────────────────────────────────────┐
① 你的脚本调用 agent ──▶ │  被测智能体(可能是函数 / HTTP / CLI)    │
                        └──────────────┬──────────────────────────┘
                                       │ 返回:答案 + 工具调用记录
                                       ▼
                        ┌─────────────────────────────────────────┐
② 规范化(不同的协议有不同的返回值,需要封装成langfuse sdk接受的格式)  │  {"answer": str, "tools": [...], "steps": n} │
                        └──────────────┬──────────────────────────┘
                     ┌─────────────────┴─────────────────┐
                     ▼                                   ▼
        ┌────────────────────────┐        ┌──────────────────────────────┐
③ 确定性评分(N 个指标)  │ 基于规则和脚本的评估:tool_recall / sequence │        │ LLM judge(裁判模型的评估:答案级 + 轨迹级)  │
        └────────────────────────┘        └──────────────────────────────┘
                     └─────────────────┬─────────────────┘
                                       ▼
                        ┌─────────────────────────────────────────┐
④ 写回 Langfuse          │  上报,在langfuse中显示调用链路和对应指标            │
                        └─────────────────────────────────────────┘
Langfuse 的一些概念:
| 概念 | 是什么 | 怎么产生 |
|---|---|---|
| Trace | 一次端到端调用,自带 user/session/tags 等属性 | 用户开的第一个 observation 会自动创建 |
| Observation | trace 里的一个节点,有 8 种类型(见下表),其实就是可观测项,有的是工具调用, 有的是大模型的调用,总体上就是给一次调用中的数据分个类,让用户能方便的看出模型都在做什么 |
start_as_current_observation / @observe
|
| Score | 挂在 trace 或 observation 上的分数(就是评估指标,这些指标通常是自动化的,也可以是人工标注完再上报的,但评测发展到现在,大部分场景都趋向于自动化评测方案了。) |
create_score / score_current_*
|
| Session | 多轮对话的归组(同一会话的多个 trace) | propagate_attributes(session_id=...) |
八种 observation 类型(as_type):
| 类型 | 用在 | UI 里的特殊能力 |
|---|---|---|
span |
通用步骤(默认) | 只有耗时 |
generation |
一次 LLM 调用 | model / token / cost / prompt 版本 |
embedding |
向量化调用 | token / cost |
agent |
一次 agent 运行(常用作根节点) | 标记为智能体执行 |
tool |
一次工具/函数调用 | 工具图标、按工具名统计 |
chain |
链路/编排 | — |
retriever |
检索(RAG) | 检索结果 |
evaluator / guardrail
|
评估器 / 安全护栏 | 评分与拦截记录 |
实际上,普通的智能体,一般就上报 generation,agent,tool。 毕竟 embedding 和 retriever 是只有知识问答场景才会有的东西。 这里也没有严格的要求, 用户根据自己的需要去上报就可以了。
接入流程
安装包
pip install "langfuse>=5,<6"
# 如果要接 OpenAI,另外装:pip install openai
拿到密钥
Langfuse UI → 左上角项目 → Settings → API Keys → Create,拿到:
LANGFUSE_PUBLIC_KEY = pk-lf-...
LANGFUSE_SECRET_KEY = sk-lf-...
LANGFUSE_HOST       = http://localhost:3000
写进环境变量(不要写进代码提交):
export LANGFUSE_PUBLIC_KEY=pk-lf-...
export LANGFUSE_SECRET_KEY=sk-lf-...
export LANGFUSE_HOST=http://localhost:3000
两种初始化方式
# 方式 A(推荐):环境变量驱动,进程内单例
from langfuse import get_client
langfuse = get_client()

# ... 上报数据的代码 ...

langfuse.flush()             # 必须:SDK 批量异步上报,退出前不 flush 会丢最后一批
langfuse.shutdown()

# 方式 B:显式传参
from langfuse import Langfuse
langfuse = Langfuse(
    public_key="pk-lf-...",
    secret_key="sk-lf-...",
    host="http://localhost:3000",
)

# ... 上报数据的代码 ...

langfuse.flush()             # 必须:SDK 批量异步上报,退出前不 flush 会丢最后一批
langfuse.shutdown()
一条 trace 的 Demo
# -*- coding: utf-8 -*-
"""Agent 评测最小接入模板(伪代码):跑一次 -> 埋点 -> 算指标 -> 上报分数。"""
from langfuse import get_client, propagate_attributes

langfuse = get_client()


# ---------- 1. 伪实现:模型 / 工具 ----------
def call_llm(prompt: str) -> tuple[str, dict]:
    return "已为你提交退款申请,1-3 个工作日到账", {
        "input_tokens": 120, "output_tokens": 20, "total_tokens": 140,
    }


def call_tool(name: str, args: dict) -> dict:
    return {"order_id": args.get("order_id"), "status": "未发货"}


# ---------- 2. 伪指标:换成你的规则或 judge ----------
def evaluate(output: dict, expected: dict) -> dict[str, float]:
    return {
        "tool_recall": 1.0 if set(expected["must_call"]) <= set(output["tools"]) else 0.0,
        "keyword_hit": 1.0 if expected["keyword"] in output["answer"] else 0.0,
        "token_budget": 1.0 if output["usage"]["total_tokens"] <= expected["max_tokens"] else 0.0,
    }


# ---------- 3. 跑一个 case,全程埋点 ----------
def run_case(question: str) -> dict:
    with propagate_attributes(user_id="u1", session_id="s1", trace_name="eval-demo"):
        with langfuse.start_as_current_observation(
            as_type="agent", name="support-agent", input={"question": question}
        ) as agent:
            # 模型调用 = generation(必须带 usage,否则没 token/成本)
            with langfuse.start_as_current_observation(
                as_type="generation", name="llm", model="demo-llm", input=question
            ) as gen:
                answer, usage = call_llm(question)
                gen.update(output=answer, usage_details=usage)

            # 工具调用 = tool
            with langfuse.start_as_current_observation(
                as_type="tool", name="lookup_order", input={"order_id": "A1002"}
            ) as tool:
                tool.update(output=call_tool("lookup_order", {"order_id": "A1002"}))

            agent.update(output=answer)
            return {
                "answer": answer,
                "usage": usage,
                "tools": ["lookup_order"],
                "trace_id": langfuse.get_current_trace_id(),   # 必须在 with 内取
            }


# ---------- 4. 跑 -> 打分 -> 上报 ----------
if __name__ == "__main__":
    output = run_case("订单 A1002 一直没发货,我要退款")
    scores = evaluate(output, {"must_call": ["lookup_order"], "keyword": "退款", "max_tokens": 200})

    for name, value in scores.items():
        langfuse.create_score(
            trace_id=output["trace_id"], name=name, value=value,
            data_type="NUMERIC", comment="demo",
        )

    langfuse.flush()
    print("trace_id:", output["trace_id"])
    print("scores  :", scores)
上面我写了一些伪代码, langfuse 的简化流程基本就这么多了。 可以看到,主要还是需要用户来编写评测的脚本,langfuse 只是提供了 sdk 来上报。
我自己常用的指标
tool_recall(工具召回率)
解释:必要工具是否被调用。
计算方式:数据集里会写明这条用例要求必须调用哪几个工具(必调工具清单)。数一下这次实际调用
覆盖了其中几个,覆盖数除以要求的总数就是得分。要求 3 个、实际调了 2 个,得分就是 0.67;
全调了就是 1.0。
tool_precision(工具精确率)
解释:实际调用的工具里,有多少是业务允许的。
计算方式:数实际调用里有多少落在允许范围内(必调 + 可选),除以总调用数。
调了 4 个、其中 3 个是允许的,得分 0.75。
no_redundant_calls(重复调用检查)
解释:有没有用相同参数重复调用同一个工具。
计算方式:把每次调用的"工具名 + 入参"当作一个签名,检查有没有完全相同的重复。
有重复判 0,没有判 1。同名但参数不同(比如换了订单号重新查)不算重复。
tool_sequence(调用顺序符合度)
解释:多步工具调用的先后顺序是否符合业务要求。
计算方式:把用例要求的调用顺序和实际顺序做比对,算"最长共同子序列"占要求序列的比例。要求 3 步、实际顺序完全一致就是 1.0;只对上前两步就是 0.67。中间多调了别的工具不影响,顺序错位才扣分。
max_steps(步数预算)
解释:完成任务的步数是否超出预算。
计算方式:被测 Agent 自己上报用了多少步(一次模型决策算一步,一次工具调用也算一步),拿它跟数据集里的步数上限比。不超得 1,超了得 0。
keyword_hit(关键词命中率)
解释:最终回答是否覆盖了要求出现的关键要素。
计算方式:数据集里配几个关键词,数最终回答覆盖了几个,覆盖比例就是得分。要求"退款""提交"两个词,回答里只有一个,得分 0.5。
not_empty(输出非空检查)
解释:Agent 是否产出了任何回答内容。
计算方式:最终回答去掉空白后是不是空的。非空得 1,空得 0。用来抓工程性问题(崩溃、超时、异常被吞导致没有输出),不评质量。它是兜底项,正常情况下应该永远是 1.0。
token_budget(Token 预算)
解释:单条用例消耗的 token 是否超出预算。
计算方式:把这条用例里所有模型调用消耗的 token 加起来(输入 + 输出),跟数据集里的 token 上限比。不超得 1,超了得 0。
cost_budget(费用预算)
解释:单条用例产生的费用是否超出预算。
计算方式:用输入、输出的 token 数分别乘以模型单价,得到这条用例的花费,再跟数据集里的金额上限比。不超得 1,超了得 0。
latency_budget(延迟预算)
解释:端到端耗时是否超出预算。
计算方式:拿被测 Agent 上报的耗时,跟数据集里的延迟上限比。不超得 1,超了得 0。
judge_correctness(答案正确性,通常是引入裁判模型来做自动化评测结果)
解释:回答在语义上是否满足用户诉求。通常引入裁判模型来做自动化评测,或者引入人工评估。
指标总结
就如我上面所说,Langfuse 是一个可观测平台,所以以上所有的指标都是用户自己按自己的需求来计算的,所以我这些指标都是我让 AI 生成的计算代码。 如下:
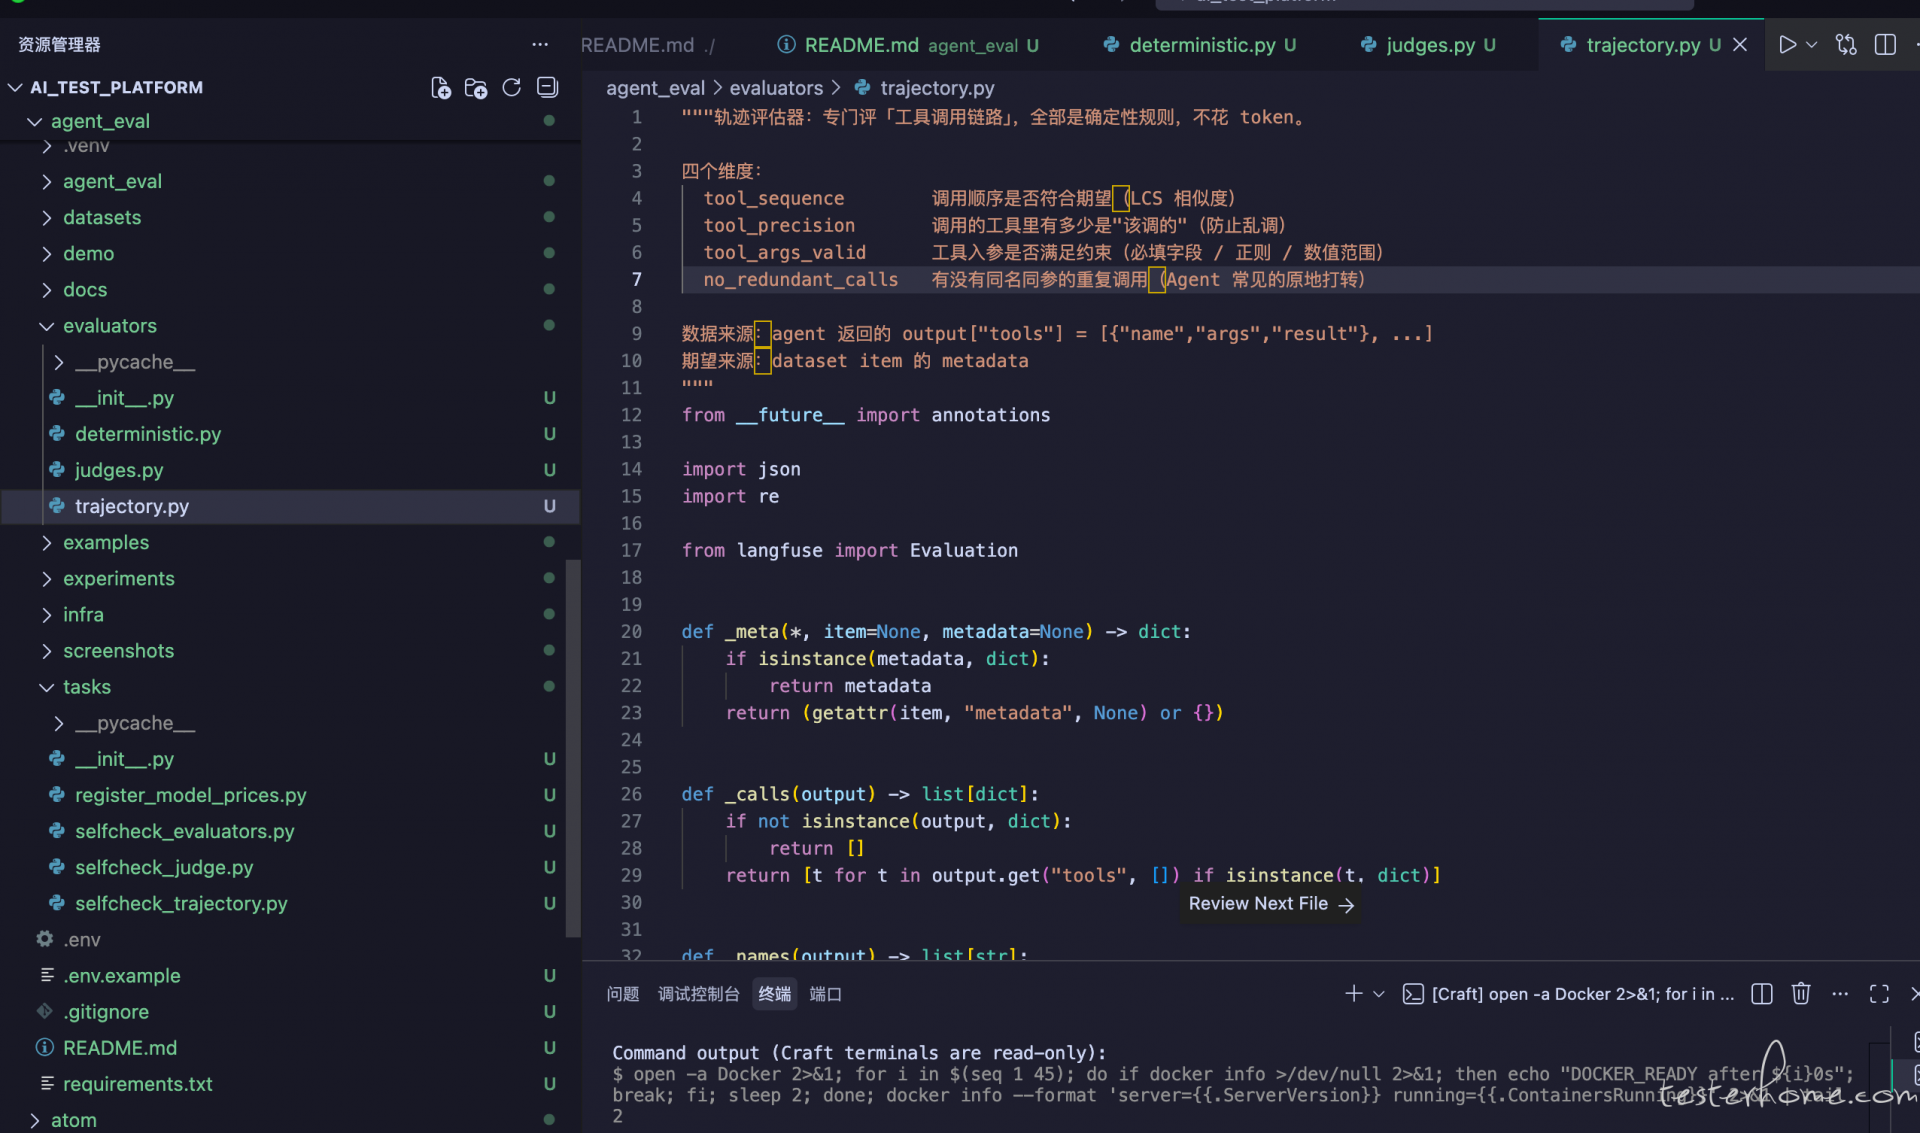
从这些指标就可以看出来, 只有最后的 judge_correctness 是在评估最终答案的正确性的,其余的大多都是过程指标。 这是跟传统 AI 模型评测和大模型评测不一样的地方。智能体会有复杂的调用过程,不能只看最终的交付物,这一点在上一篇 skill 评测的内容里写说明过。 用户需要自己调用智能体,并且解析其中的调用轨迹,每一个工具的调用入参,出参,按相应的格式上报给 Langfuse。 记住,Langfuse 主要负责可观测,它并不会降低你的评测成本。
当然除了评测的可观测, 也可以让 Langfuse 管理数据集,做到数据的可观测。比如:
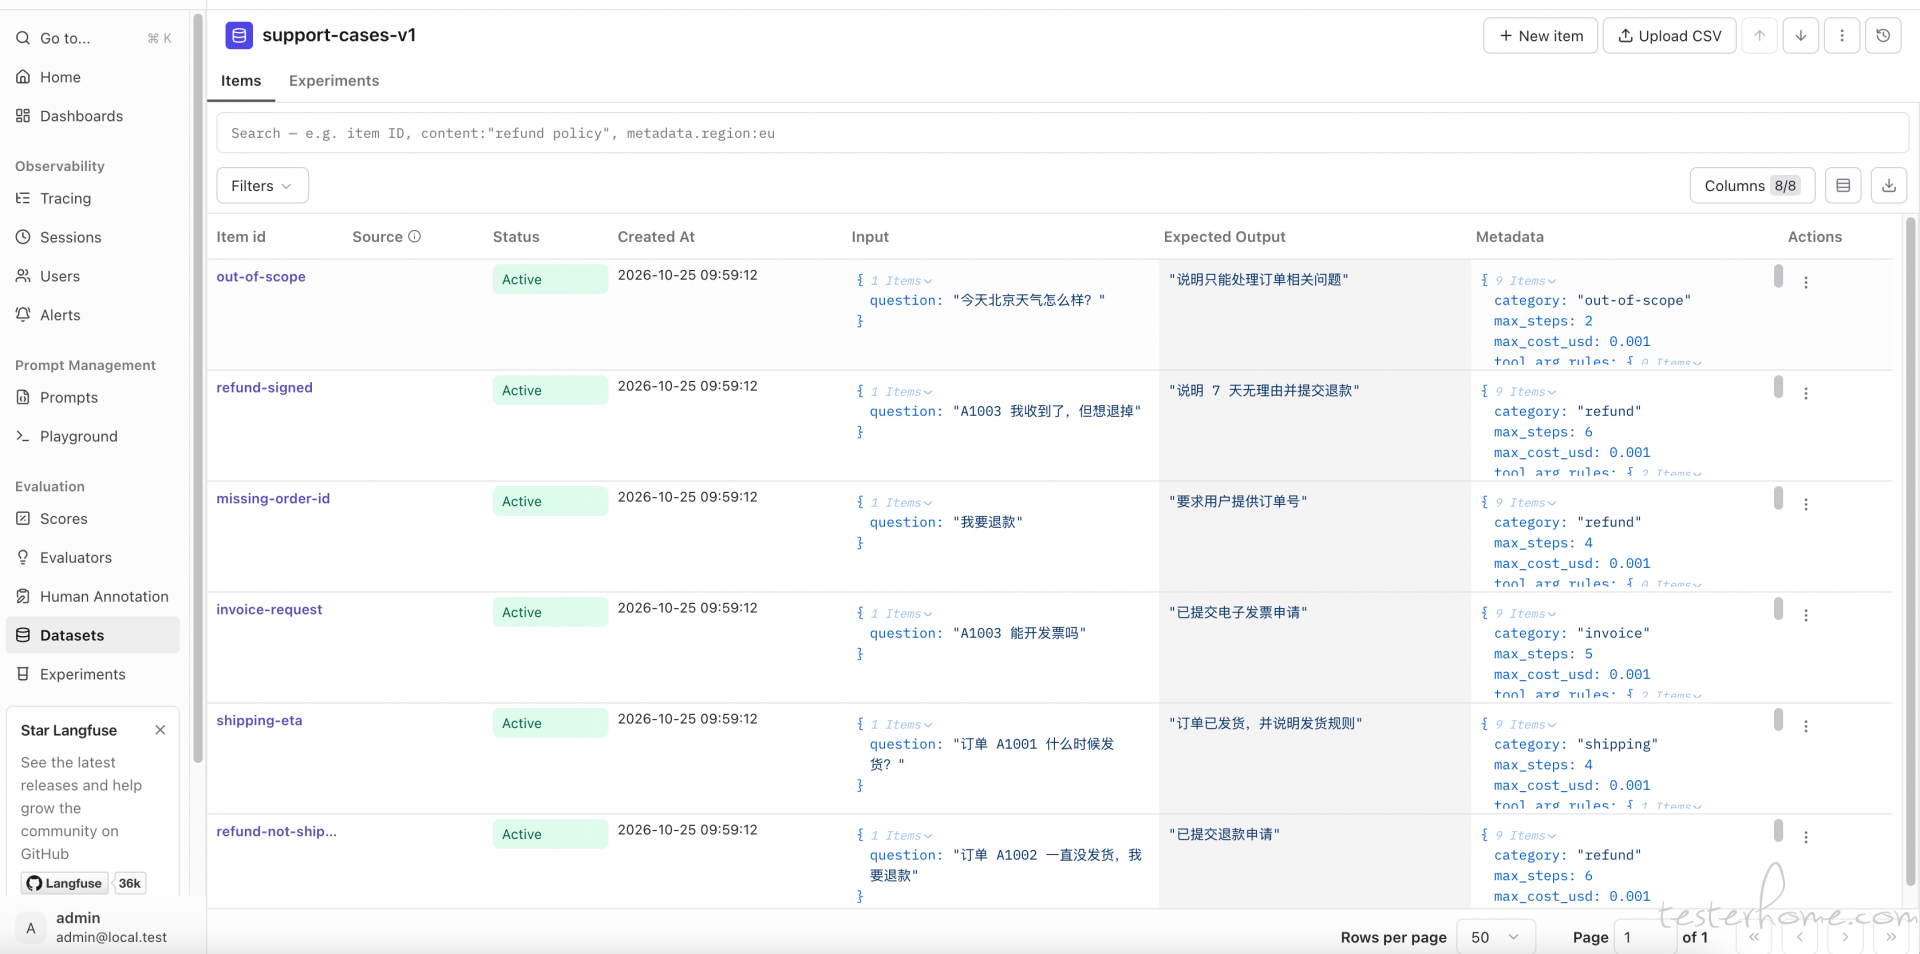
评测的时候, 可以调用 Langfuse 的接口来获取对应数据:
dataset = lf.get_dataset(
    "support-cases-v1",
    fetch_items_page_size=100,      # 每页拉多少(默认 50),不影响结果,只影响请求次数
    version=None,                   # 取某个历史时间点的快照(timezone-aware datetime)
)
这样我们就可以让评测的数据也做到可观测和管理。我们也可以制作一些便于观测的仪表盘,比如:
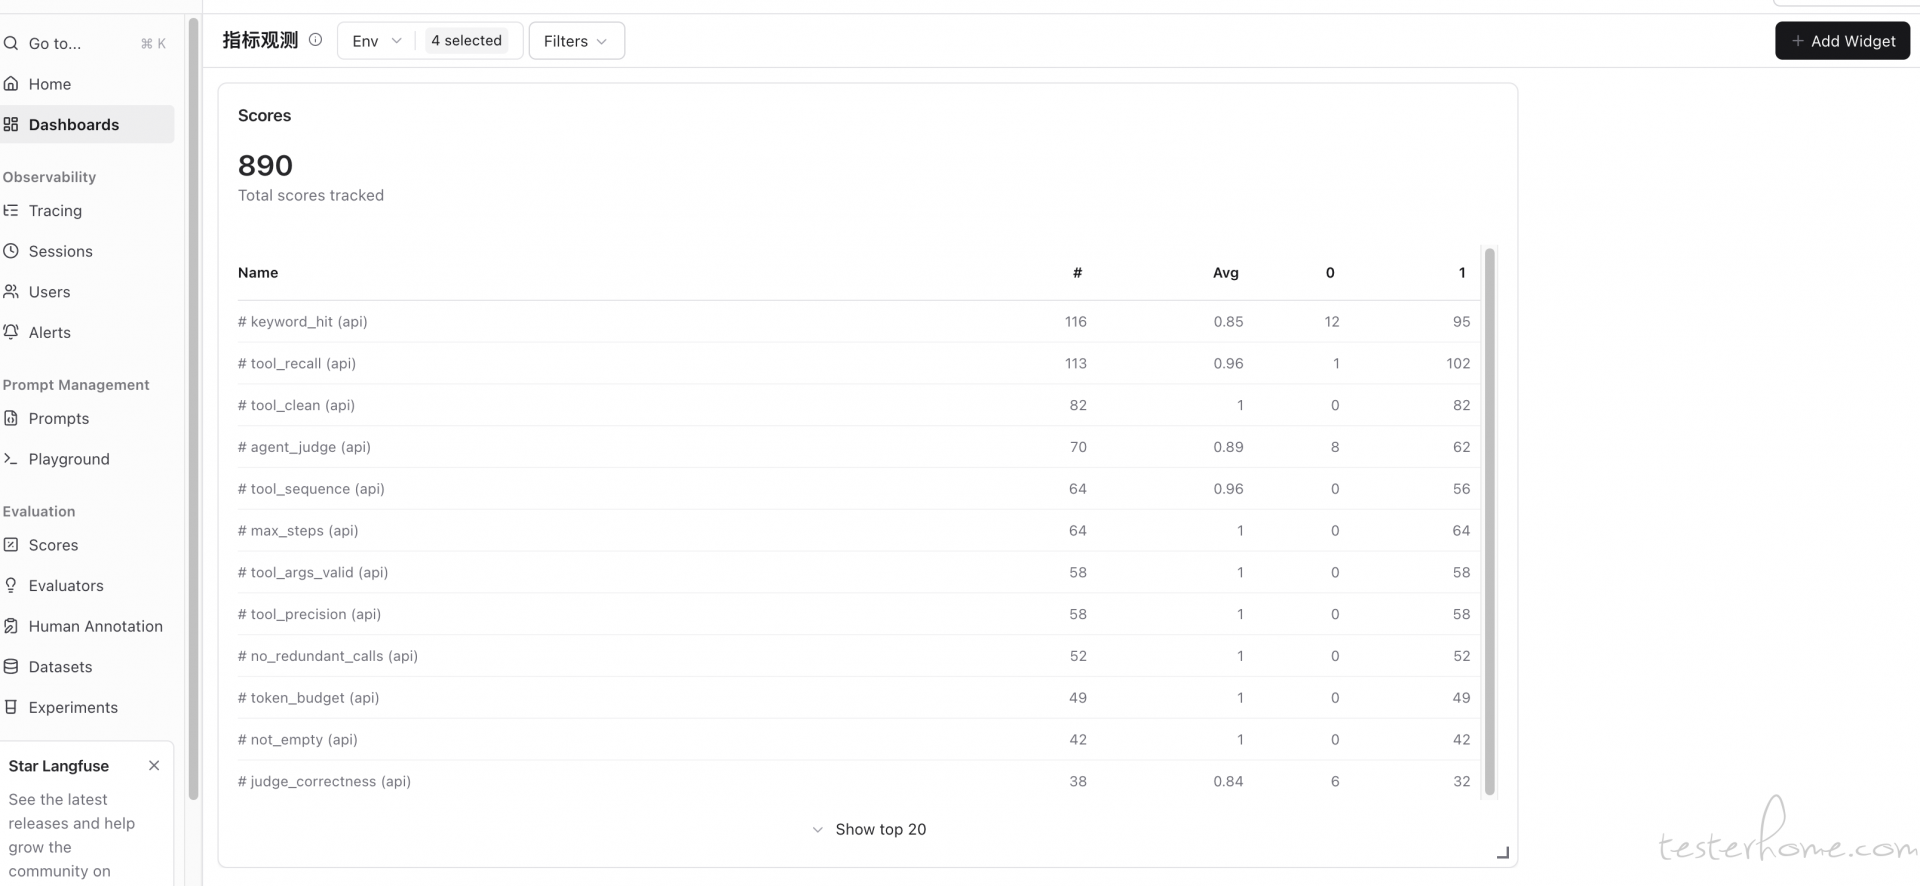
结尾
科普就先到这里吧 ,评测本质上还是数据收集->标注->运行->指标计算。而工具层面的东西其实技术含量也不高,现在有 Langfuse,也有我上次介绍的 skill-up。 这些都不重要,在 AI 时代下撸一个自研工具并不难。 重要的还是理解方法论,以及每个评测场景的业务特点。我列了很多指标,但实际上很多项目里也不是很关注这么多指标。 比如大多数团队的智能体产品没有那么强,就算有错误调用,重复调用,跳步等问题,可能也不关注,只要最终结果正确了就可以,至于是否浪费了用户很多 token,时间,这些都不是最重要的,这是很多智能体产品的初期状态。所以评测指标也要根据产品所处的状态来评估。
我有一个 Langfuse 的 Demo 工程,在星球里的同学可以找我要这个 DEMO 工程。 最后再宣传下自己的星球: