AI测试 DeepSeek 首次发布 ASR 和 TTS 语音模型 API,可独立调用并按量计费;腾讯混元 Hy Realtime 上线,支持语音中工具调用与点歌演唱丨日报

本期编辑:@ 三水 @ 鲍勃
01 有话题的技术
1、腾讯混元发布实时语音模型 Hy Realtime:新增 Agentic 工具调用与唱歌能力,已接入元宝和腾讯客服
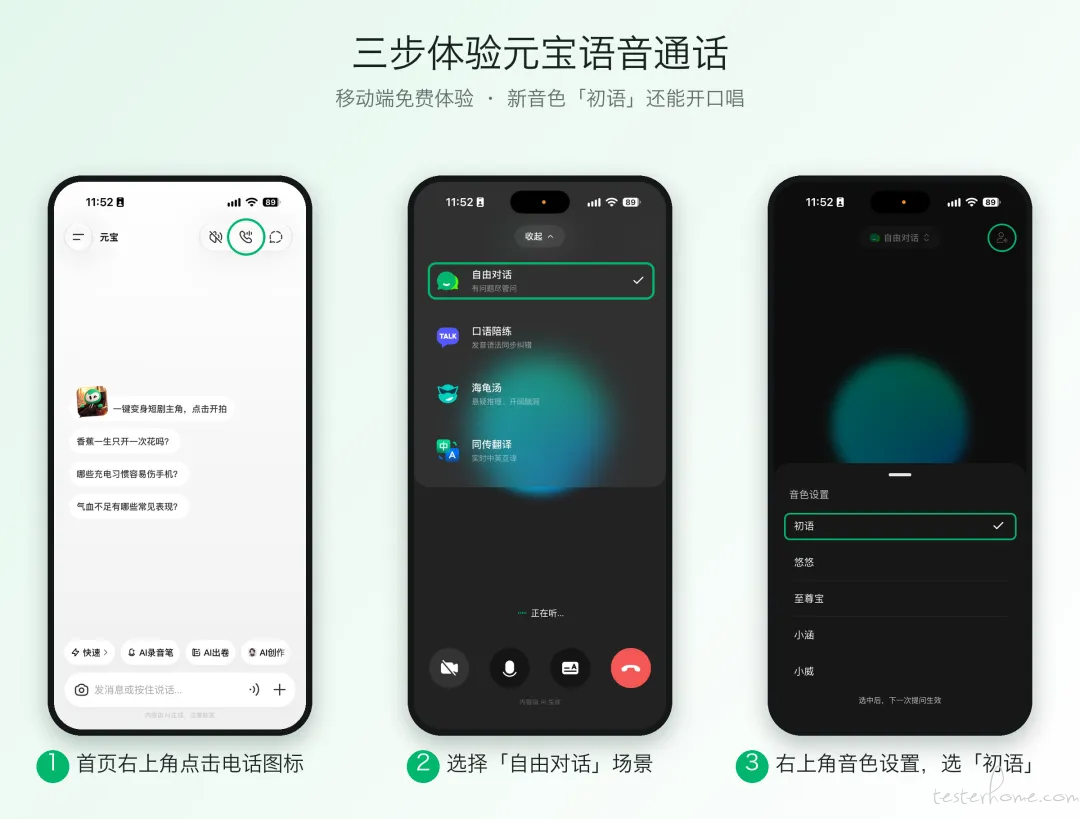
腾讯混元发布实时语音模型 Hy Realtime,在语音理解、多轮指令遵循和拟人化表达方面升级,并新增 Agentic 工具调用与唱歌能力。模型能够结合上下文理解用户含糊、未说完或中途修改的指令,在语音交流中自主决定是否联网搜索,并通过与腾讯音乐 TME 灵音 AI 团队合作,将自然语言点歌和语音演唱融入对话。
支持语音对话中的工具调用: Hy Realtime 可根据用户意图判断是否发起联网搜索,将搜索决策、工具调用和答案生成整合到对话流程中,并增强长对话中的上下文理解与指令遵循能力。
联合 TME 灵音 AI 团队加入唱歌功能: 用户可按歌手、专辑、曲风、语种、发行年份和热度组合点歌,也可在多轮对话中继续选择歌曲。团队同步优化歌声的情绪表现、咬字、气息衔接和旋律节奏。
已在元宝上线,腾讯云 API 即将开放: 模型已应用于元宝语音通话和腾讯客服,可在最新版元宝 App 中选择「初语」音色体验,部分能力也提供网页 Demo。腾讯云 API 仍处于计划开放阶段,后续将继续优化双工交互、长期个性化记忆和前后台 Agent 协作。
实时语音模型 Hy Realtime 发布:能说会唱、还能调用工具
https://rtcube.cloud.tencent.com/component/hunyuan/index.html
2、DeepSeek 开放搜索、OCR、ASR 与 TTS 等应用 API:支持独立调用,工具费用与 Token 分开计价
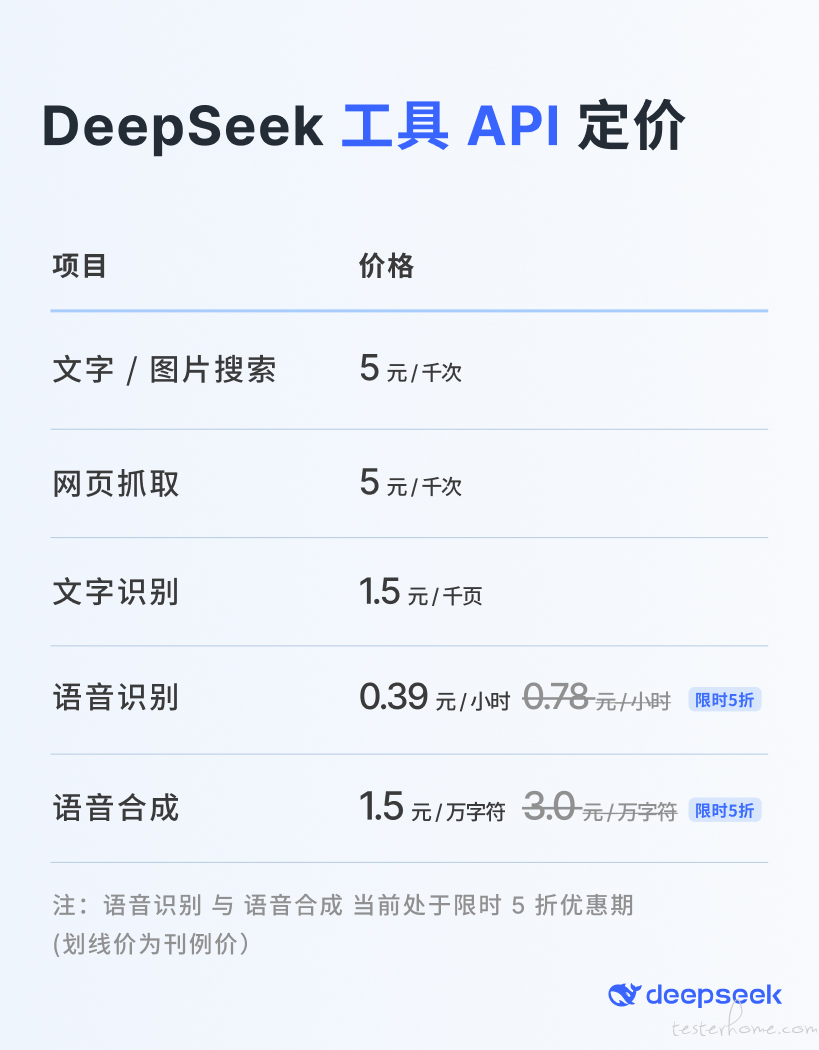
DeepSeek 宣布开放「全家桶应用 API」,将此前 DeepSeek App 中的联网搜索、文件解析、链接阅读及语音输入输出能力提供给开发者。此次更新基于已有的 DeepSeek-V4.1-Flash 模型,无需更换基础模型,即可通过参数开启内置工具,也可独立调用 Search、Fetch、OCR、ASR 和 TTS 接口。DeepSeek 同步开源浏览器聊天 Demo,展示如何组合这些能力构建应用。
三种对话接口支持内置搜索与文件处理:
deepseek-flash已在 Messages、Responses 和 Chat Completions 接口下支持扩展能力。开发者可启用deepseek_web_search实现联网搜索,或通过deepseek_read_url自动读取网页,工具调用和上下文拼接由服务端处理。搜索、OCR 和语音能力可单独调用: Search、Fetch、OCR、ASR 和 TTS 均提供独立接口,支持将网页检索、图片文字识别、语音转文字及文字转语音组合到自有工作流中,不必全部依赖模型对话完成。
工具费用在 Token 之外单独计算: 官方定价中,搜索和网页抓取均为每千次 5 元,OCR 为每千页 1.5 元;ASR 限时优惠价为每小时 0.39 元,TTS 为每万字符 1.5 元。不同工具分别按请求次数、页数、音频时长或字符量计费。
开源浏览器直连聊天 Demo: 官方发布基于 DeepSeek API 的静态前端,支持搜索、文档上传、语音输入输出和历史对话导入,无需自建应用后端即可运行。代码采用 MIT 许可证,开发者需自行配置 API Key。
Demo 体验入口:
https://cdn.deepseek.com/chat-demo
示例代码入口:
https://github.com/deepseek-ai/chat-demo
3、独立开发者开源 450 万参数 TTS 模型 tiny-voca:仅 18MB,使用纯合成语音,无真人声音训练并支持浏览器运行
独立开发者 Muhammed Nazeem 发布并开源轻量级英语语音合成模型 tiny-voca,完整模型仅约 450 万参数、18MB,能够在 CPU 和浏览器中直接运行。与依赖真人录音训练的常见 TTS 方案不同,tiny-voca 从零开始使用 AI 合成语音数据训练,并通过显式预测音高、时长和能量生成波形。项目同步开放模型权重、训练数据、代码与训练流程。
450 万参数,四线程 CPU 生成速度约为实时 70 倍: 模型包含波形生成模块,PyTorch 权重文件约 18.2MB,支持 PyTorch、ONNX Runtime 和 ONNX Runtime Web,并提供浏览器端演示。
完全使用合成语音数据训练: 开发者先通过 Qwen3-TTS VoiceDesign 构建两种声音,再使用 Qwen3-TTS 1.7B 生成训练音频,没有使用真人录音作为 tiny-voca 的直接训练素材。公开数据集约 19.1 小时,其中训练集约 17.6 小时。
采用 Source-Filter 架构生成波形: 模型先预测音素时长、音高、清浊音和能量,再通过声源与滤波器合成 24kHz 音频,不使用大型神经声码器。完整训练在单张 RTX 4090 上耗时约 7.7 小时,开发者报告整个项目的 GPU 租用成本为 9.56 美元。
代码、权重和数据集均已开放: 提供两种固定美式英语音色,支持语速和音高调整。代码与模型权重采用 Apache 2.0 许可证,数据集采用 CC BY 4.0。目前仅支持英语,暂不支持声音克隆或真正的流式音频生成。
https://github.com/n4ze3m/tiny-voca
02 有亮点的产品
1、马斯克旗下 AI 团队裁撤约 60 名 Grok Imagine 员工:图像视频生成团队大幅缩减,转向 Coding 与 Agent
据科技媒体 The Information 援引知情人士消息,马斯克旗下 SpaceX 人工智能业务近期裁撤了 Grok Imagine 图像及视频生成团队的大部分员工,涉及约 60 人。目前仅保留少数成员维持产品运行,Grok Imagine 仍对用户开放。报道指出,相关业务正在将更多资源投入 AI 编程工具与 Grok Bot 等 Agent 产品。
Grok Imagine 团队大幅缩减: 据报道,约 60 名参与图像和视频生成产品研发的员工在此前一周被裁,仅剩少数成员继续维护现有服务。公司尚未公开确认具体裁员人数。
AI 编程与 Agent 成为资源投入重点: The Information 称,相关业务正优先发展 AI 编程工具及 Grok Bot,Grok Imagine 后续的模型研发计划尚不明确。
此前已调整四大业务方向: 马斯克在 2026 年 2 月宣布,将 xAI 业务划分为 Grok 基础模型与语音、Coding 模型与机器学习基础设施、Imagine 图像视频生成及 Macrohard 企业流程自动化四大方向。此次 Imagine 团队裁员发生在该调整之后,并不意味着所有多模态研发业务均被取消。
https://www.theinformation.com/articles/elon-musks-ai-group-guts-grok-video-generation-team/
2、Anthropic 推出 Claude Meetings:AI 作为可见参会者加入 Google Meet,实时回答问题并创建文档
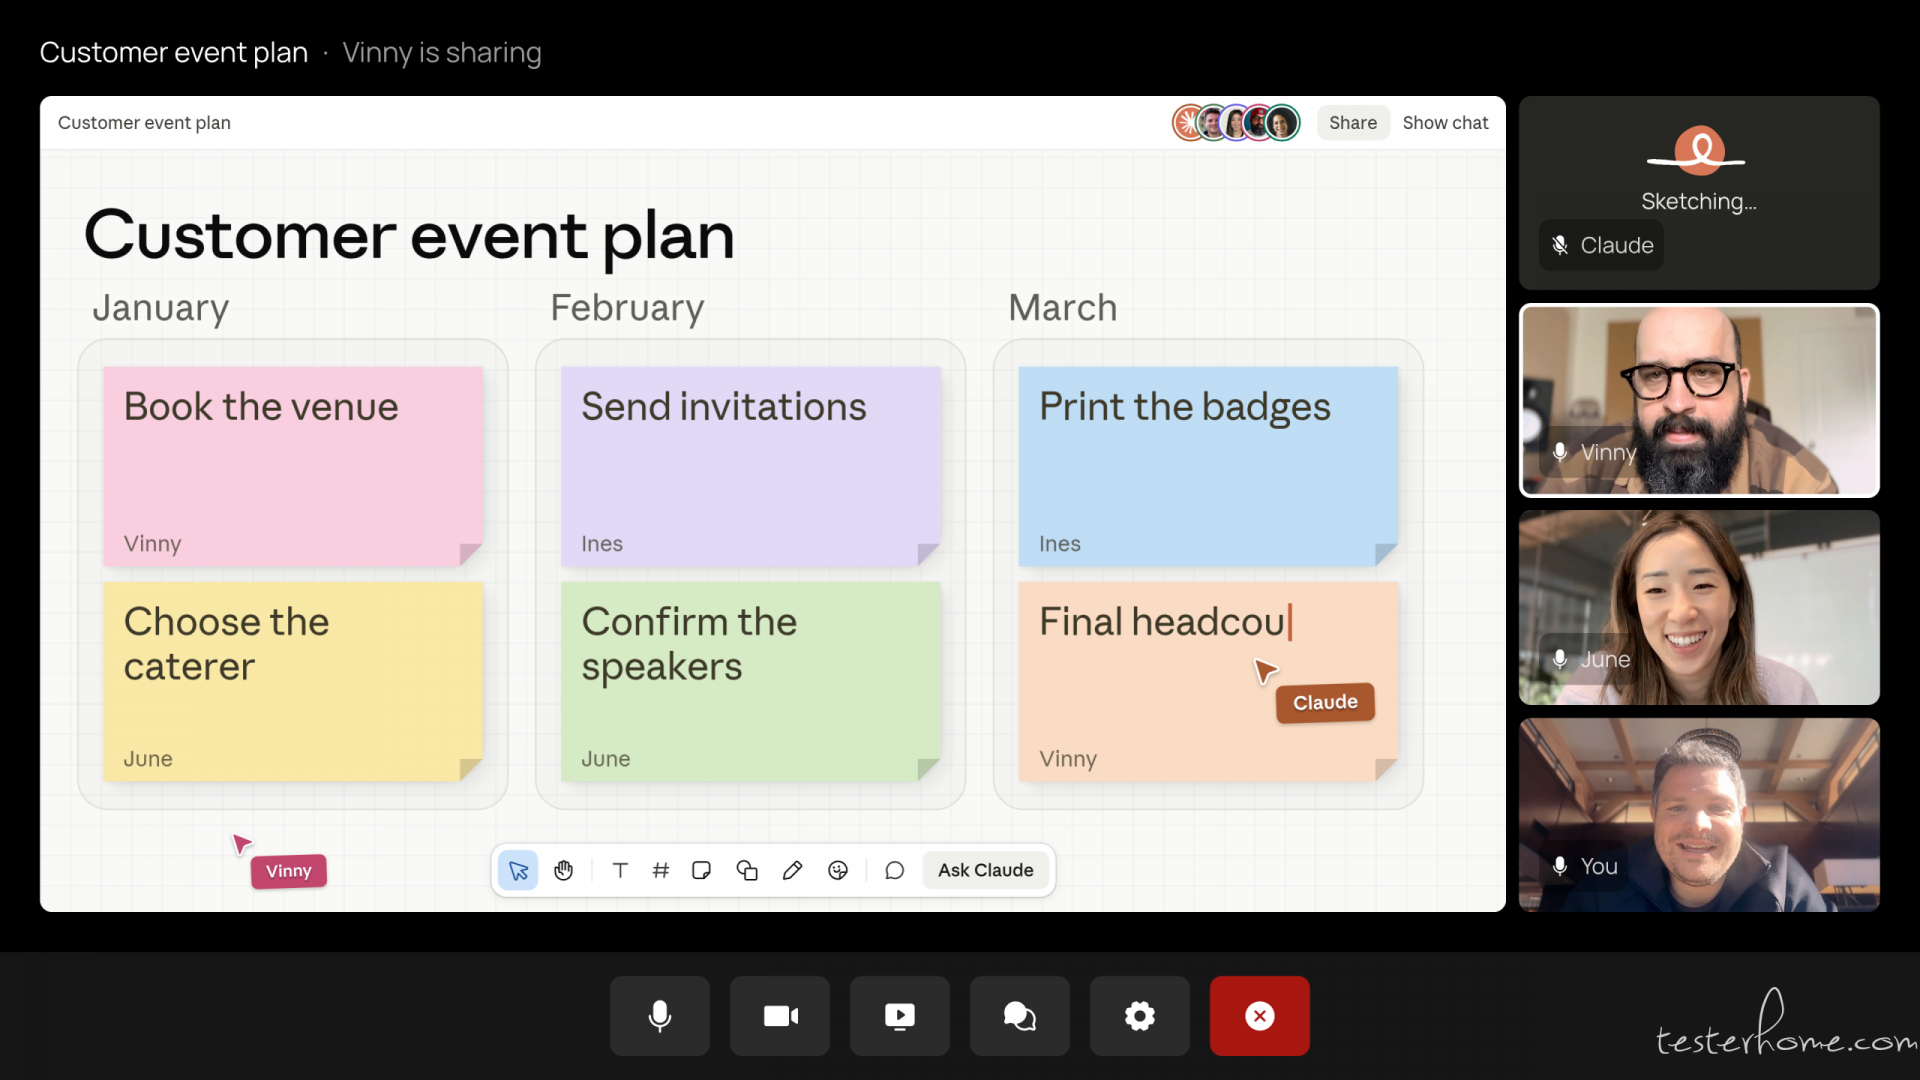
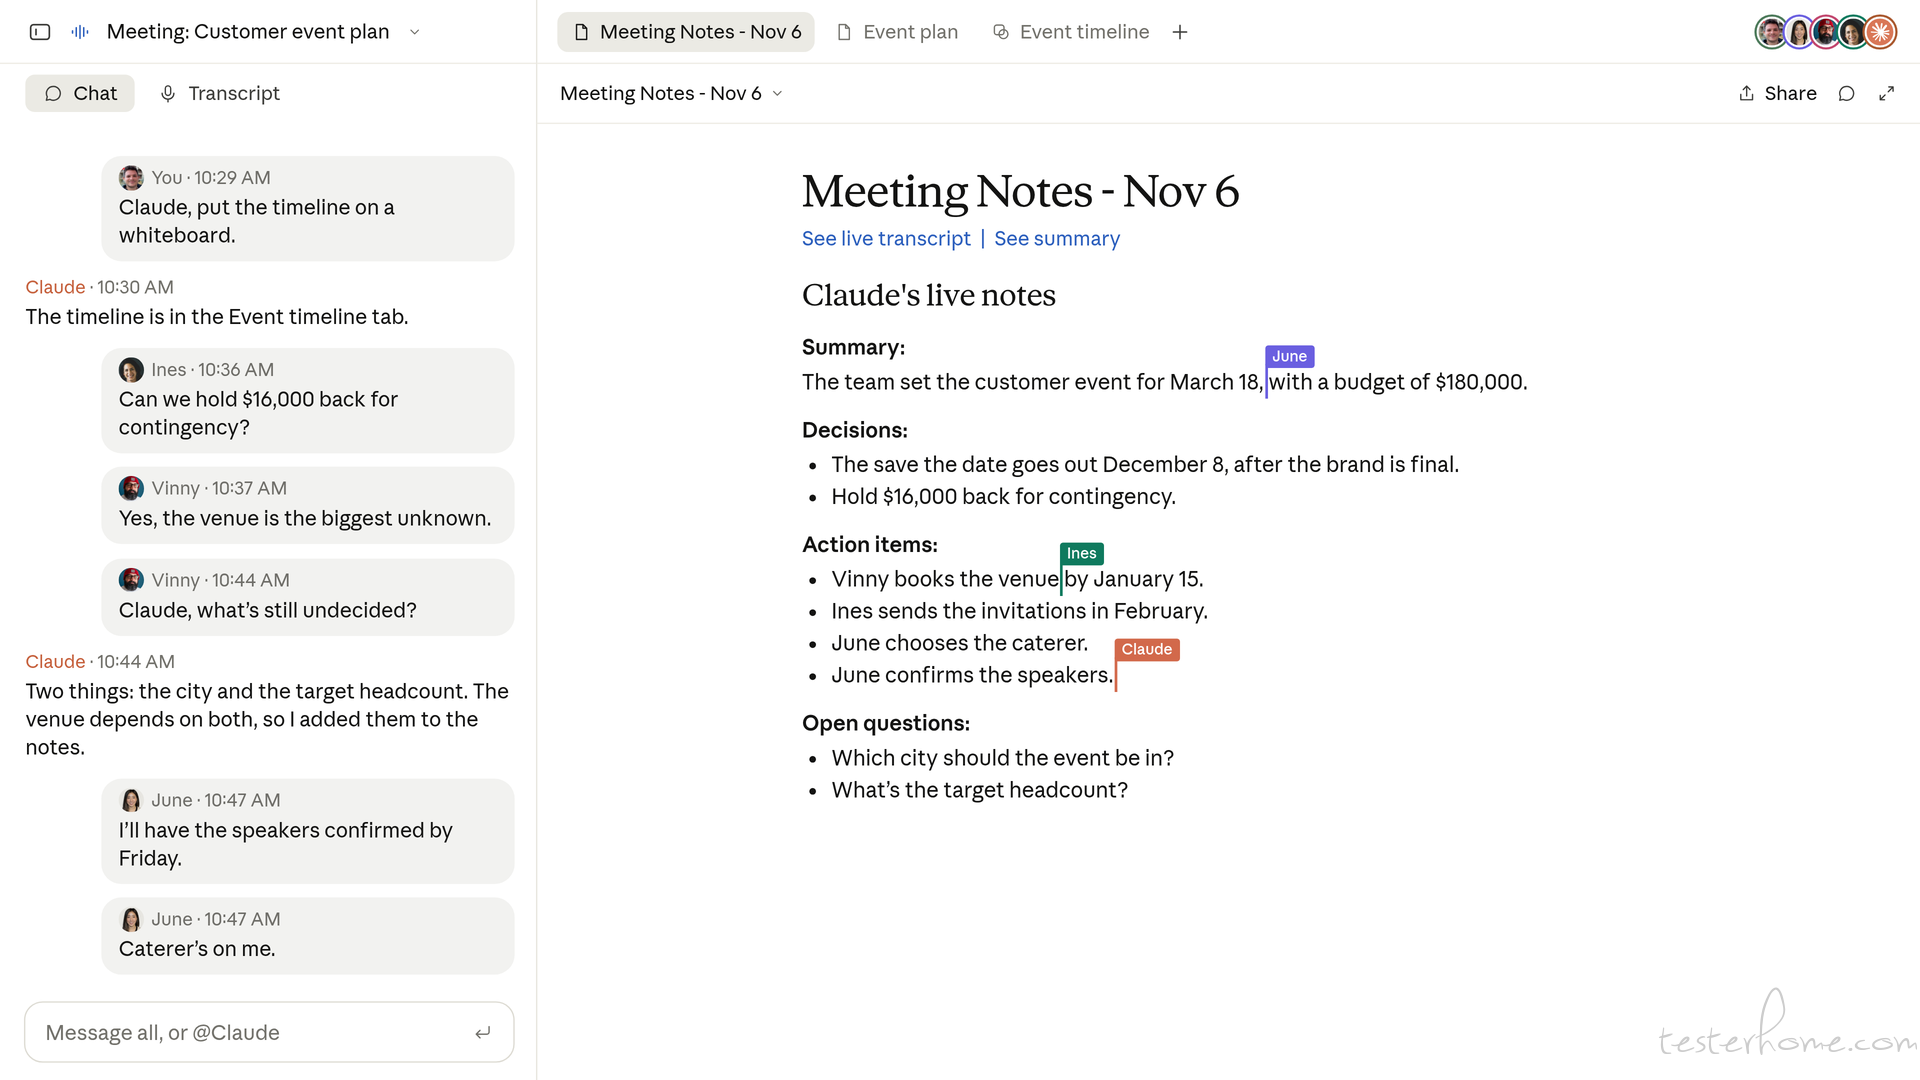
Anthropic 发布 Claude Meetings Beta,将 Claude 作为独立参会者加入 Google Meet 视频会议。与主要在会后生成纪要的会议助手不同,Claude 可以在会议过程中理解讨论内容,接受口头或聊天指令,实时查询授权的外部工具,并与参会者共同创建文档、白板及其他工作成果。目前功能开始向 Claude Team 和 Enterprise 用户分批开放。
以可见身份参加实时会议: 用户可通过会议邀请或自动加入功能让 Claude 进入 Google Meet。参会者可以口头提问或发送聊天消息,Claude 默认以文字回复,并能够在会议进行时整理讨论要点及行动事项。
实时创建并协作文档与白板: 会议中可直接要求 Claude 起草方案、制作白板或整理时间表,其他受邀成员能够同步修改。会议结束后,转写文本、总结及生成的工作成果会保存在 claude.ai 的独立会议页面。
连接外部工具并设置权限控制: Claude 可在用户授权后调用已连接的服务查询信息。默认不参加含组织外部人员的会议;管理员可调整规则。系统保存转写、摘要和屏幕内容描述,不保存原始音频。
Google Meet 首发,更多集成仍在规划: 功能已开始向 Team 和 Enterprise 计划推出 Beta。Anthropic 同时宣布与 Gong、Attention、Granola、Fireflies.ai、Otter 和 Plaud 合作,未来将支持向这些工具发送会议转写内容,目前尚非全部正式上线。
https://claude.com/resources/articles/claude-meetings
3、Apple Watch AI 录音应用 Auday 发布 1.1.0:支持录音中断后自动恢复,结合语音、健康与位置构建个人记忆
Apple Watch 全天候 AI 录音应用 Auday 发布 1.1.0 版本,重点升级持续录音稳定性、本地语音处理与个人记忆管理。用户可通过 Apple Watch 采集日常对话,在 iPhone 上进行语音转写,并结合授权的健康、压力估计及位置信息回顾一天的经历。此次更新新增录音连续性引擎,尝试解决来电、Siri 和闹钟打断录音后需要手动重启的问题。
录音中断后自动恢复: 新增 Recording Continuity Engine,在完成相应设置后,可在闹钟、Siri 或来电中断后自动恢复 Apple Watch 录音,无需通过模拟运动会话维持后台运行。持续录音仍受设备电量、存储及系统调度限制。
优化端侧转写与数据处理: 通过并行声纹匹配、检查点恢复和存储架构调整,减少长时间录音转写时的重复处理与内存开销。支持本地转写、语义检索,也可选择云端或自托管转写服务。
加强系统快捷操作与记忆管理: 新增 Shortcuts、Siri 和 Apple Watch Ultra 操作按钮控制,并可根据睡眠计划或专注模式结束录制。用户能够重新转写指定小时的录音,保存的 AI 记忆也可独立于原始音频保留。
支持连接外部 AI 工作流: 通过 Auday Skill 将授权的录音文本、摘要和记忆同步至兼容的桌面 AI 助手。应用采用一次性买断模式,设备端录音与本地转写无需订阅,使用第三方 AI 服务则需自行配置提供商及 API Key。
https://x.com/auday_ai/status/2121984977449705541
4、The Browser Company 开放语音交互实验 Clackety Clack:结合全双工语音与图形界面,支持边说边编辑工作内容
Arc、Dia 浏览器背后的 The Browser Company 公开一款 iPhone 语音交互实验应用 Clackety Clack,并通过 TestFlight 提供测试。团队正在探索将全双工语音模型与传统软件图形界面(GUI)结合,让用户不必依赖单一聊天窗口,而是通过自然对话直接组织想法、编写消息及修改工作内容。该项目由少量成员在数周内完成,目前属于研发实验。
探索全双工语音与 GUI 协同: 用户可以持续说出想法,同时查看屏幕上的内容变化,并通过语音补充和调整表达。团队希望将语音从独立聊天入口,扩展为软件操作过程中的实时交互方式。
支持口述工作消息与文档内容: 官方演示展示了用户通过语音整理思路、编写 Slack 消息及工作文档等场景,减少在语音记录、文本编辑和应用界面之间切换的操作。
已通过 TestFlight 开放体验: Clackety Clack 目前是独立 iPhone 研发实验,而非 Dia 正式版功能。团队表示计划继续探索,并将相关经验用于 2027 年的 Dia 产品迭代,包括移动端方向。当前未公开底层语音模型名称、SDK、API 或延迟评测数据。
https://x.com/joshm/status/2122081456646393919
03 有态度的观点
1、Dario Amodei:算力预测是 Anthropic 面临的最深层商业困境
据《商业内幕》报道,Anthropic CEO Dario Amodei 近日在与摩根大通 CEO Jamie Dimon 的直播对谈中表示,围绕算力的「巨大不确定性」是公司目前面临的「最深层商业困境」。
Anthropic 正冲刺首次公开募股(IPO),目标估值 1.4 万亿美元,计划于下周三定价、下周四挂牌交易。招股书显示,公司已承诺投入约 9000 亿美元用于基础设施建设,其中约一半资金将于 2030 年前到期。Amodei 坦言,算力采购面临两难:买多会导致成本远超营收,买少则会造成客户算力断供及研发受阻。
为应对这一风险,Anthropic 将结合 Claude Code 等产品的增长势头预判需求,并依托两大「缓冲机制」:一是较高的单位算力毛利率,二是截至 9 月 30 日超过 950 亿美元的现金及 360 亿美元的短期投资。在具体策略上,公司倾向于提前锁定「相对较少」的算力以保持灵活性,若实际需求超出预期,则动用充裕的现金在现货市场即时采购。
(@APPSO)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与 「RTE 开发者日报」 内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考