AI测试 日本 Shizuku AI 公司发布全双工语音模型,面向 AI 角色实时交流;全双工语音模型 Sophon-Realtime v1,理解语气并生成笑声、叹息丨日报

本期编辑:@ 三水 @ 鲍勃
01 有话题的技术
1、日本 AI 角色公司 Shizuku AI 发布全双工语音模型 Shizuku-Duplex:80ms 流式处理,支持边聊边搜索与表情动作生成
11 月 8 日,日本 AI 角色开发公司 Shizuku AI 发布全双工语音对话模型 Shizuku-Duplex,面向日语 AI 角色的自然实时交流。模型能够在持续聆听用户说话的同时主动附和、回应和处理打断,并结合后台推理模型执行搜索等任务,让 AI 角色在交谈过程中保持语音与表情动作的连续性。
80ms 分块处理全双工语音: 模型每 80ms 接收一次音频特征并生成输出,利用 LLM 驱动的交互模型判断何时发言、保持沉默或回应用户。通过 TensorRT 和 Triton 推理优化满足实时处理要求。
前台对话与后台工具调用并行: 交互模型通过 DELEGATE token 将复杂请求交给后台模型,在搜索或推理期间继续与用户交流,获得结果后再自然地融入对话。系统同时输出音频、文本及 Action 信号,用于驱动 Live2D 角色动作。
日语对话响应中位延迟约 0.57 秒: 团队自建日语全双工评测中,Shizuku-Duplex 在用户结束发言后的响应中位延迟为 0.57 秒,GPT-Live 为 0.53 秒;用户打断后 2 秒内停止说话的比例为 89%,高于 GPT-Live 的 82%。
支持长对话上下文压缩: 系统约每 5 分钟总结一次对话历史,并在单个处理周期内完成上下文切换,以降低长时间交流中的上下文占用。目前主要面向日语场景,视觉输入和更多语言仍在后续规划中,尚未公布公开模型权重。
2、语音 AI 公司 Tazo Labs 联合 Bolna 推出语音决策基准 DECIDE:4867 道真实通话问题,评估接话、工具调用与情绪判断
语音 AI 公司 Tazo Labs 联合 Voice Agent 平台 Bolna 发布音频决策评测基准 DECIDE(Decision Evaluation in Calls: Intent, Dialogue and Emotion),重点评估语音 Agent 在实际客服通话中如何根据声音及对话上下文决定下一步行动。基准从 570 通生产环境电话中提取 1081 段音频,构建 4867 道决策问题,并提供音频模型与 STT + 文本模型的统一评测方式。
4867 道问题覆盖 32 项决策任务: 音频片段时长为 3–25 秒,涵盖业务意图、流程路由、工具选择、对话轮次、声音特征及语言切换六大类别,测试 Agent 何时回应、是否转接、选择哪个工具,以及如何判断用户情绪。
对比直接音频与 STT + 文本方案: 在相同音频片段、历史上下文及候选决策条件下,比较两类系统的决策准确率,并记录推理延迟和成本,用于衡量原始声音中的语气、停顿及打断信息对决策的影响。
开放评测代码与模型提交入口: 开发者可提交兼容 API 端点进行自动评测,获得按任务类别划分的结果。目前公开 20 道脱敏示例及评测工具,完整 4867 题数据集仍由评测方保管,技术论文尚待发布。
https://benchmark.tazolabs.com/
3、Adventists AI 开源 32B 全双工语音模型 Sophon-Realtime v1:能理解语气并生成笑声、叹息,最快 0.31 秒输出语音
AI 研究团队 Adventists AI 开源全双工语音模型系列 Sophon-Realtime v1,以共享的 32B 模型负责持续聆听、轮次判断和回复生成,并通过三种不同的语音输出架构适配实时陪伴、客服和研究场景。模型能够从语音中理解犹豫、重音、讽刺等副语言信息,并在回答中生成笑声、叹息、呼吸等非语言声音。
32B 模型统一处理语音理解与轮次决策: 模型持续监听用户语音,可在停顿时提前准备回复,并在用户继续说话时取消尚未播出的内容。结合 DuplexJev 音频决策模块识别语气、情绪和打断信号。
提供 Tag、Flash 与 E2E 三种版本: Tag 使用带情绪标签的 TTS 生成更具表现力的语音;Flash 使用轻量级语音模型降低延迟;E2E 研究预览版则直接在 32B 模型内部生成连续语音表示,无需独立 TTS 模型。
Flash 首段语音延迟约 0.31 秒: 团队在单张 H100 80GB GPU 上的测试显示,Flash 可支持约 40 路并发,Tag 约 16 路;共享模型在 VoiceBench 上取得 82.8 分,Big Bench Audio 准确率为 81.8%。
开放权重、部署代码与实时接口: Tag 和 Flash 支持通过 vLLM-Omni 单卡部署,提供 WebSocket 全双工接口及 OpenAI 兼容调用方式,并支持 LoRA 微调。代码和模型权重采用 Apache 2.0 许可证开放。
https://github.com/adventists-ai/sophon-realtime
4、上海交大等团队开源 4100 万组中英语音编辑数据集 VoxCanvas-41M:覆盖文本修改与笑声、叹息等副语言编辑
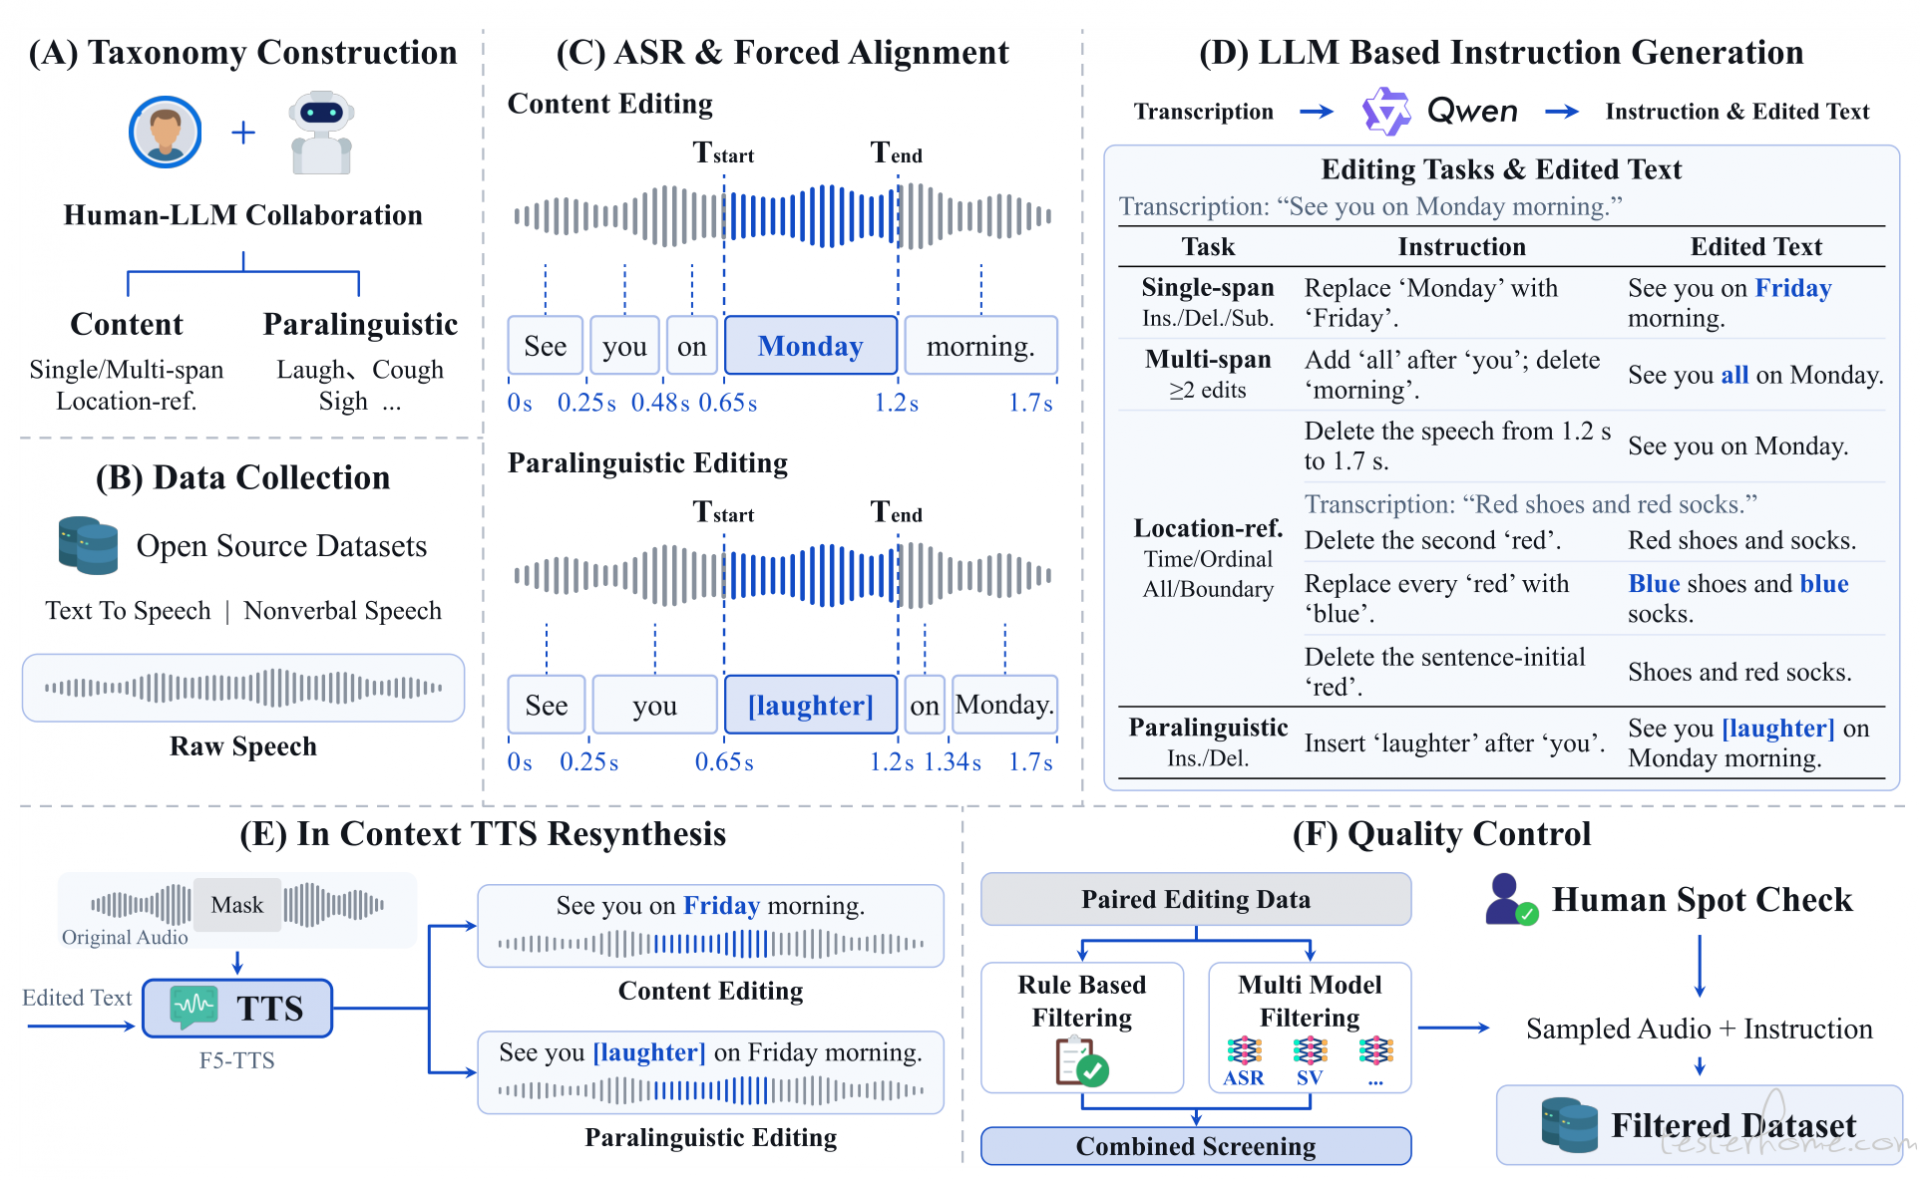
上海交通大学 X-LANCE 实验室联合上海创智学院、北京通用人工智能研究院及天津大学研究人员发布 VoxCanvas-41M,包含约 4100 万组中英双语语音编辑数据,支持通过自然语言指令修改录音内容或非语言声音。团队同步开源数据构建 Pipeline,并基于 AuK 模型验证了数据对语音编辑能力的提升。
4100 万组数据覆盖多种语音编辑任务: 每组数据包含原始语音、编辑指令和目标语音,支持单位置插入、删除、替换,多位置编辑及按词序、句首句尾或时间段指定修改位置,还包含笑声、叹息、咳嗽等 39 类非语言事件的添加与删除。
开源可扩展的数据构建流程: 以 Emilia 语音数据为基础,通过 Qwen3-ASR 重新转写、Qwen3-ForcedAligner 对齐时间戳,再利用 LLM 生成编辑指令、F5-TTS 合成修改片段,并通过 ASR 和说话人相似度检查筛选数据。
验证数据对语音编辑模型的提升: 团队基于 AuK 进行 LoRA 微调,在 SpeechEditBench 上,中英语音内容编辑平均准确率由 91.05% 提升至 95.22%。研究还发现,多位置编辑可受益于课程学习,联合训练语音生成与编辑任务能够改善学习效率。
数据集与构建代码已完整开放: 11 月 7 日,团队完成 VoxCanvas-41M 全量数据上传;11 月 8 日又开放使用 Qwen3-ASR 和 Qwen3-ForcedAligner 重新处理的 Emilia 六语言转写与时间戳数据,可供后续 TTS 训练和语音数据构建使用。
https://zhikangniu.github.io/voxcanvas/
02 有亮点的产品
1、Hugging Face 发布机器人开发框架 LeRobot v0.7.0:运行中可通过语言指令切换任务,支持远程推理与数据流式训练
11 月 5 日,Hugging Face 发布开源机器人开发框架 LeRobot v0.7.0,将语言交互引入机器人执行流程。开发者可以在机器人运行过程中修改任务、询问当前环境信息,或让模型自主规划后续动作,无需停止并重新加载策略。新版本同时升级大规模机器人数据训练、远程推理及世界动作模型支持。
运行中通过语言指令调整机器人任务: 新增交互式 Rollout,支持使用
/subtask切换任务、/vqa查询机器人观察到的画面、/autosteer指定目标并自动规划子任务。部分功能需要支持文本生成的 VLA 模型,或额外接入 VLM 规划器。机器人端与 GPU 推理端分离: 新增
lerobot-policy-server,允许机器人本地保留摄像头、运动控制与数据采集,将策略推理交给远程 GPU。通过动作分块缓存与轨迹对齐,机器人可在服务器计算下一段动作时继续执行。支持无需完整下载的数据集训练: 通过 Hub、Storage Buckets 或 LanceDB 直接读取机器人训练数据,按需获取视频片段。官方测试显示,使用 4 个 DataLoader Worker 时,流式数据读取吞吐提升约 2.1–2.5 倍。
扩展世界动作模型与分布式训练能力: 新增 Cosmos 3、FLUX 3 Action、LaWAM、Long-WAM 等世界动作模型,以及多款 VLA 模型,支持 FSDP2、HSDP 和分布式检查点,面向数十亿参数机器人模型训练。
https://github.com/huggingface/lerobot/releases/tag/v0.7.0
2、开发者 Jameson Hodge 开源浏览器语音合成器 CHIMERA:用 Rust 模拟肺部、声带与声道,实时生成语音和歌声
开发者 Jameson Hodge 开源物理建模语音合成器 CHIMERA,通过模拟肺部气流、声带振动、口腔与鼻腔的声学变化生成声音,无需预录音频样本或神经网络 TTS 模型。项目使用 Rust 编写声学引擎,并编译为 WebAssembly,通过浏览器 AudioWorklet 实时运行,支持语音、歌声及多种动物发声模拟。
通过物理模型合成声音: 模拟肺部气压、声带或鸣管振动,以及舌头、嘴唇、下颌和鼻腔对声音的影响。用户可以在交互式头部剖面图中调整发声器官,并实时观察气流、声谱和共振峰变化。
支持文本转语音、歌唱与节奏发声: 可将英文文本或 IPA 音标转换为发音动作,支持带歌词的钢琴卷帘歌唱、Beatbox 节奏生成,以及鸣禽、海豹、短吻鳄和大象等动物声音模拟。
开放浏览器与本地运行代码: Rust 引擎可编译为 WebAssembly,也能通过
chimeraCLI 原生运行,支持离线渲染、声学参数诊断及语音对比测试。项目采用 MIT 许可证开源。
https://github.com/jamesondh/chimera-vocal-synth
3、世界模型公司 World Labs 推出实时漫游演示 Frameboy:Atlas 云端生成画面最高 15fps,浏览器可交互控制视角
世界模型公司 World Labs 发布 Frameboy 研究预览版,将此前逐帧生成画面的 Atlas 世界模型扩展到实时交互场景。用户可以直接在浏览器中操控摄像机,探索由单张图片或多视角照片构建的世界,云端 GPU 持续生成新视角画面并以最高 15fps 流式传输。
Atlas 实现最高 15fps 的实时视角生成: Frameboy 使用经过推理优化的 Atlas 变体,在用户移动摄像机时连续生成画面,并通过云端 GPU 将结果流式传输至浏览器,减少此前需要等待完整视频生成的交互延迟。
支持生成场景与真实场景的新视角探索: Atlas 可从单张图片出发生成额外视角,构建可探索的虚拟空间,也能根据真实环境的多视角照片生成未拍摄角度的画面,保持场景外观与空间关系的一致性。
集成 Viewfinder 场景构建工具: 用户可在 Viewfinder 中逐帧调整摄像机位置,利用 Atlas 生成包含颜色和深度信息的场景画面,再切换到 Frameboy 流式模式进行交互探索。目前 Frameboy 已提供精选场景在线体验,Viewfinder 仍处于封闭测试阶段。
https://www.worldlabs.ai/blog/atlas-realtime
4、成都男子用 AI 眼镜与智能戒指在驾考中作弊:设备答题多选题全部答错,被罚 1900 元并禁考一年
据央视新闻报道,10 月 16 日,成都一名男子在增驾摩托车驾照的理论考试中使用 AI 眼镜和智能戒指作弊。驻场民警发现他反复摆弄眼镜和戒指,上前核查,男子承认设备是他从网上买来辅助答题的。
他此前申领汽车驾照时,理论考试考了 4 次才通过。调查中,男子自己在手机上刷题,正确率超过 85%。民警另行随机抽题,让他用设备演示,抽到的多选题全部答错。
成都交警对他作出罚款处罚,一年内不得再次申领机动车驾驶证。
( @APPSO)
03 有态度的观点
1、马斯克:SpaceX 明年 12 月年化营收或超 5000 亿美元
马斯克在 11 月 6 日的巴伦投资大会上表示,按 SpaceX 目前的计划,他个人估计,公司到 2027 年 12 月的年化营收可能超过 5000 亿美元。
这是按届时营收速度折算的年化规模,马斯克把它称为自己的估计。谈到增长从何而来,马斯克把地面数据中心和轨道算力放在同一套规划里。
他认为,地面扩张首先受制于供电和芯片供应,数据中心建设并非只要拿到芯片就能启动。SpaceX 希望用可重复使用的星舰降低发射成本,为把计算设备送入轨道创造条件。他还谈到特斯拉在中国的业务。以 Model Y 为例,他说上海工厂生产的这款车在中国市场取得销量成绩并不容易,原因是中国车企的竞争力很强。他也说自己喜欢去中国,觉得在中国旅行让人受到启发。
巴伦在访谈中将营收估计与 SpaceX 历史规模作比较。两人口中的年化营收是特定时点的收入速度,不能直接与公司过去完整年度的营收作同口径比较。谈及更近的时间点,马斯克还预计第四季度营收增幅将超过五成。
(@APPSO)
04 社区黑板报
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
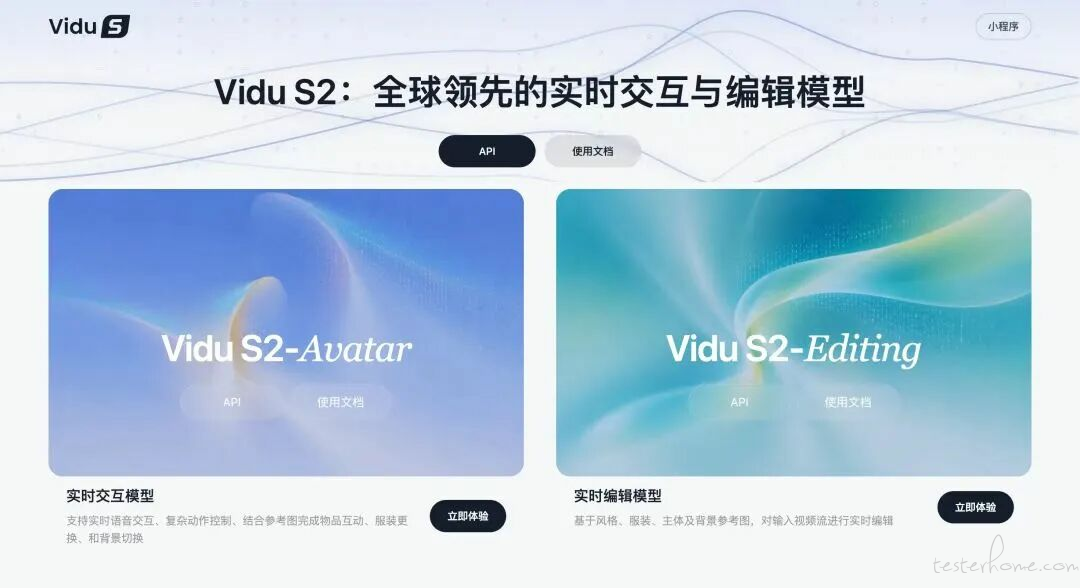
1、🎬 RTE 内测小分队首期招募|一起体验 Vidu S2
在 RTE 开发者社区,和最前沿的实时智能团队对话!这次我们和 Vidu 团队一起试试实时视频编辑和角色交互,也欢迎大家带着自己的应用场景来玩。
💬 S2-Avatar:开口和视频里的角色聊天,体验它如何实时回应你。
🎨 S2-Editing:上传一段视频,实时换风格、换穿搭、换主体或换背景。
🎁 社区专属福利:新注册用户可领取 5,000 积分体验 Vidu S2,名额有限。
想一起内测的伙伴,欢迎添加小助手微信 creators2022,回复「Vidu」加入「RTE 内测小分队」。邀请码和领取方式会在内测群里公布,也欢迎进群和 Vidu 团队交流体验反馈、API 接入问题 🙌
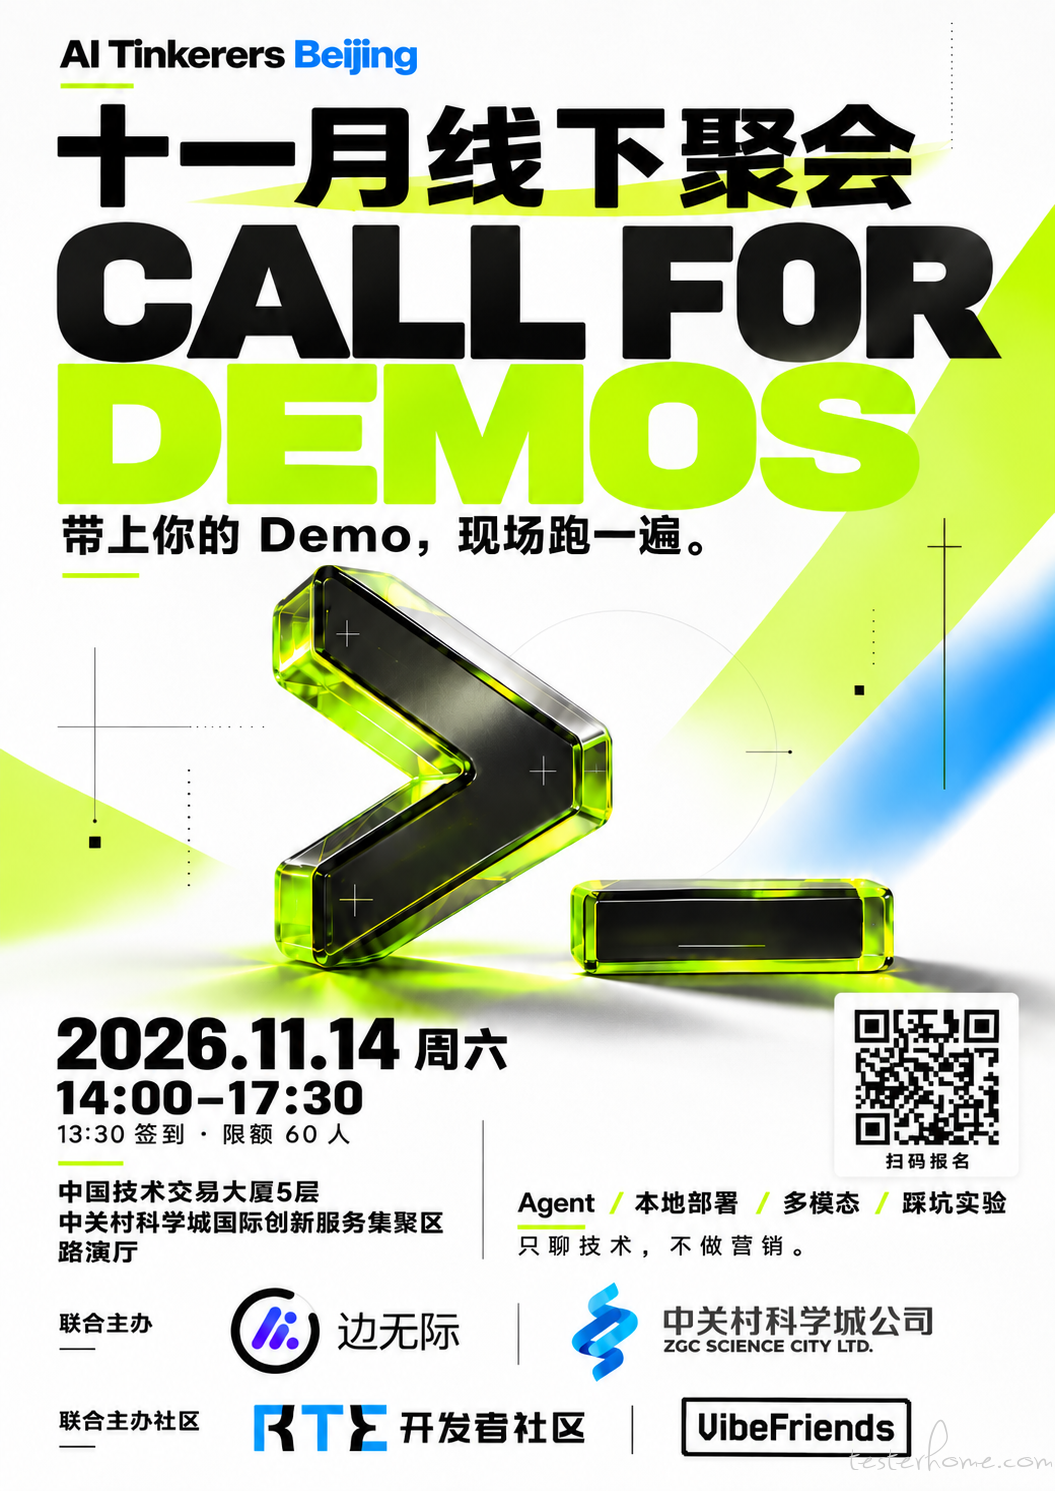
2、💻 北京的 RTE 社区伙伴们,周六带上你的 Demo,一起去 AI Tinkerers 北京十一月聚会,现场跑一遍!
跑通的 Agent 工作流、刚搭起来的语音或多模态原型、还在调试的本地推理服务,都可以带来。项目没做完也没关系,一次失败的实验,或者一个卡了好几天的技术问题,都值得拿出来一起聊。
现场安排了 5 分钟演示 + 3 分钟问答,还会一起帮一位伙伴改代码。欢迎打开电脑,跑给大家看,聊聊你怎么做、在哪一步卡住了。
 11 月 14 日(周六)14:00–17:30,13:30 开始签到
📍 北京 · 中国技术交易大厦 5 层路演厅
👥 限额 60 人
想上台跑 Demo,或带着问题来交流,欢迎点开下方文章,扫码报名👇
你的 AI 项目,值得被看见!AI Tinkerers 北京线下聚会开放报名
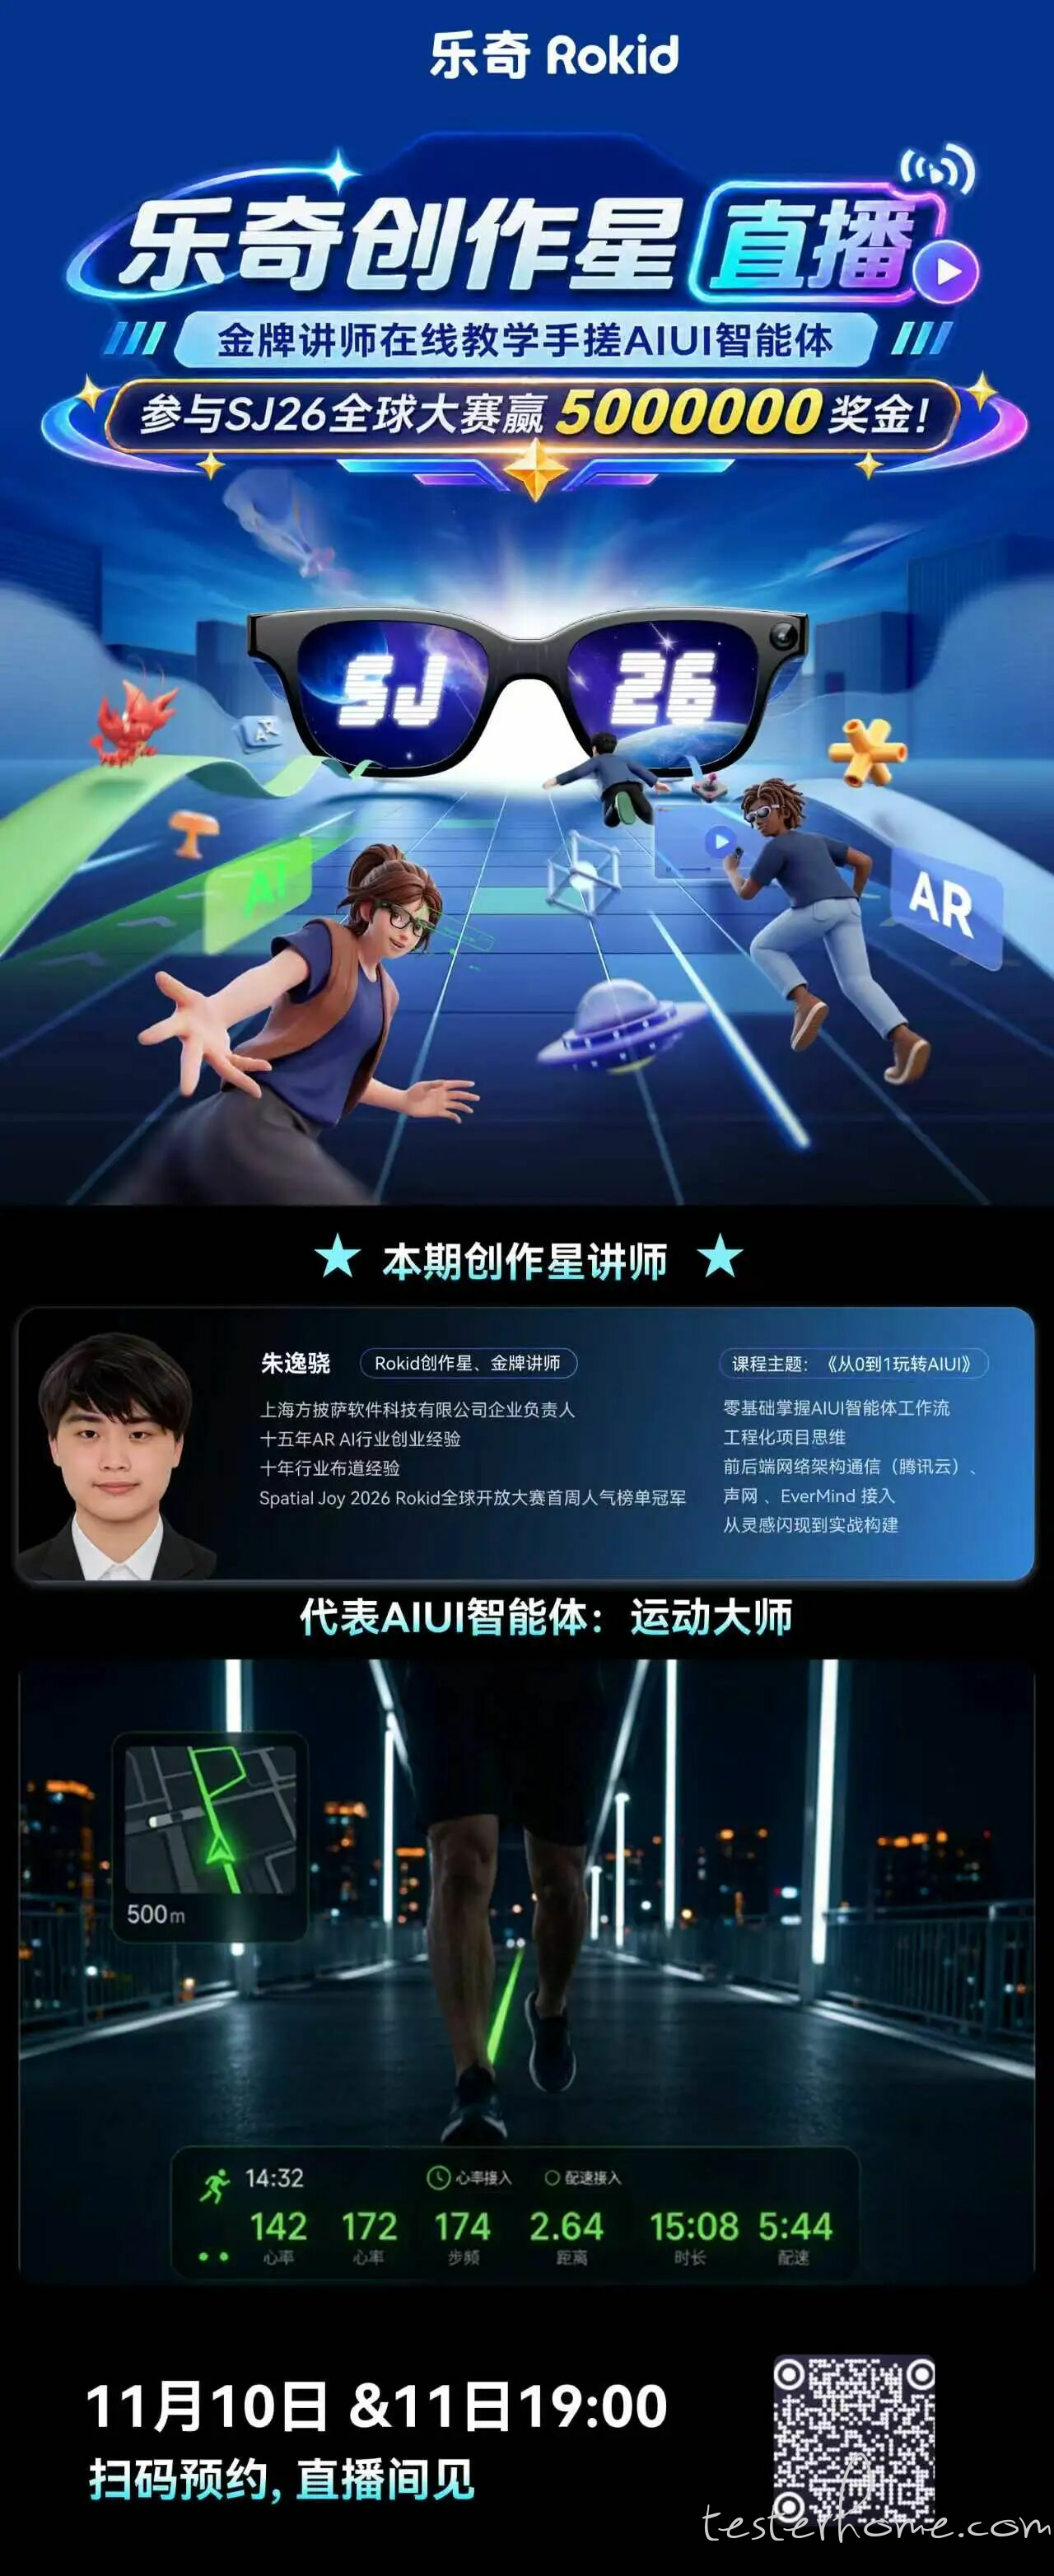
3、🙋 有在关注 Rokid 全球大赛的朋友吗!
千万别错过 Eason 的这场干货直播课!他将拿出自己的核心智能体「运动大师」,手把手带大家从 0 到 1 玩转 Rokid AIUI,并分享如何接入声网对话式 AI 技术。
对「AI 眼镜 × 对话式 AI」场景感兴趣、或者有开发技术疑问的小伙伴,快来直播间和 Eason 一起交流碰撞吧!期待你的加入~✨
本次大赛特设「声网 Agora 对话式 AI 专项奖」,总奖金高达 6 万元,欢迎挑战!
作为合作伙伴,RTE 开发者社区也会帮忙推荐一些开发者加入,如果你有兴趣一起参赛,欢迎联系我们,一起申请、组队和参赛!(有意申请的社区伙伴请加微信 creators2022 交流,并备注「Rokid 开发大赛」)
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与 「RTE 开发者日报」 内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考