
国内很多团队把 E2E 挂进合并门禁之后,最先崩的不是覆盖率,而是「今天绿、明天红」的偶发失败。重跑两次就过了,于是有人把 retries 调到 3,有人直接 skip。结果门禁还在,信号却废了。
这篇按「能落地」来写。目标很具体:让偶发失败可回放、可分类、可隔离,并且隔离不是黑洞。材料主要来自 Playwright 官方 Trace / Best Practices / CI 文档,以及近年把 quarantine 做成可审计流程的工程实践。
一、先把问题说清楚:偶发失败通常不是「测不稳」,而是「不可观测」
偶发失败常见三类。
- 等待条件写错。页面还在动画或请求未完成,断言已经拍板。
- 环境噪声。广告、统计、客服 SDK、第三方字体,拖慢或改写 DOM。
- 真实竞态。产品代码在并发下偶发坏掉,测试只是碰巧撞上。
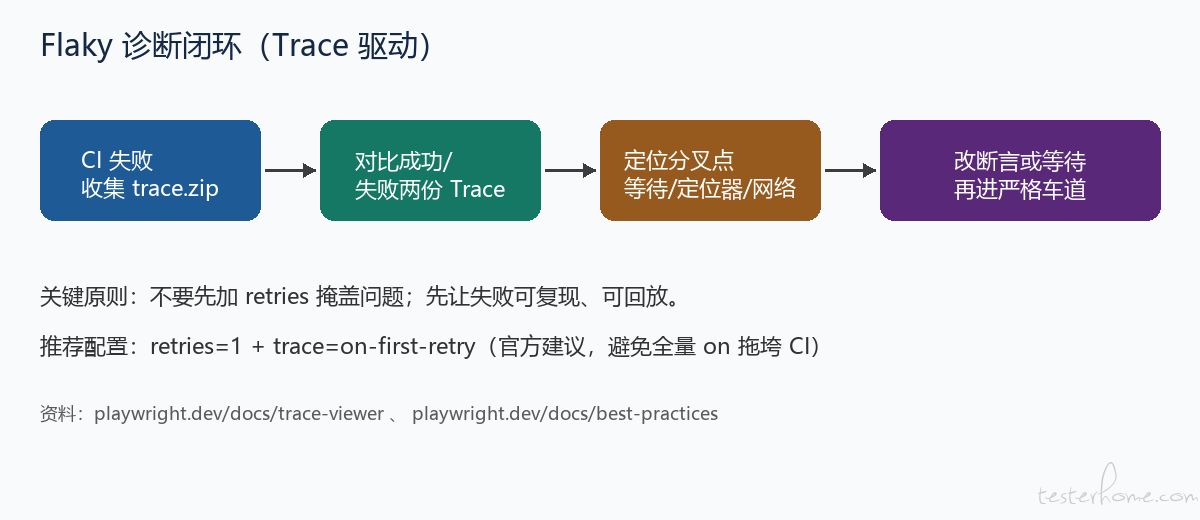
如果没有 Trace,这三类在日志里长得很像,都是 timeout。团队只能赌运气。Playwright Trace Viewer 的价值在于把时间轴、DOM 快照、网络请求叠在一起,失败瞬间可以回放,而不是只盯一行报错。
官方建议在 CI 上用 retries: 1 配 trace: 'on-first-retry'。不要默认 trace: 'on',全量开 Trace 很重。本地排查再用 --trace on 或 UI Mode。
// playwright.config.ts
import { defineConfig } from '@playwright/test';

export default defineConfig({
  retries: process.env.CI ? 1 : 0,
  use: {
    trace: 'on-first-retry',
    // 没有 retries 时可用 retain-on-failure
    // trace: 'retain-on-failure',
  },
  forbidOnly: !!process.env.CI,
  workers: process.env.CI ? 1 : undefined,
  globalTimeout: 60 * 60 * 1000,
});
判断标准很简单:一次失败之后,你能不能在 10 分钟内指出「分叉点」。指不出,就先别加 retries,先把制品留住。
二、等待策略要分层,sleep 只能当急救
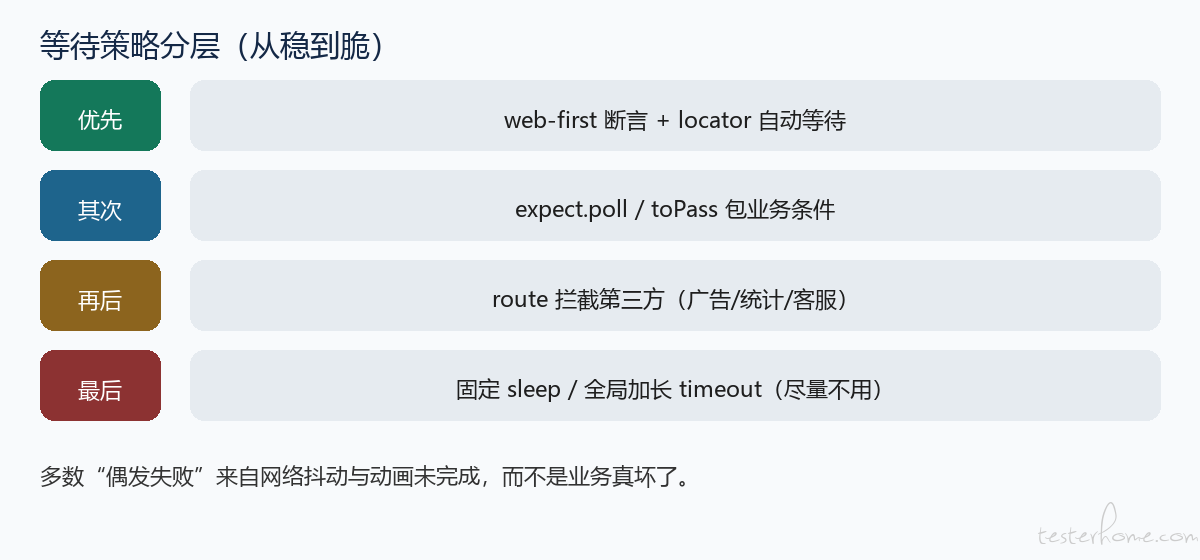
优先顺序建议这样排。
- 用 Playwright 的 web-first 断言和 locator 自动等待。
toBeVisible、toHaveText、toBeEnabled比手写 waitForTimeout 稳。 - 业务条件用
expect.poll或toPass包起来,表达「最终一致」,而不是「睡 2 秒」。 - 与业务无关的第三方请求直接
route.abort(),广告和统计尤其该拦。 - 固定 sleep、无脑加长 timeout,只允许临时止血,并挂 issue。
一个常见改法如下。
// 差:固定睡
await page.click('text=提交');
await page.waitForTimeout(3000);
await expect(page.getByText('提交成功')).toBeVisible();

// 好:等状态本身
await page.getByRole('button', { name: '提交' }).click();
await expect(page.getByRole('alert')).toContainText('提交成功');
第三方噪声可以这样收口。
await page.route(/google-analytics|hotjar|intercom|sentry/, (route) => route.abort());
注意:支付、登录这类业务依赖接口不要整域掐死,应 mock 具体路径。
三、门禁要拆成双车道,隔离必须可审计
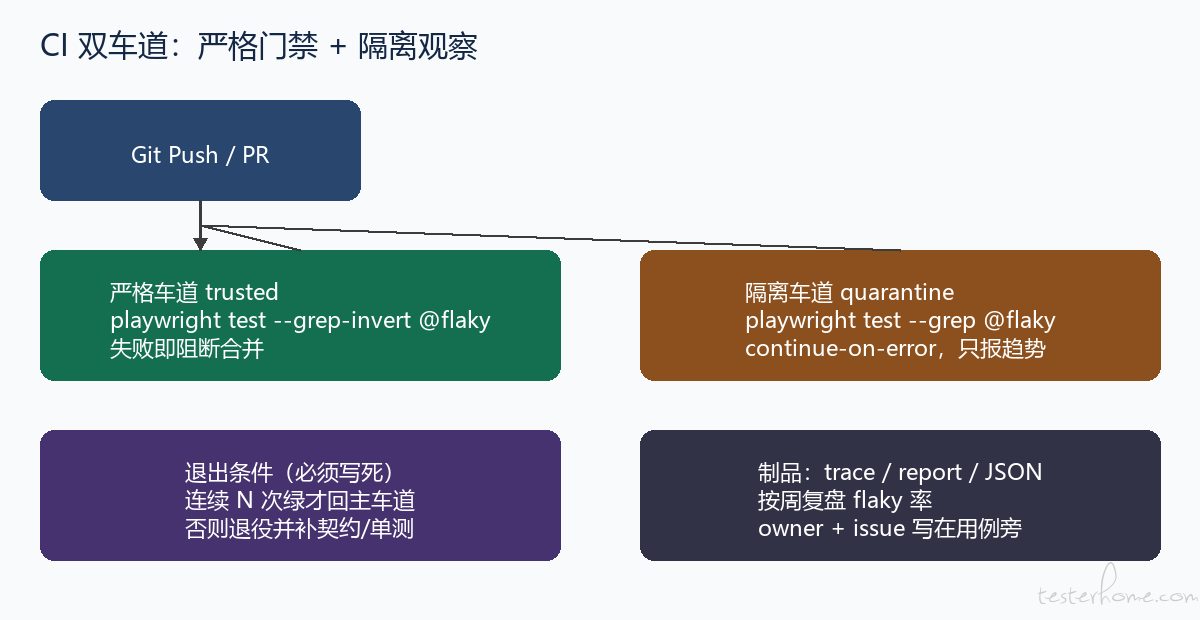
偶发失败一旦进主门禁,会逼团队做坏选择:要么阻塞所有人,要么删测试。隔离(quarantine)是第三条路。关键不是「先跳过」,而是「继续跑、但不挡合并,并且有退出条件」。
推荐做法。
- 用例打
@flaky,旁边写 owner、issue、起始日期。不要匿名 skip。 - 严格车道跑
--grep-invert @flaky,失败阻断合并。 - 隔离车道跑
--grep @flaky,continue-on-error: true,只产报告。 - 每周看隔离车道趋势。连续 N 次(例如 10 次)全绿,才允许回严格车道;长期不稳就退役,把覆盖补到契约测试或单测。
// QUARANTINE owner:@checkout-team issue:#4821 since:2026-10-01
test('checkout completes under load @flaky', async ({ page }) => {
  // ...
});
# 概念示例,按你们的 CI 改写
jobs:
  trusted:
    runs-on: ubuntu-latest
    steps:
      - run: npx playwright install chromium --with-deps
      - run: npx playwright test --grep-invert @flaky
      - uses: actions/upload-artifact@v4
        if: failure()
        with:
          name: trusted-artifacts
          path: |
            playwright-report/
            test-results/

  quarantine:
    runs-on: ubuntu-latest
    continue-on-error: true
    steps:
      - run: npx playwright test --grep @flaky --retries=2
      - uses: actions/upload-artifact@v4
        with:
          name: quarantine-artifacts
          path: |
            playwright-report/
            test-results/
CI 上建议只装真正用到的浏览器。例如只用 Chromium 就装 Chromium,能明显省时间和磁盘。Linux runner 通常更便宜也更稳。
四、一次完整排查路径(可直接套进周会)
假设「提交订单」在 CI 上每周翻车两三次。
- 打开失败那次的
trace.zip,对齐成功用例的 Trace。 - 看分叉点前 1 到 3 秒。常见是按钮可点但接口 499/超时,或 toast 已出现又被路由切走。
- 归类。
- 等待问题,改断言。
- 第三方噪声,加 route。
- 产品竞态,提缺陷,测试先隔离并写退出条件。
- 隔离时必须带 issue。没有 owner 的
@flaky视为流程失败。 - 修复后在隔离车道观察,达标再回严格车道。
这套路径比「再重跑一遍」贵一点,但省下的是整条研发流水线的信任。
五、和国内团队现状的对齐建议
如果你们还处在「E2E 刚进 CI」阶段,不要一上来追求 100% 稳定。更务实的目标是。
- 严格车道周失败率可解释(每次失败都能指出原因类型)。
- 隔离车道有清单、有 owner、有周复盘。
- Trace 制品默认保留失败样本,至少 7 天。
- 禁止无注释的
waitForTimeout合入主干。
技术含量不在名词,而在约束。retries、quarantine、Trace 都只是工具。真正决定质量的是「失败后你能不能复盘,隔离后你能不能退出」。
参考
- Playwright Trace Viewer
https://playwright.dev/docs/trace-viewer - Playwright Best Practices
https://playwright.dev/docs/best-practices - Playwright CI
https://playwright.dev/docs/ci - Quarantine Flaky Tests in CI(工程化隔离实践)
https://www.javascript-testing.com/modern-javascript-test-strategy-pyramid-design/flaky-test-mitigation/quarantining-flaky-tests-in-ci/ - Playwright Retries and Flaky Test Handling(2026 指南)
https://qaskills.sh/blog/playwright-retries-flaky-test-handling-guide
(配图为本文示意图,便于评审与对内宣讲。落地时请以你们仓库真实配置为准。)