AI测试 (评论放了近期 agent 的学习笔记)模型 api 调用好简单哦?先让系统会 “说话”

进入 AI 时代,Appium 自动化终于可以,不再只做那些花里胡哨的 “换皮” 工作了。
人懒的不行,下面就让 AI 来写吧。。 不是凭空想的,是已经运行了数千个小时的框架,详细的就不放出来了。
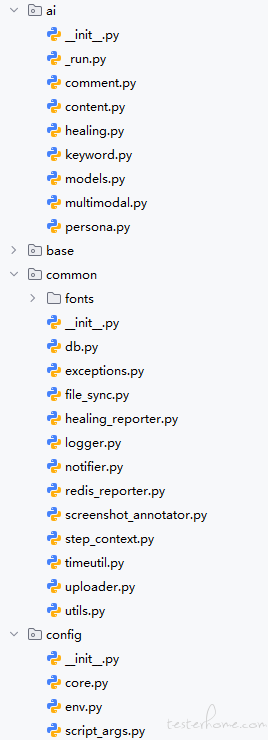
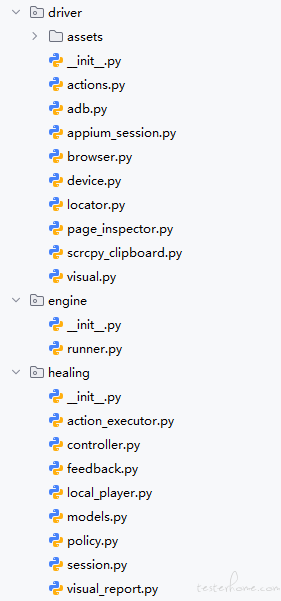
不是把原来的脚本接上一个模型,就变成了智能自动化。很多系统改造都有一个更基础的问题:系统现在的行为,能不能转换成 Agent 能理解的语言描述。
真正重要的是两件事:
- 框架的 “手脚” 有没有搭好,能不能稳定地操作、等待、定位、验证和恢复。
- 系统的行为有没有表达清楚,Agent 能不能看懂当前状态、正在执行什么、为什么失败、下一步应该怎么处理。
所以这份文档用五章讲清楚:
- 如何把系统行为转换成语言描述。
- 如何用框架级 Agent 处理通用问题。
- 如何把公共能力搭好。
- 如何用业务级 Agent 处理具体判断。
- 如何记录和观察整个运行过程。
不涉及具体业务,只讨论通用的 Android Appium 自动化框架,以及框架级 Agent 和业务级 Agent 应该怎么接进来。
一、先让系统行为变得可描述
1.1 为什么要做这一步
以前很多自动化代码只关心 “调用哪个 API”:查找元素、点击、等待、返回、截图。对机器来说这些动作可以执行,但对 Agent 来说信息还不够。
Agent 还需要知道:
- 当前处于什么状态。
- 这一步的目的是什么。
- 这个动作依赖什么前置条件。
- 动作完成后应该出现什么结果。
- 失败以后允许怎么处理。
所以系统需要把运行中的行为转换成一组稳定的语言描述,而不是只留下零散的底层调用。
1.2 一次操作应该描述什么
可以把一次操作描述成:
当前状态:已经进入设置页面
准备动作:点击确认按钮
动作目的:提交当前设置
预期结果:回到主页面
失败处理:先尝试备用定位,仍失败时进入框架级 Agent
with driver.step(...)、步骤名称、intent、前置状态、预期结果和异常信息,合在一起就是系统行为的语言化表达。
这不只是为了日志,也是为了让 Agent、人工排查工具和后续的自动分析都能理解系统正在做什么。
1.3 这种改造不只适用于 Appium
很多系统都存在同样的问题:代码能运行,但行为说不清楚。要接入 Agent,通常都要先补上这些信息:
- 统一的步骤或事件。
- 清楚的动作意图。
- 明确的输入和输出。
- 可判断的成功条件。
- 结构化的失败原因。
- 可以串起来的执行上下文。
Appium 只是一个很直观的例子。网页自动化、接口编排、桌面自动化和后台任务,也都可以用同样的方式改造。
二、框架级 Agent:让系统自己恢复
2.1 先解决什么问题
Appium 脚本经常遇到这些情况:
- 按钮晚一点出现。
- 弹窗挡住了目标元素。
- 页面还没有加载完成。
- 元素的文字、层级或资源 ID 发生变化。
- 同一个操作,第一次失败,第二次又成功。
如果每个脚本都自己处理,代码会越来越乱。这里不能只在脚本外面再包一层模型,而是要先把框架的基础能力做好,再把 Agent 接到正确的位置上。
2.2 步骤要写清楚 “想做什么”
脚本不应该只有 XPath,还要写清楚这一步的意图。写法可以参考 BDD:
Given 当前已经进入设置页面
When 点击“确认”按钮
Then 应该回到主页面
对应的代码可以这样写。实际项目中,每个完整步骤都放在 with driver.step(...) 里面,这样日志、耗时、异常和 job_id 才能统一记录:
with driver.step("点击确认按钮", "Click the confirm button"):
    confirm_button = driver.smart_find(
        locators=[
            (AppiumBy.ACCESSIBILITY_ID, "confirm"),
            (AppiumBy.ID, "dialog_confirm"),
            (AppiumBy.XPATH, "//*[@text='Confirm']"),
        ],
        timeout=5,
        intent=("点击确认按钮", "Click the confirm button"),
        critical=True,
    )
    confirm_button.click()

with driver.step("确认回到主页面", "Confirm returning to the main page"):
    main_page = driver.smart_find(
        locators=[
            (AppiumBy.ACCESSIBILITY_ID, "main_page"),
            (AppiumBy.ID, "main_content"),
        ],
        timeout=8,
        intent=("确认回到主页面", "Confirm returning to the main page"),
    )
这里有三个重点:
-
locators:按优先级准备多个查询方式。 -
intent:说明这一步的真实目的,方便日志和 Agent 理解。 -
critical=True:找不到时允许进入框架级自愈。
with driver.step(...) 也很重要:
- 一段完整操作对应一个清晰的步骤。
- 步骤开始和结束会被记录。
- 发生异常时,可以知道具体是哪一步失败。
- 步骤会自动关联当前的
job_id。 - 自愈过程发生在步骤内部,但步骤最终仍要根据原目标验证结果判断成功或失败。
所以一次完整操作通常是:
with 阶段开始
  → 查询元素
  → 执行动作
  → 验证结果
  → 必要时进入 Agent 自愈
  → with 阶段结束并记录结果
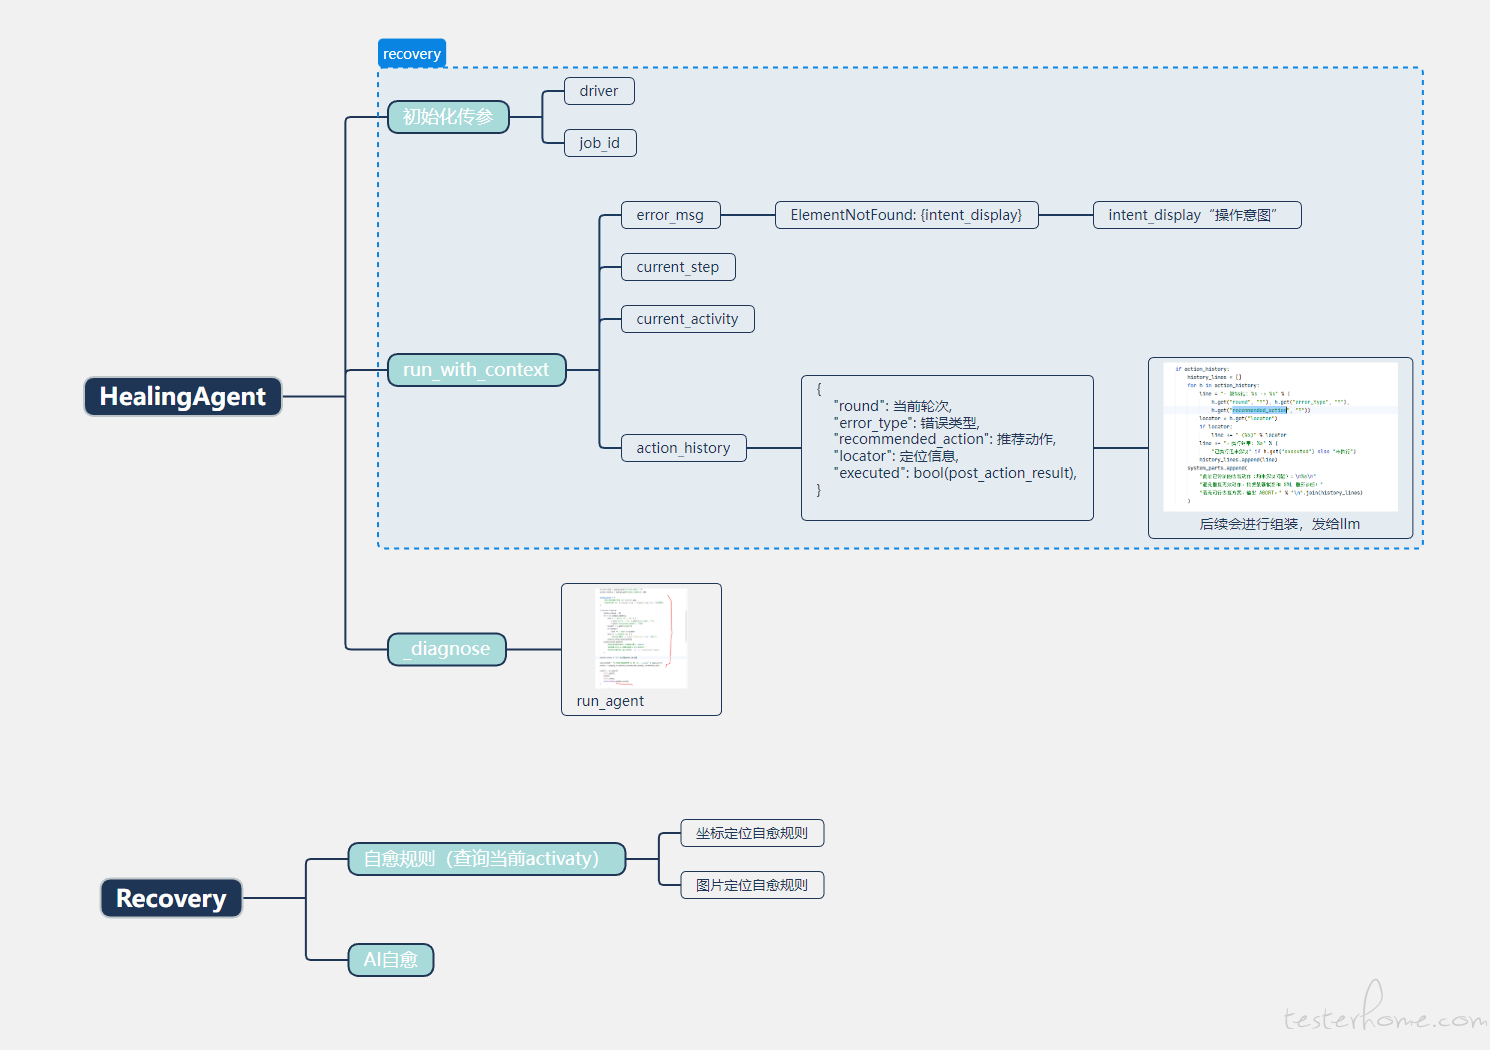
2.3 框架级 Agent 怎么工作
原始元素找不到
  → 尝试备用定位方式
  → 扫描本地恢复规则
  → 仍然失败时收集截图和页面摘要
  → Agent 判断页面出了什么问题
  → 策略层检查建议是否安全
  → 执行器点击、等待或返回
  → 重新执行原来的查找
  → 验证原始目标是否恢复
Agent 返回的是建议,不是直接操作。例如:
RecoverySuggestion(
    action="click",
    locator_strategy="accessibility_id",
    locator_value="close_dialog",
    confidence=0.91,
)
Agent 不自己调用 click()。真正的点击由执行器完成,点击以后还要重新查找原来的 “确认按钮”。
2.4 这里做了哪些框架改造
- Driver 统一提供
smart_find()和smart_find_all()。 - 一个目标支持多个定位方式,按顺序尝试。
- 关键步骤可以自动开启自愈。
- Agent 只分析截图、页面摘要和失败原因。
- 策略层判断置信度和动作是否允许。
- 执行器负责真正操作手机。
- 外层重新执行原目标并验证结果。
- 恢复成功后才保存可复用规则。
- 规则执行发生真实异常时才删除,未命中不等于失效。
这样,业务脚本只需要表达 “点击确认按钮”,不需要知道弹窗怎么关、页面怎么恢复。Agent 不是替代框架,而是建立在这些基础能力之上。
2.5 框架级 Agent 的边界
框架级 Agent 不应该:
- 自己决定完整业务流程。
- 直接持有 Driver 并随意点击。
- 自己保存规则。
- 把上一次失败的上下文带到下一次无关失败。
- 把 “执行了恢复动作” 当成 “业务已经成功”。
三、公共能力:先把框架的手脚搭好
3.1 Driver 统一操作手机
业务层不要到处直接写 Appium 调用,统一通过 Driver:
- 连接设备和管理 Appium 会话。
- 点击、输入、滑动、返回、等待。
- 查找一个或多个元素。
- 获取页面源码和截图。
- 调用模板匹配和视觉识别。
- 进入元素级自愈。
Driver 是统一入口,但不要把所有代码都堆进一个大类。具体能力仍然独立,Driver 只负责组合。
3.2 元素定位要有备用方案
不要只依赖一个 XPath。一个目标可以准备多个定位方式:
locators = [
    ("accessibility_id", "confirm"),
    ("resource_id", "dialog_confirm"),
    ("xpath", "//*[@text='Confirm']"),
]
一般按这个顺序处理:
- 先用最稳定的定位方式。
- 失败后尝试备用定位方式。
- 仍然失败,再判断是否需要自愈。
- 自愈完成后,重新执行原来的目标。
- 原目标验证成功,才算真正成功。
视觉能力也按层使用,不把 OCR 作为定位方案:
语义定位 → 页面源码 → 模板匹配 → 多模态模型
OCR 不作为可靠的元素定位手段。视觉模块只返回候选结果,不直接点击。坐标在识别层使用 0~1 的相对值,真正点击前再换算成设备像素。
3.3 公共包大致怎么搭
公共包不是把所有东西放在一起,而是把多个脚本都会用到的基础能力收好:
base/      公共流程和参数
driver/    手机操作、定位、截图和视觉
engine/    任务运行、重试和资源管理
platform/  页面差异和应用适配
healing/   框架级自愈
ai/        Agent 和模型调用
store/     规则及其他持久化
common/    配置、日志、步骤和上报
公共包主要解决这些问题:
- 所有脚本用同一种方式找元素、点击、等待和记录步骤。
- 所有任务用同一种方式创建、重试和释放资源。
- 所有 Agent 用同一种方式处理模型失败和结构化输出。
- 所有日志都能关联到同一个
job_id。 - 规则、截图、错误和 AI 调用可以统一留痕。
公共包不要反过来依赖某个具体脚本,否则公共代码最后还是会变成业务代码的集合。Agent 能不能发挥作用,首先取决于这些公共能力是否稳定;如果点击、等待、定位、截图和步骤记录本身就不可靠,接入模型只会把问题变得更难查。
四、业务级 Agent:处理具体流程判断
4.1 和框架级 Agent 有什么区别
框架级 Agent 处理通用页面异常,例如弹窗、元素变化和页面加载问题。
业务级 Agent 处理当前流程自己的判断,例如:
- 页面内容是否符合当前条件。
- 一段文本是否值得继续处理。
- 截图里有哪些目标内容。
- 需要生成什么文本。
- 关键词如何扩展。
两者不要混在一起。
业务级 Agent 的前提,是脚本本身要有清楚的行为表达。脚本不能只是很多零散的点击、滑动和等待;每一步都应该能说清楚:
- 当前处于什么页面或状态。
- 这一步准备做什么。
- 为什么要做这个动作。
- 做完以后应该看到什么结果。
- 没有达到预期时,是跳过、重试、进入自愈,还是结束任务。
这就是让脚本 “行为可见”。行为越清楚,Agent 越容易判断;日志越完整,后面越容易回放和排查。
4.2 业务级 Agent 怎么调用
脚本负责准备输入,Agent 返回结构化结果:
result = content_agent.scan_use_keyword(
    screenshot_b64=screenshot_b64,
    keyword=keyword,
)

if result is None:
    logger.warning("内容识别失败,跳过本轮")
    return

for item in result.items:
    x = int(item.x * driver.screen_width)
    y = int(item.y * driver.screen_height)
    driver.tap(x, y)
Agent 只负责识别,截图、坐标换算和点击都由调用方完成。
文本判断也是一样:
evaluation = comment_agent.evaluate(comment_text)

if evaluation is None:
    logger.warning("评论判断失败,跳过本条")
    return

if evaluation.interested:
    handle_interested_comment(comment_text)
4.3 输出和失败要分开
影响流程的结果,不要只返回一句自然语言。建议使用:
- Pydantic 模型。
- 布尔值。
- 枚举。
- 受限数字。
- 具名列表模型。
调用方直接使用属性,不要再把结果转换成字典。
| 情况 | 结果 |
|---|---|
| 模型失败或没有有效输出 | None |
| 模型正常运行但没有候选 | 空列表或空模型 |
| 模型正常判断为否定 | 结构化结果中的 False
|
| 调用前就不满足条件 | skipped |
4.4 业务级 Agent 是否需要对话历史
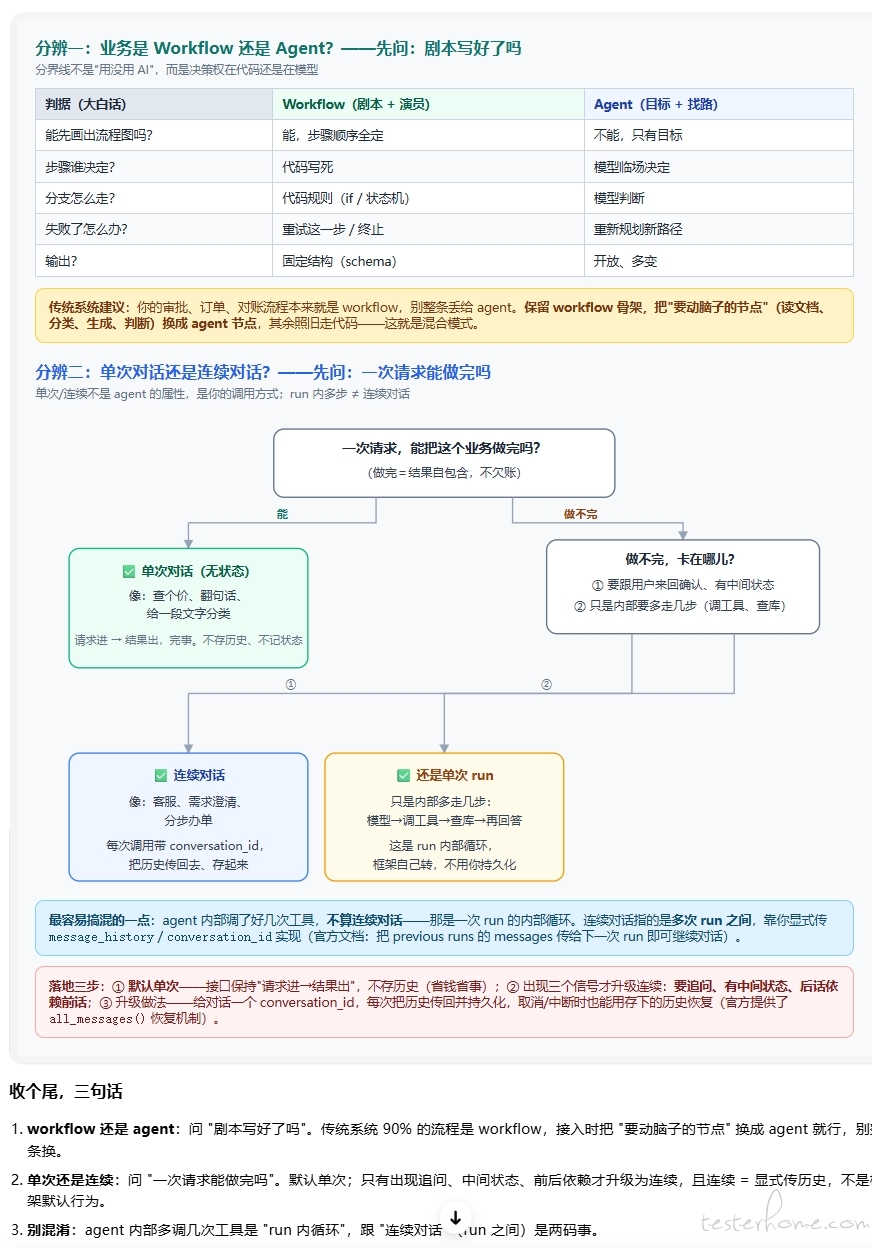
一次脚本运行里,很多 Agent 调用互不相关,所以默认不使用连续对话:
- 不读取上一次模型消息。
- 不把前一次结果传给下一次模型。
- 每次调用独立执行。
- 每次调用仍然记录到数据库。
只有确实需要上下文的流程,才额外传 conversation_id。历史范围限定为:
job_id + agent_name + conversation_id
不能因为属于同一个 Job,就把所有业务级 Agent 的消息拼在一起。
五、日志、持久化和可观测性:让系统行为能被看见
一次脚本运行使用一个 job_id,关联:
- 步骤日志。
- Agent 调用。
- 规则命中。
- 截图和事件。
- 最终执行状态。
数据库只增加一张 AI 消息表:
ai_conversation_messages
建议包含:
| 字段 | 作用 |
|---|---|
id |
主键 |
job_id |
一次脚本运行的编号 |
agent_name |
哪个 Agent 被调用 |
operation |
这次调用做什么 |
conversation_id |
连续对话编号,没有时为空 |
sequence_no |
当前 Job 内的顺序 |
role |
请求、响应或错误 |
message_json |
连续对话需要的原生消息 |
input_summary |
脱敏后的输入摘要 |
output_json |
脱敏后的输出 |
model_name |
使用的模型 |
status |
成功、失败或跳过 |
error_message |
失败说明 |
duration_ms |
调用耗时 |
created_at |
创建时间 |
当前所有 Agent 默认无状态,不加载历史。以后只有显式传入 conversation_id,才读取相关消息并传给模型。
不要把截图 Base64、完整页面源码、Token、Cookie、密码和未脱敏隐私信息写入表里。
数据库写入失败时,记录日志即可,不要改变 Agent 的结果,也不要直接让自动化任务中断。
5.1 日志至少记录什么
每个关键步骤至少记录:
- 步骤名称。
- 开始、结束和耗时。
- 成功或失败。
-
job_id。 - 错误类型。
- 必要时的截图或页面摘要。
如果 Agent 参与了恢复,最好能串起:
哪一步失败
  → 看到了什么页面
  → Agent 给了什么建议
  → 策略是否允许
  → 实际执行了什么
  → 原目标是否恢复
  → 规则是否保存或删除
截图上传和事件上报可以异步做。上报失败不能影响主流程。
3.4 推荐目录:让 “手脚” 和 “判断” 分开
framework/
├─ base/       公共流程和参数
├─ platform/   页面差异
├─ engine/     任务运行、重试和资源管理
├─ driver/     Appium、设备、定位和视觉入口
├─ healing/    自愈会话、策略、执行和反馈
├─ ai/         Agent、模型调用和消息服务
├─ store/      规则和持久化
├─ common/     配置、日志、步骤和上报
└─ tests/      关键节点测试
拆分的标准很简单:职责是否稳定、能否单独测试、是否会被多个模块复用。
可以把整个框架简单理解成两部分:
-
driver、engine、common、store、healing是框架的 “手脚”,负责执行、恢复、记录和保存。 -
ai下面的 Agent 是 “判断能力”,负责识别、分析、选择和生成建议。
Agent 不应该直接代替 “手脚” 去操作手机;框架也不应该把所有判断都写死在脚本里。两部分边界清楚,系统才容易继续演进。
3.5 推荐落地顺序:先把基础能力做好,再接 Agent
- 先稳定 Driver、步骤和任务运行层,让手机操作有统一入口。
- 再统一定位、等待、动作和结果验证,让脚本行为变得清楚。
- 然后把日志、截图、错误和
job_id串起来,让一次运行可以回放。 - 再整理本地规则和框架级自愈,让常见问题先由框架处理。
- 然后统一业务级 Agent 的输入、输出和失败语义。
- 最后只针对确实需要的地方增加连续对话和持久化。
不要一开始就把所有东西做成一个 “大平台”,也不要把 “接入模型” 当成目标。先把框架的手脚和脚本的行为理清楚,再逐步增加 Agent 能力,后面才容易维护。