自动化工具 E2E 选型:别问「哪个工具更强」,先回答这五个问题

选型文章最容易写成两种:一种是「我家最好」,一种是拿别人的体感当自己的结论。这篇我努力避开这两条,尽量把四条路线的形状和代价摆出来,最后给五个问题 —— 你答完基本就知道该选哪个了。
先说清楚:这四条路线都能跑测试。「打开页面 → 点一下 → 断言文本」用哪个都写得出来。所以比较的重点从来不是「能不能」,而是代价谁承担。
一、四条路线各自的形状
1)Playwright 裸写
就是直接用 Playwright 的库和 Test Runner 写脚本。
- 官方能力:多语言(JS/TS、Python、Java、.NET)、跨浏览器(Chromium / Firefox / WebKit);
- 官方自带 codegen:录下你在浏览器里的操作就能生成测试,并且按 role、text、test id 的优先级挑定位器,遇到多个匹配会自动把定位器改得更唯一;还支持保留登录态和 Inspector 调试。
代价:codegen 只是起点,录出来的脚本仍要人维护;用例库、回归编排、失败证据(截图 / console / network)、报告、历史记录,这些都得自己搭 —— 而这恰恰是「跑一次」和「能天天跑」的差距。
适合:有工程能力、要细粒度控制、把 E2E 当代码直接写进 CI 的团队。
2)Cypress
官方定位已经不只是跑测器,而是把端到端、组件测试、无障碍检查、覆盖率串成一个工作流(Cloud 是配套的商业产品线)。前端团队上手快,组件测试和调试体验是招牌,跨域场景官方给了 cy.origin 方案。
需要注意的是,官方自己在「Trade-offs」页明确列了架构带来的取舍:它跑在浏览器内部(这是调试体验好的原因,也是很多限制的来源),其中一条写的就是「不能同时打开多个浏览器」。这不是 bug,是架构选择的必然结果 —— 选它就得接受。
适合:以 web 前端行为为主、团队熟 JS、看重组件测试与调试体验。
3)商业录制回放平台
可视化录制 + 云端(或托管)执行 + 团队报表与权限。
通常的卖点:零搭建、不写代码也能录、并行执行、团队可见。
通常的代价:执行环境和数据往往要出内网;按座位或跑量计费,长期成本随团队规模涨;复杂断言和自定义逻辑受产品边界限制,遇到平台不支持的只能等。
适合:要快速铺开、有预算、被测系统能上云、不打算自建基础设施的团队。
这一节我只描述「这一类产品的一般特征」,不点名对比具体厂商 —— 没有实测就拿营销词做对比,是选型文最容易翻车的地方。
4)本地 E2E 工具(我现在用的就是这一类)
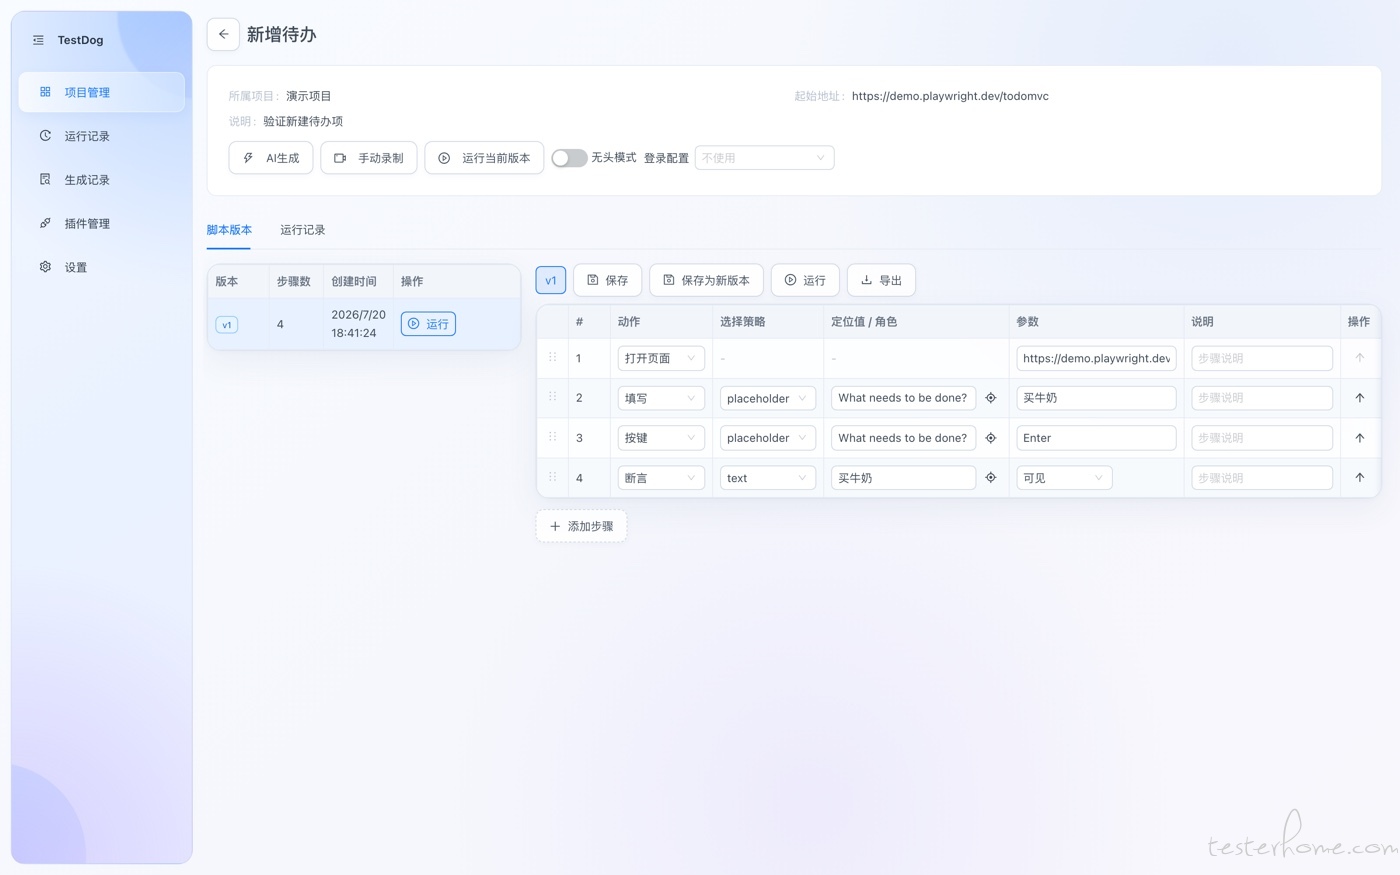
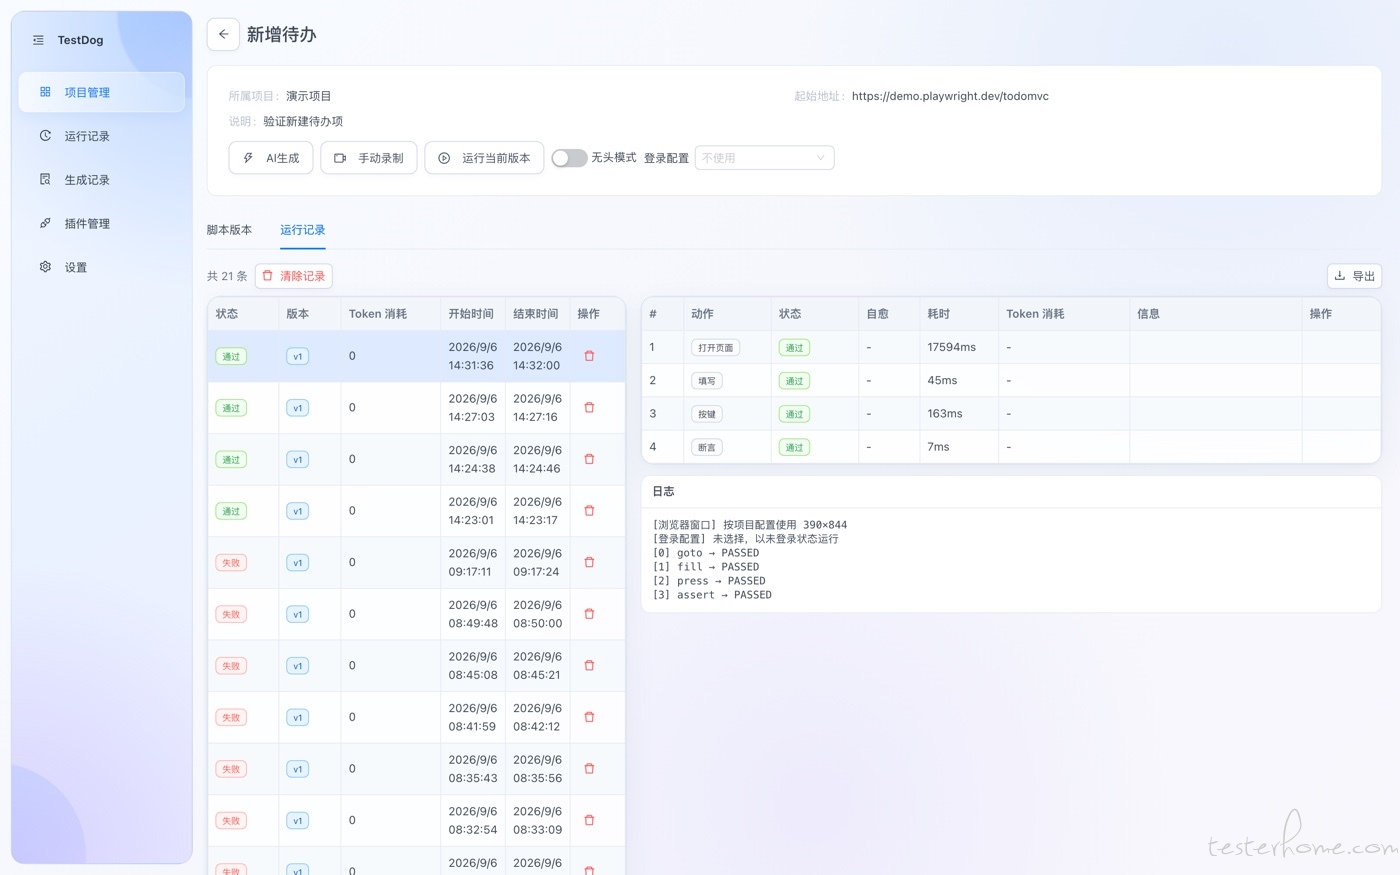
形状:把「生成 / 录制 → 确认 → 存成脚本 → 确定性回放」做成一个本地桌面应用,底层还是 Playwright 在跑。
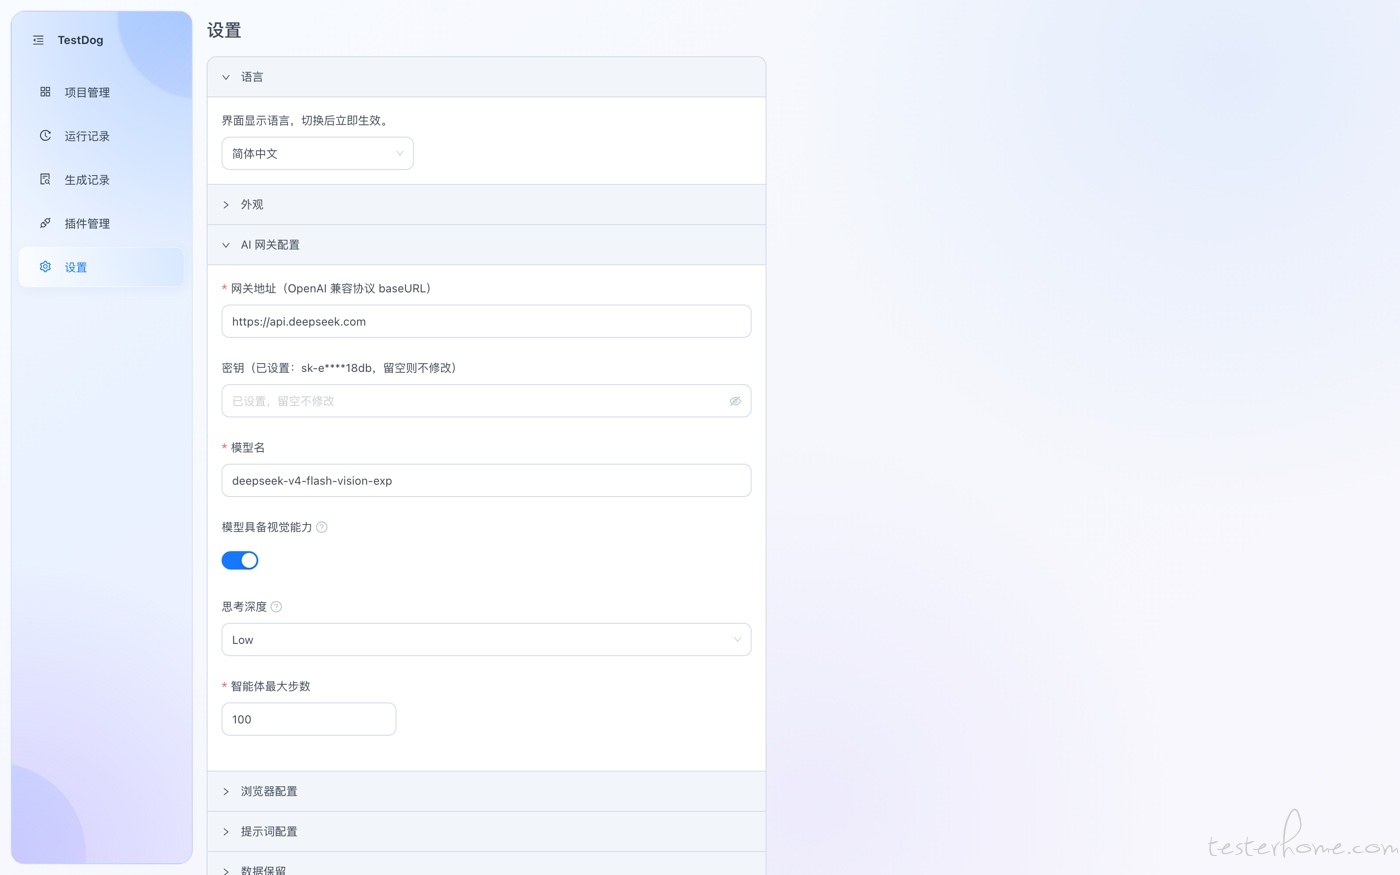
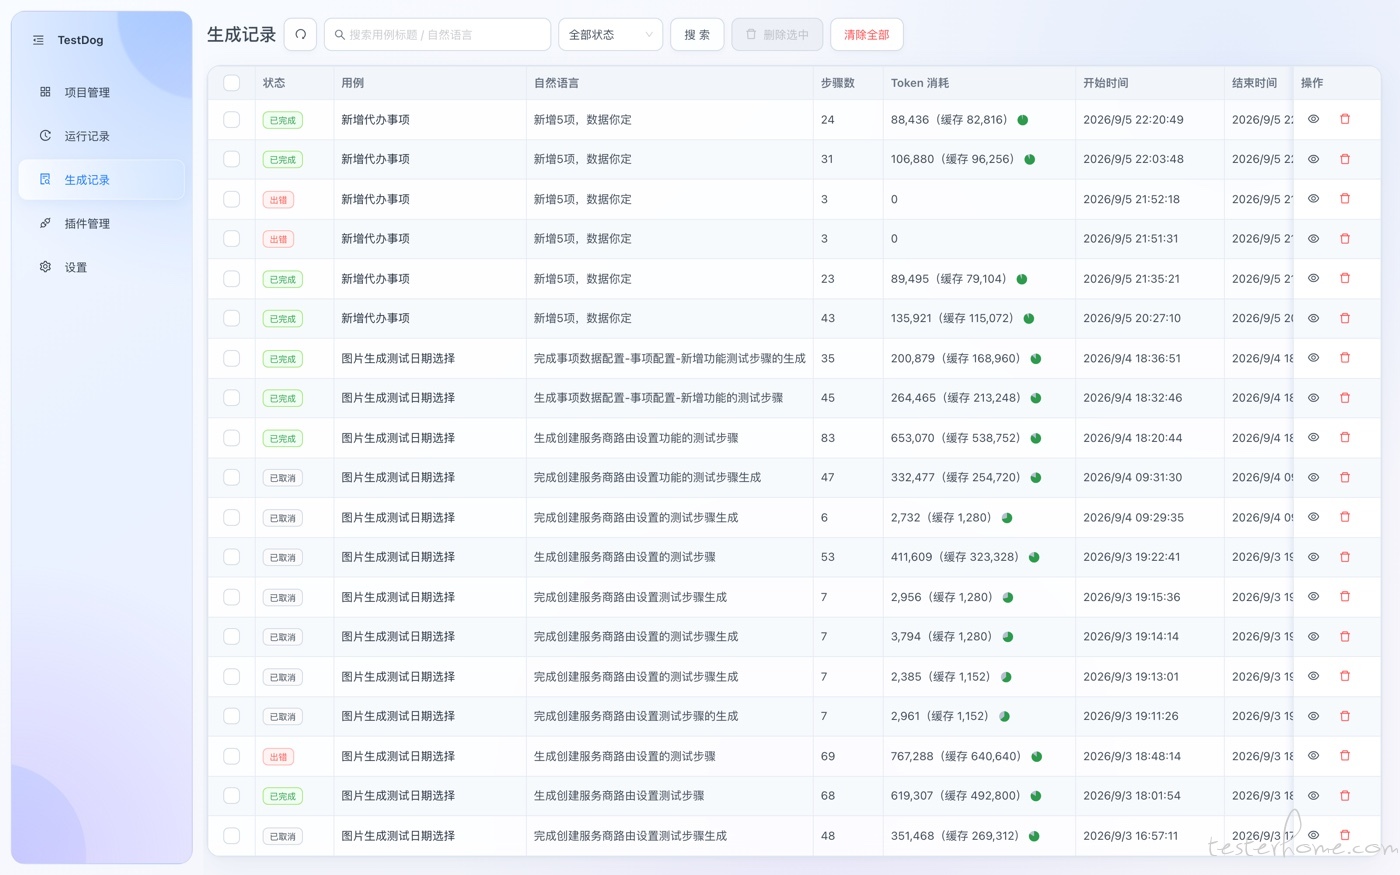
- 两条产线:自然语言生成(先出预拆分计划:测试意图、前置条件、数据约束、验收目标与必验项,确认后才执行),或 codegen 录制后解析成结构化步骤;
- 脚本是可编辑的语义定位器步骤,不是黑盒录像;
- 回放确定性,不调模型(Token 消耗 0);定位器失效才请求模型自愈,而且上传 / 滚动 / 断言不走自愈;
- 断言覆盖 UI / 接口 / WebSocket;失败自动存截图并采集 console 与 network;
- 组件库(Ant Design / Element / Vant / MUI)的下拉、日期、级联用语义动作插件,治「点了但没选上」;
- 资产可携带:用例导出成
.testcase,含上传时连文件一起打包,能进 Git、也能让编程 agent 直接生成。
代价:跑在自己机器上 —— 没有托管调度、并发队列和团队权限;多机器协作要靠文件和 Git;生成质量取决于你配的模型。
二、一张对比表
| 维度 | Playwright 裸写 | Cypress | 商业平台 | 本地工具 |
|---|---|---|---|---|
| 定位器从哪来 | 手写 / codegen | 手写 | 录制(平台私有格式) | 生成或录制,落为语义定位器 |
| 执行确定性 | 完全确定 | 完全确定 | 通常确定 | 完全确定 |
| AI 参与 | 无 | 无 | 平台内(黑盒) | 仅生成 + 自愈,可审查 |
| 断言能力 | 全部自己写 | web 断言 + 网络拦截 | 平台提供 | UI / 接口 / WebSocket 内置 |
| 复杂组件 | 自己处理 | 自己处理 | 看平台覆盖 | 语义动作插件 + 预设 |
| 资产形态 | 代码 | 代码 | 平台云端 |
.testcase 文件 |
| 数据位置 | 你的仓库 | 你的仓库(Cloud 可选) | 厂商云端 | 本地 SQLite |
| 成本结构 | 人力 | 人力 + 订阅 | 座位 / 跑量订阅 | 人力 + 模型调用(回放为 0) |
| 上手门槛 | 需工程能力 | 前端友好 | 最低 | 中等(要配网关) |
三、五个决定性问题
- 失败证据要落到哪里? 只要日志,还是要截图 + console + network + 历史?后者是平台级能力。
- AI 允许参与哪一段?「每次执行都要」就请先接受结果不可复现;只要「生成 + 救定位」,确定性回放才成立。
- 被测系统能不能上云? 不能,商业 SaaS 直接出局(除非有私有化部署)。
- 谁来维护定位器? 有专职测试开发,裸写可行;没有,就得考虑「录制 + 语义定位 + 只在失效时自愈」。
- 协作方式是什么? 多人多机用一套用例 → 需要托管服务或 Git 工作流;单人/小队 → 本地工具最省事。
四、什么情况下不该用本地工具
- 要的是单元测试、组件测试(那是 Vitest/Jest 和组件测试框架的地盘);
- 要多机并行、队列调度、全公司报表(那是托管平台或自建 CI 集群);
- 需要多语言 SDK(Java/Python 直接调库)而不是桌面应用;
- 有大量跨 iframe、跨多标签页的操作;
- 要把接口全部 mock 掉跑假数据回归(这类方案的价值恰恰建立在真实请求上);
- 团队不愿意在业务代码里加测试锚点 —— 定位器优先级再高,代码不给
data-testid也只能掉到末档。
五、它们通常是组合,不是替代
-
Playwright/Cypress做贴近代码层的验证(组件、集成、边界逻辑)——离开发者最近; - 本地 E2E 工具管回归资产:把主流程沉淀成可回放的用例,配证据与历史,让「每天跑一遍」变便宜;
- 商业平台负责跨团队可见性(如果确实需要),此时用例以文件导出再导入收敛。
一句话:写测试 ≠ 管测试资产。前者的瓶颈是表达力,后者的瓶颈是维护成本和可信度。
六、留个问题
你们团队最后选的是哪条路线?中间换过吗?我特别想听两类经历:
- 从录放平台换回代码的(或反过来)——当初是什么触发你换的?
- 踩过「AI 每次执行都参与」这个坑的 —— 结果不可复现这件事,你们是怎么发现的?
评论区聊聊,也给正在选型的同学一点真实参考。
参考链接:
- Playwright codegen:https://playwright.dev/docs/codegen
- Cypress Trade-offs:https://docs.cypress.io/app/references/trade-offs
- Cypress 跨域:https://docs.cypress.io/app/guides/cross-origin-testing
- 项目地址:https://github.com/xianyongwen/TestDog · 文档:https://softwing.top/testdog-doc/ · 社区:https://testerhome.com/opensource_projects/testdog