自动化工具 回放零 token、生成省着花:E2E 测试工具里我们压 token 成本的那些措施

一、先说那个让人放弃 AI 测试的问题
演示很惊艳,账单很难看。这是很多团队引入 AI 测试工具之后的真实路径:一句自然语言生成一条用例确实省事,但
- 一次生成消耗几十万 token;
- 每天跑一遍回归,如果每次都让模型「看着页面点」,成本随执行次数线性增长;
- 更糟的是模型卡在某个组件上反复试,你既拿不到结果,也在持续付费。
所以我们这边的第一原则不是「怎么让模型更聪明」,而是把模型放在一次性环节,把重复发生的事情交回确定性代码。下面按「哪一层省下的」来讲具体做了什么。
二、省得最多的一条:回放根本不调模型
这件事没有技术含量,但省的钱最多:
| 环节 | 调用模型 |
|---|---|
| 自然语言 → 步骤计划 | 一次 |
| 生成期逐步执行 | 是(工具循环) |
| 手动录制 | 否(走 Playwright codegen) |
| 普通回放 / 批量回归 | 否 |
| 定位器自愈 | 只在失败时 |
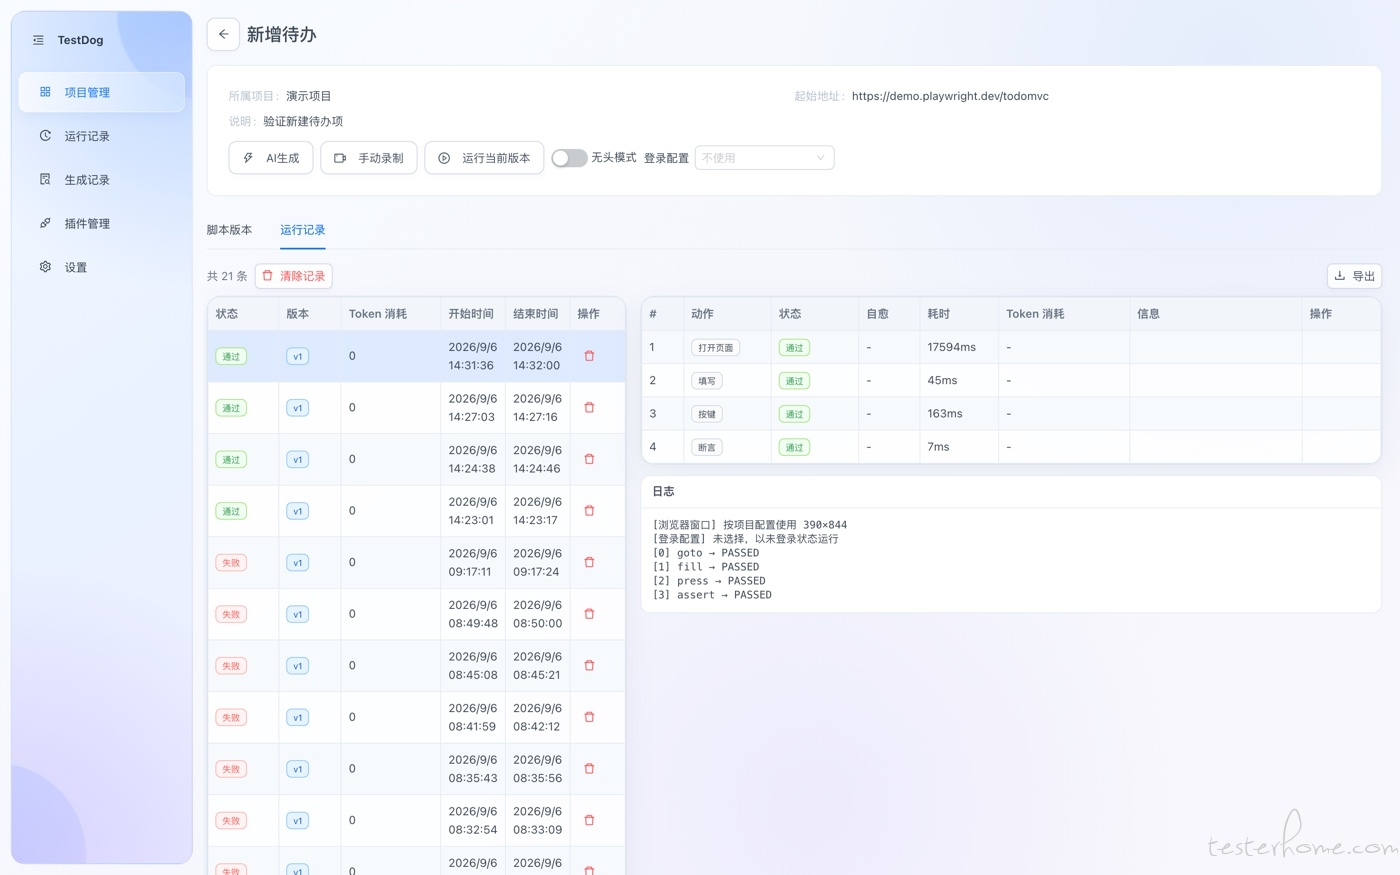
生成出来的脚本是结构化步骤(动作 + 定位策略 + 断言),回放由 Playwright 确定性执行 —— 跑一百遍也一样,不花费一个 token。运行记录里那一列「Token 消耗」常年是 0,只有触发自愈时才动。
三、让模型少干活:先计划,再执行
两个措施:
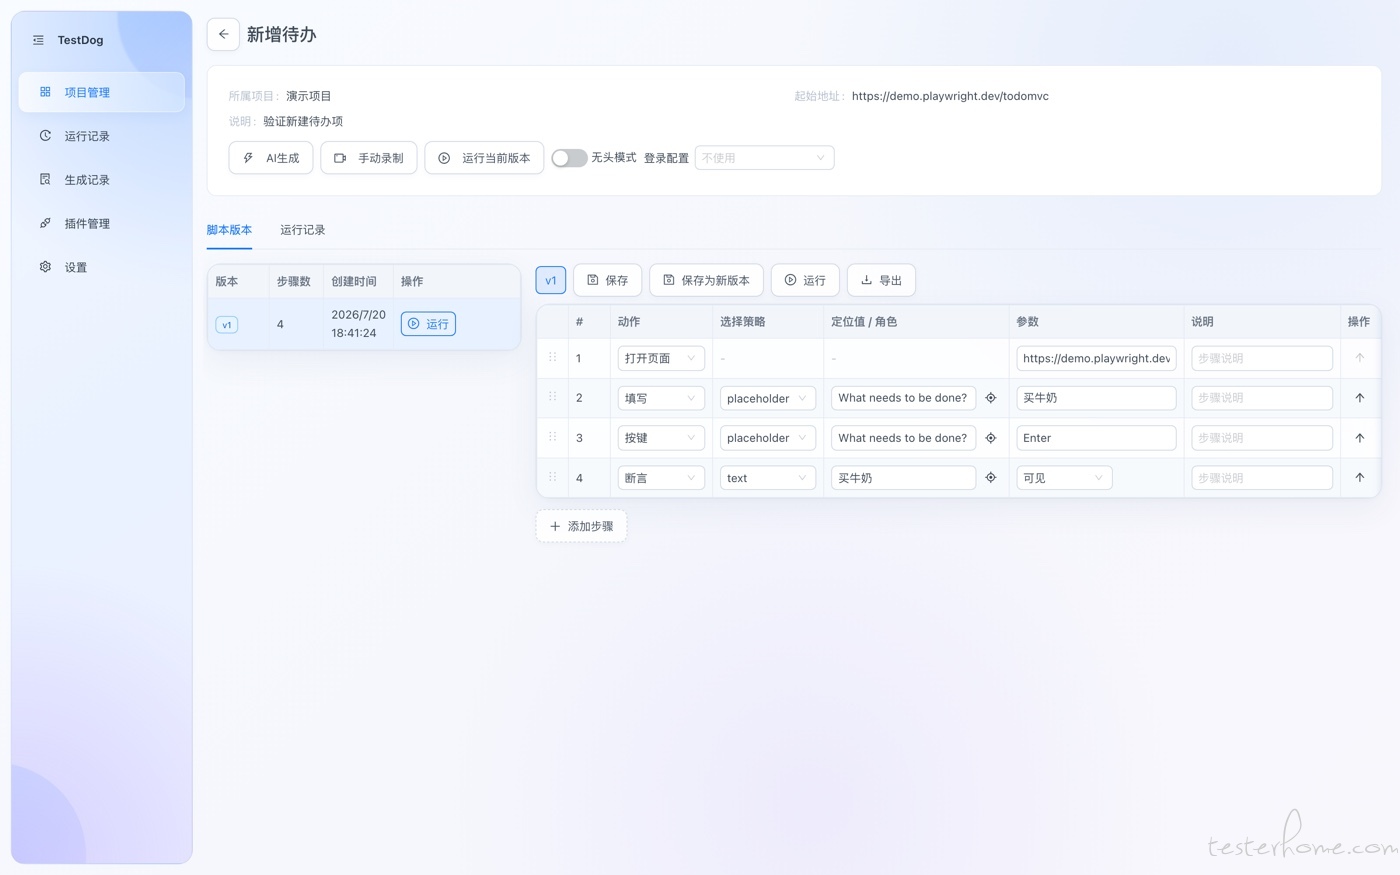
- 先生成计划再执行。用户描述先被拆成「有序步骤 + 验收意图(前置条件/数据/验收标准)」,人确认后才进入真实浏览器逐步执行。相比边做边猜,纯文本的计划便宜太多,也避免模型在半路上反复试探。
- 复合组件交给插件在页内闭环。组件库的下拉如果让模型一步步点(点触发器 → 找选项 → 点选项 → 确认),一次交互要好几轮调用;而插件用一个语义动作在页内闭环完成,模型只调用一次。
四、真正的主战场:别让上下文滚雪球
工具循环的成本 ≈ 上下文大小 × 轮数。所以省 token 的功夫大半花在上下文治理上。我们做了四件事:
1)状态类结果只保留最新一份。 快照、截图、接口响应这类结果,新的产生之后旧的就没价值了。所以它们各自占一个「状态槽」:同槽新结果回灌时,历史同槽消息原地降级成一行占位(「第 N 轮同槽结果已省略,请以最新为准」);新快照还能顺带让旧的结构树失效 —— 因为快照里已经带了新的元素编号。
截图也算同槽,这条是有意的:图片按张计价,一轮一张不回收,几十轮的账非常难看。
2)普通结果单行化。 非状态类工具结果超过 400 字符就只留头 200 + 尾 120,中间省略 —— 有用信息基本都在开头(状态/摘要)和结尾(错误/下一步提示)。
3)到线就压中间历史。 循环里每轮旁路看「上一轮主调用的输入 token」(直接读供应商回传的 usage,不做本地估算),超过阈值就:保住 system、首条 user、最近 3 轮的完整原文;中间正文压到一行;assistant 的工具调用参数做瘦身(长字符串截断,但 selector、key 这类短字段保留,能和旧结果对上)。顺带清掉已经不在上下文里的状态槽,避免悬空引用。
4)工作记忆替代原始轨迹。 还有一条更激进的:轮数或上下文大小到线时,把中间历史整体换成一份工作记忆——目标、已记录步数、最近若干步的关键字段、被省略的步数,末尾附一句「完整目标用 read_goal、完整脚本用 read_script」。
这份记忆本身有字数预算(装不下就停),每条步骤的字段也切片(输入值/期望值 160 字符、定位器 180 字符)。两个细节我很在意:
- 省略 ≠ 删除:需要原文可以按需去读,而不是常驻上下文;
- 用户的纠正消息在压缩时永远保留,压缩是为了省钱,不是为了失忆。
五、观测和截图:按需、有预算、按张计价
- 快照默认只看一小块:优先当前活动浮层/视口,而不是整页;支持按名称/状态过滤。结构树是固定字符预算 + 过滤 + 分页,返回时还会告诉你「要继续就按 offset 接着取」。
- 截图压质量、不缩尺寸:用 JPEG(质量 80)而不是 PNG。这里有个坑值得说 —— 对「按张固定计价」的模型,降分辨率不会少花钱,只会让模型看不清小字;真正省钱的是按区域裁剪。
- 截图直连主上下文,不再走「子调用把图转成文字描述」那条路:同一张图付两次费,还丢信息。
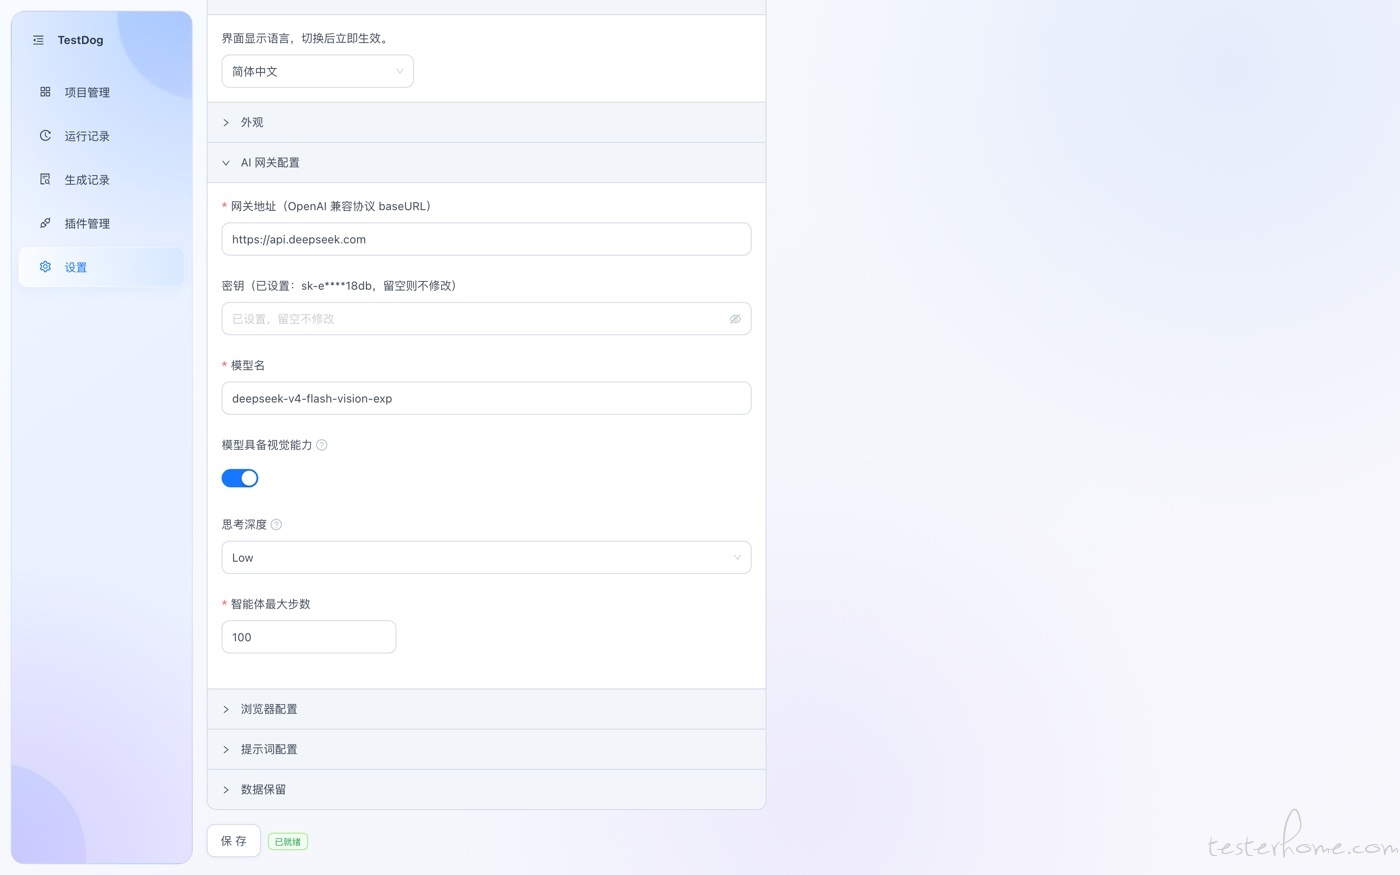
- 截图工具只在主模型有视觉能力时才注册,不需要看图的项目直接关掉。
六、几道「不许继续烧」的闸
循环里最贵的不是正常步骤,是卡住后反复试。所以有几层保护:
| 保护 | 触发 | 动作 |
|---|---|---|
| 空转保护(同工具 + 同参数) | 滑窗内 4 次 | 追加警告,让模型自己调整 |
| 6 次 | 挂起,请人决策 | |
| 累计 9 次 | 终止本次生成 | |
| 循环检测(周期 2–4 的动作重复) | 同串动作让页面回到同一状态 | 判定环绕,累计 9 次终止 |
| 观察空转(连续截图画面无变化) | 连续若干次 | 挂起求助 |
| 联动死锁(同类选择动作反复指向同一组元素) | 近窗内重复 | 挂起求助 |
两个取舍:
- 观察类工具不计入空转(快照、等待、读文本、断言重复是正常的),只有变更类动作才算 —— 否则正常的等待会被误判;
- 「挂起求助」不重置累计次数,只重置检测窗口。否则模型可以靠不停触发求助把窗口刷掉,无限续着烧钱。另外还有最大步数兜底。
七、两个顺手能关的成本项
思考深度可以真关掉。 这地方有个坑:某些模型(比如 DeepSeek 的思考模式)默认就是开着的、effort 还是 high,你不传参数并不等于关闭,必须显式发 thinking: { type: 'disabled' }。关掉之后,思考 token 这块直接归零;需要复杂规划时再打开。
观察空转阈值可调。 读图按固定 token 计价的模型,可以把「连续几次画面没变化才挂起」调大些 —— 少挂一次,可能就省掉一次人工介入加一轮重跑。
八、账要能看见
省钱的前提是能对账。每次生成都会按任务累计用量(输入/输出/总量/命中缓存的输入),生成记录里能看到每一步工具调用对应的 token 明细,列表里能看到整次消耗,运行记录里能看到回放 0 与自愈花了多少。
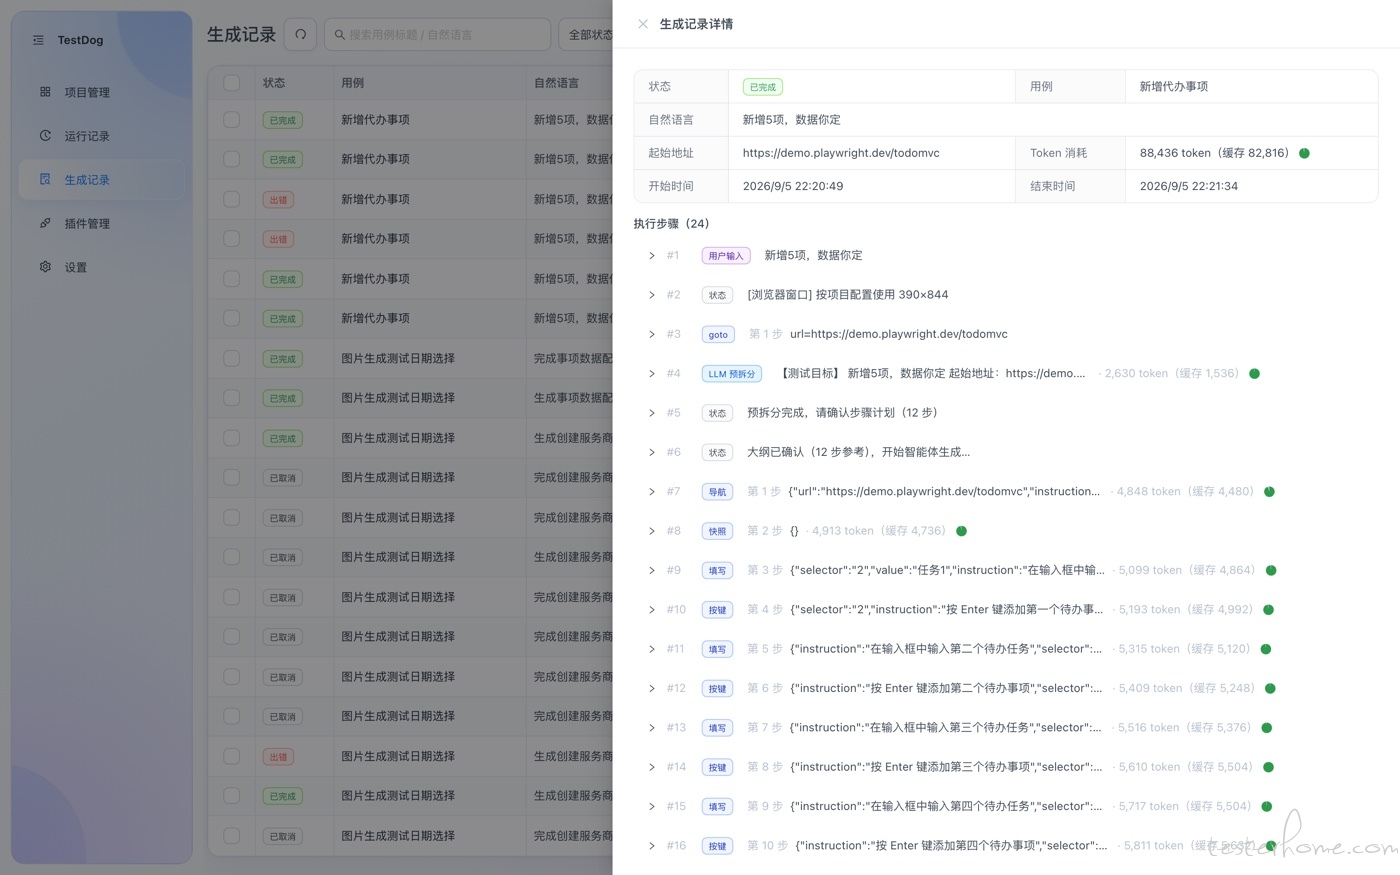
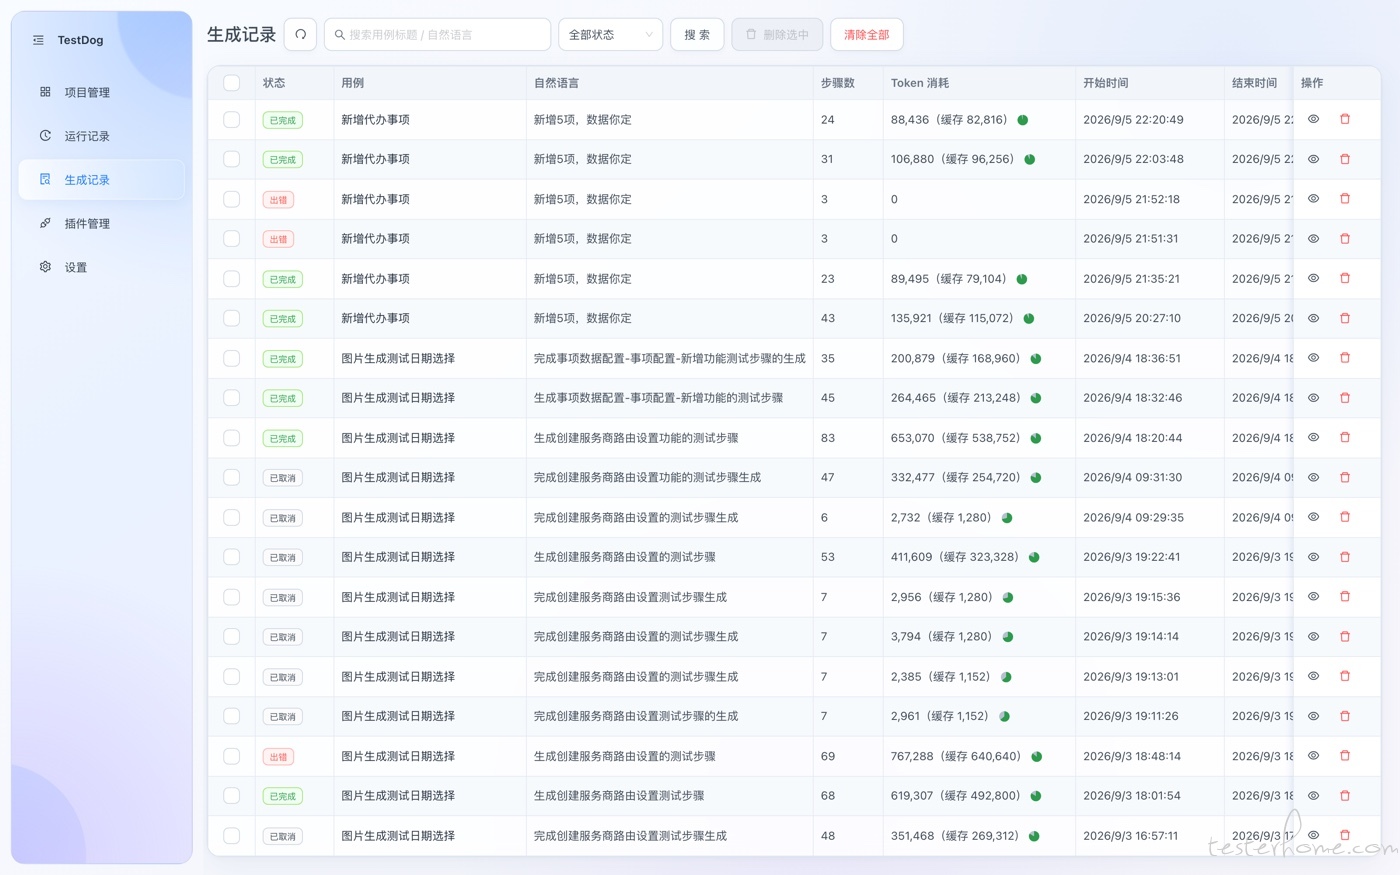
补一句实话:我们没有做显式的前缀缓存标记,命中靠的是「稳定的消息前缀 + 供应商侧的自动缓存」。所以那个「缓存命中」数字取决于你用的网关/供应商,以及前缀是不是真的稳定 —— 比如把每轮都在变的内容塞进 system 提示词,缓存立刻被打掉。它只是供应商回传的计数值,不是我们的估算。
九、想听听你们的账
「AI 测试用不起」我觉得不是模型能力问题,而是工程没做够:回放该不该调模型、上下文该留多少、卡住了要不要继续试,这三件事决定了成本量级。
你们团队试过 AI 测试工具吗?是被效果劝退,还是被账单劝退?有没有自己压成本的做法? 欢迎在评论区聊聊。
现状与限制
- 开源协议 MIT,当前版本 v0.1.7,提供 macOS(Apple Silicon / Intel)与 Windows x64 安装包;
- 面向 Web 应用的端到端回归,用例 / 脚本 / 运行记录全部保存在本地 SQLite;
- 需要自备 OpenAI 兼容的模型网关(项目不做托管、不内置模型),需要系统安装 Chrome;
- 只做桌面端,不是云测试平台;
- 早期项目,欢迎 Issue / 拍砖;
本项目已收录进 TesterHome 社区开源项目库:TestDog。
帮助文档 · 生成记录:https://softwing.top/testdog-doc/menus/genlogs.html
快速开始:https://softwing.top/testdog-doc/guide/getting-started.html
利益相关:我是 TestDog 的作者,本文写的是自己的实现与踩坑,不构成第三方评测。