从一句话到真机结论:SoloPi AI Harness 的工程实践
SoloPi AI Harness 的四条工程可信链:动作可信、判定可信、运行可信、证据可信。
AI 已经可以根据需求改代码、补测试,甚至自己修复编译错误。但当改动进入移动端,最后一个问题仍然绕不开:这个版本在真实设备上,真的满足需求了吗?
假设我们给 Agent 一个任务:
打开 App,把商品加入购物车,并验证购物车数量变成 1。
几十秒后,Agent 返回:done。
在演示里,这似乎已经完成;在工程系统里,我们还需要继续追问:
- 它点击的是当前页面上的按钮,还是几秒前看到的旧节点?
- 它说 “完成”,是因为看到了提示,还是准确控件的值真的等于
1? - Worker 中途退出后,谁继续负责?旧 Worker 恢复后还能不能覆盖新结果?
- 报告中的截图、清理结果和日志,是否真的来自同一次执行?
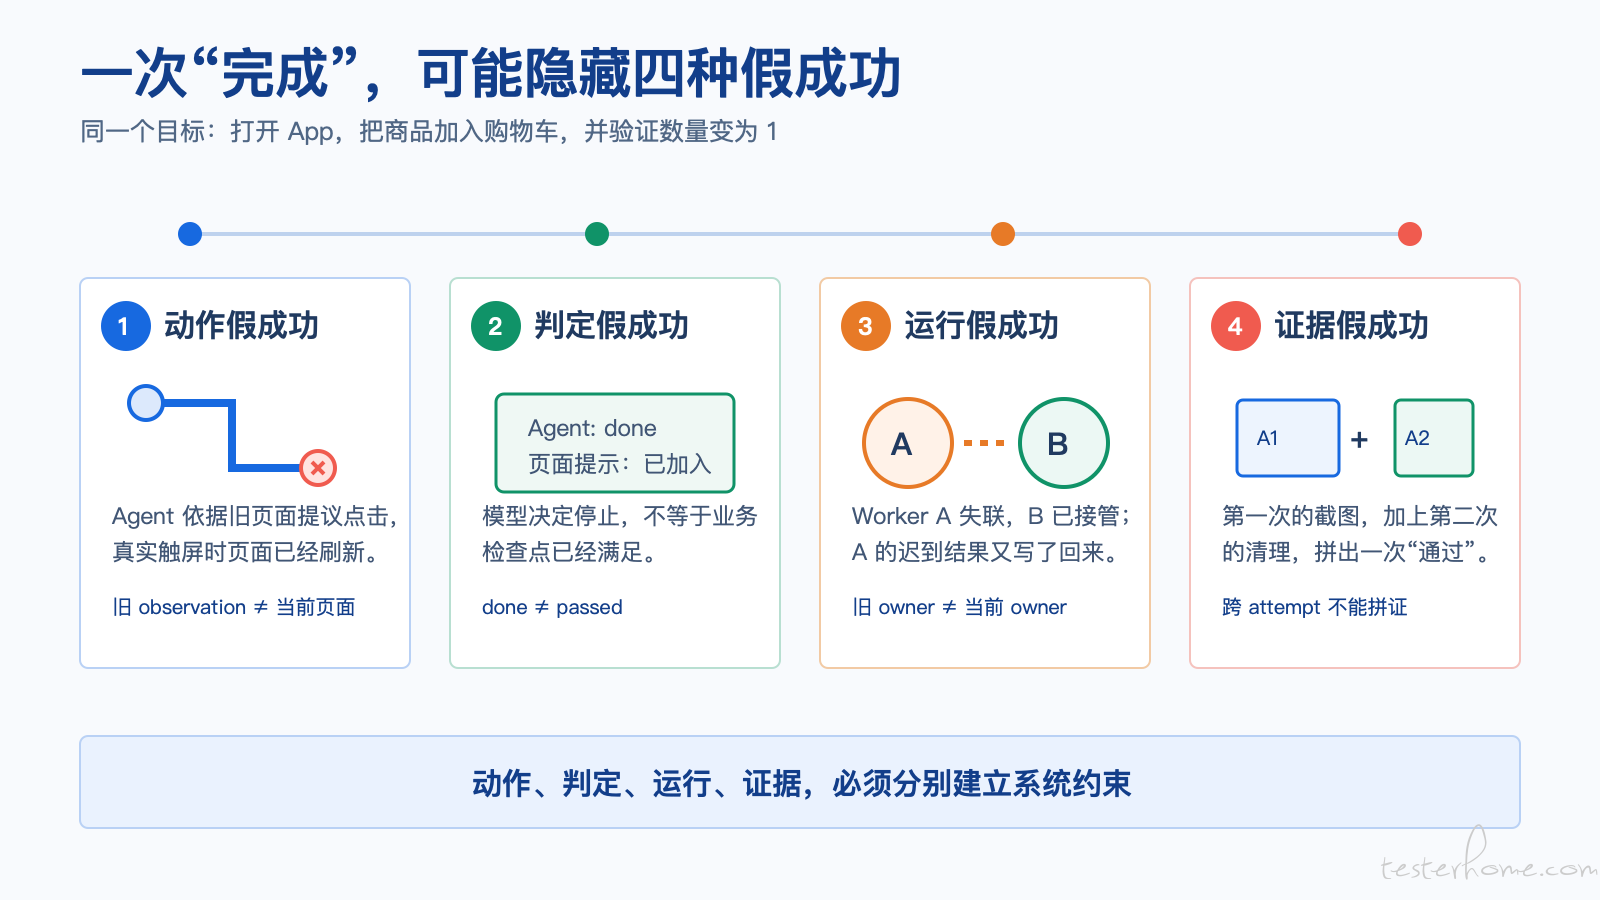
图 1:一次 done 可能隐藏动作、判定、运行和证据四类问题。
SoloPi AI Harness 要解决的,不只是 “让 AI 点手机”,而是让一次真机验证具备清楚的责任边界:模型可以提出下一步,系统负责约束执行;模型可以结束探索,独立规则负责给出结论;进程可以退出,任务责任不能丢;材料可以很多,但不能跨运行拼出一个结果。
先把 “证明改对了” 说准确
Harness 不能抽象地证明一段 Git diff 正确。它能证明的是:某个构建产物,在某台设备和某份验证计划下,得到了一份有同次运行证据支撑的结论。
如果希望报告真正回答 “这次代码修改是否改对”,CI 还需要把以下身份一起保存:
commit SHA
  -> APK digest / version
  -> device identity / environment
  -> planFingerprint
  -> task / shard / attempt
  -> report / evidence
SoloPi AI Harness 负责从验证计划到真机证据的部分;提交号和 APK 摘要应由构建流水线注入或归档。少了这一步,报告最多证明 “某个 APK 跑过”,不能严谨地回指到某次代码变更。
这也是本文的范围:不讨论 AI 如何生成代码,而是讨论当代码已经构建成 APK 后,怎样避免四种 “看起来成功”。
三个模块,一条责任链
SoloPi AI Harness 当前由三个开源模块组成:
-
solopi-skill:Agent 入口,负责能力发现、输入核对、安全规则和结果语义; -
solopi-harness-cli:宿主机侧责任中枢,负责编译计划、执行编排、独立判定、托管和报告; -
solopi-app:Android 真机执行端,负责观察、录制回放、受控触屏、断言和数据采集。
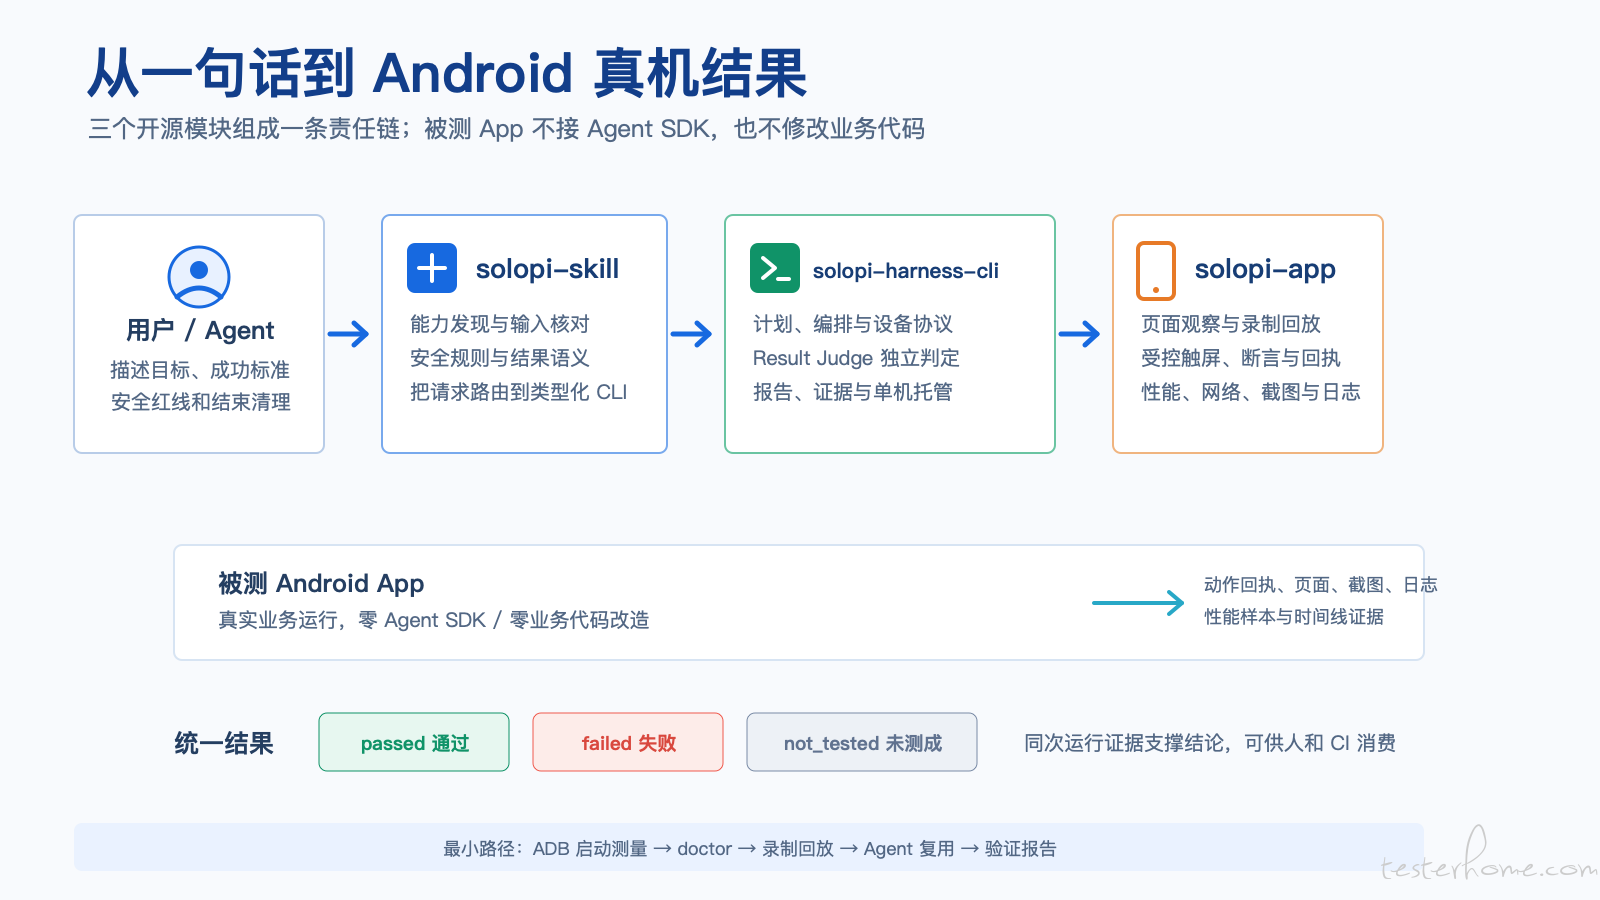
图 2:Agent、宿主机控制层和真机执行端分权;被测 App 不需要接入 Agent SDK。
这三个模块不是把自然语言直接翻译成一串坐标。系统先把需求和验收条件编译成测试合同,再把稳定路径交给固定回放,把确实未知的局部路径交给 Agent。无论路径怎样变化,最终都回到同一个 Result Judge 和同一套证据规则。
一、动作可信:旧页面不能指挥新页面
失败场景
Agent 观察到 “确认” 按钮,准备点击。就在推理的几百毫秒里,页面因为网络回调刷新了。画面可能看起来几乎相同,但原来的节点已经失效,相同位置甚至出现了另一个按钮。
如果控制层只接收一个坐标,触屏动作仍可能返回 “执行成功”,业务含义却已经错了。
系统保证
动作只能消费产生它的当前页面观察。页面一旦变化,旧动作必须在真实触屏前失效。
SoloPi 把每一帧页面状态记录为 Observation。DecisionProvider 会看到当前 Observation 及其中的页面节点,但它只返回带 selector 的 Action Proposal,不能直接操作设备。Harness 把 selector 在当前帧中唯一解析成 nodeId,并补入正在消费的 observationId,形成设备侧 agent-act 请求。设备端在触屏前重新刷新页面树,检查会话、所有权、Observation、页面签名、目标节点、动作白名单和预算。
最小协议可以理解为:
observe
  -> observationId / page signature / nodeId

DecisionProvider: propose(stepId, typed action + selector)
  -> Harness: bind(current observationId, resolved nodeId)
  -> agent-act(sessionId, stepId, observationId, action, nodeId)
  -> re-observe
  -> validate
  -> execute
  -> settle
  -> typed receipt + settledObservation
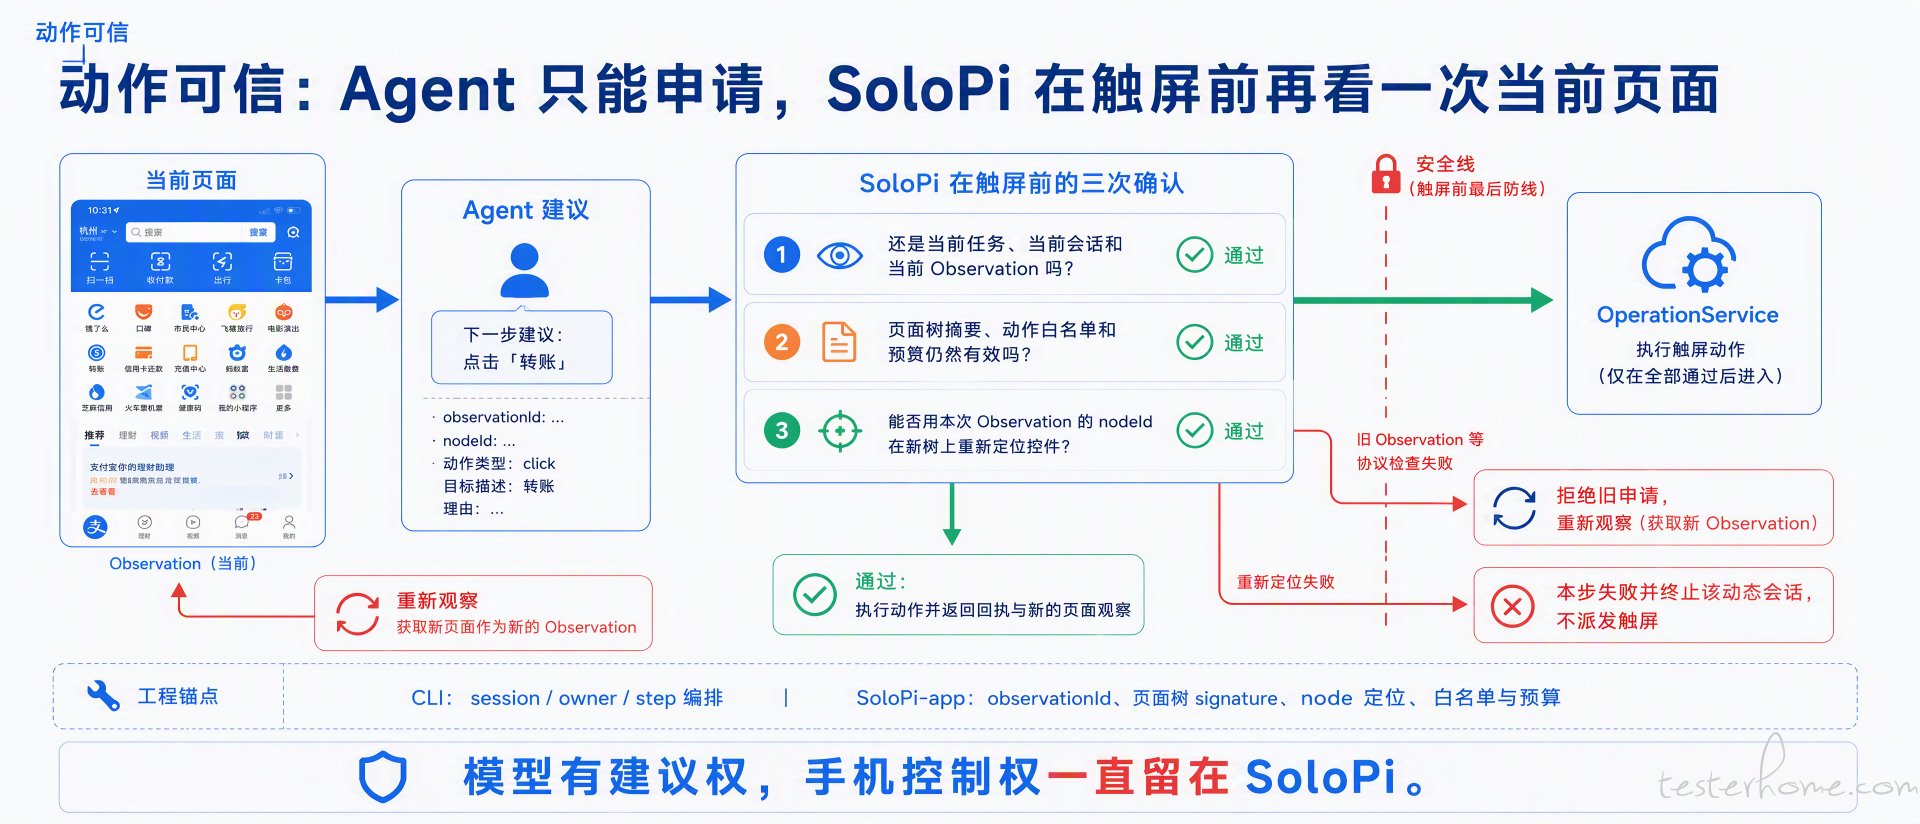
图 3:模型只有建议权;设备端在进入真实触屏前完成最后复核。此图为机制示意。
当前动态执行只开放七类类型化动作:click、longClick、input、back、home、scroll 和 wait。它不接受任意 Shell、进程控制、清数据或任意 Scheme。
一次被页面刷新打断的轨迹大致如下:
obs-104: 找到 node-17「加入购物车」
proposal: step-008, click(resourceId=cart_add)
Harness: 绑定 observationId=obs-104, nodeId=node-17
re-observe: 当前页面已经是 obs-105
receipt: rejected / stale_observation
下一步: 基于 obs-105 重新决策
这里还有两个容易被忽略的点。
第一,stepId 在会话内唯一且幂等。相同 stepId 因网络超时被重复提交时,系统返回已经保存的 receipt,不会主动再次触屏。
第二,“页面看起来一样” 不代表可以继续使用旧 Observation。刷新会产生新的页面树和节点实例;协议关心的是动作是否仍绑定当前状态,而不是人眼是否觉得两张截图相似。
动作可信并不承诺真实触摸的物理副作用严格 exactly-once。进程可能在点击已经发生、receipt 尚未持久可见时失联。因此恢复方必须重新观察和判断,不能盲目重发最后一个动作。
二、判定可信:Agent 的 done 不等于 passed
失败场景
Agent 点击 “加入购物车”,看到了 Toast,于是输出 done。但购物车角标因为服务端失败仍是 0。如果系统把 done 直接映射为成功,就会得到一份没有业务验收支撑的假通过。
系统保证
Agent 决定怎样走,测试合同决定怎样算成功,Result Judge 独占最终裁决权。
测试合同在执行前冻结四类信息:
-
precondition:从什么状态开始; -
checkpoint:在哪一步之后检查; -
Oracle:从哪个准确 selector 读取哪个字段,怎样与 expected 比较; -
required cleanup:结束后必须恢复到什么状态。
一个精简 checkpoint 如下:
{
  "id": "cart-count-is-one",
  "afterStep": "add-to-cart",
  "acceptanceCriteria": ["AC-1"],
  "oracle": {
    "type": "ui",
    "selector": {"resourceId": "com.example:id/cart_count"},
    "field": "text",
    "operator": "equals",
    "expected": "1"
  }
}
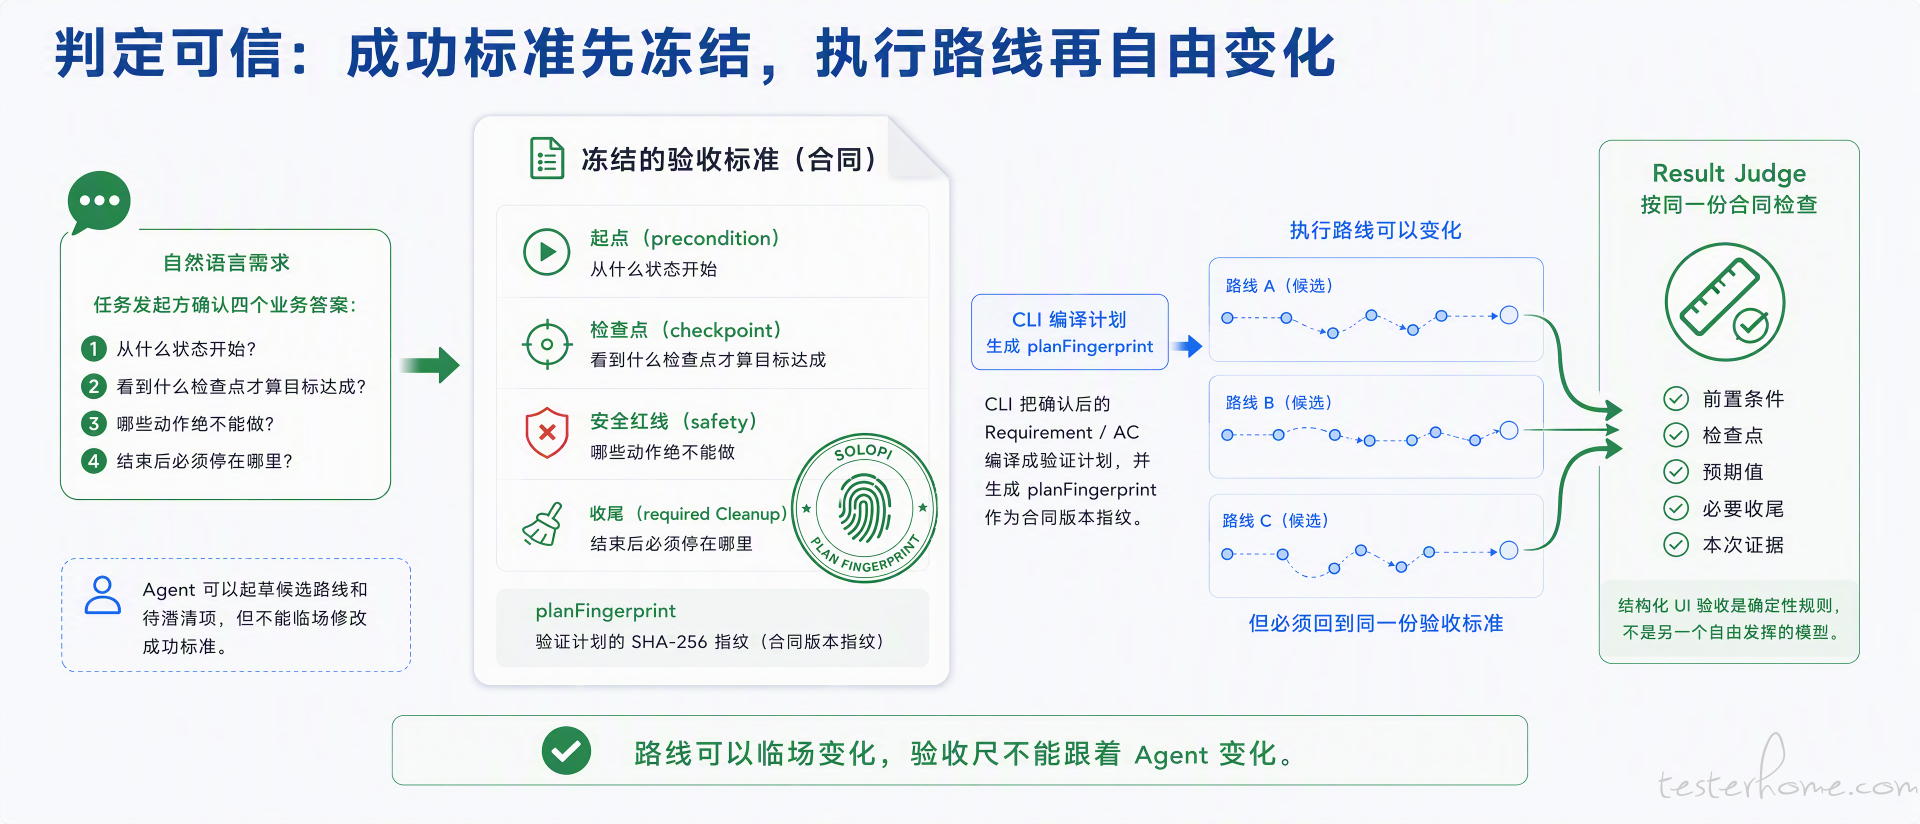
图 4:执行路线可以临场变化,成功标准不能跟着 Agent 变化。此图为机制示意。
正式结果只有三种:
| 结果 | 什么时候使用 | 不能混淆成什么 |
|---|---|---|
passed |
必要 checkpoint 有本次证据,Oracle 通过,required cleanup 通过 | 不能因为 Agent 说 done 就通过 |
failed |
已取得有效证据,Oracle 明确不匹配,或必要清理失败 | 不能把设备掉线笼统算产品失败 |
not_tested |
前置条件不满足、checkpoint 未到达、证据缺失或无法可靠归因 | 不能用来掩盖明确的 Oracle 不匹配 |
not_tested 很重要。它不是 “轻一点的失败”,而是诚实表达:这一次没有形成足够、可归因的证据。只有把产品失败和测试没测成分开,CI 才能采取不同策略。
固定回放、动态探索和两者组合的 hybrid 计划,最终都交给同一个 Judge。动态路径只改变 “怎么到达检查点”,不会改变 “检查什么” 和 “怎样通过”。
三、运行可信:接管的是责任,不是旧现场
失败场景
在夜间回归中,Worker A 领取任务并开始操作设备,随后进程退出。Worker B 接管并重新执行。此时 A 恢复,把自己的迟到结果写回来。如果系统只按 task ID 接受提交,新旧执行者就可能同时修改同一份结论。
系统保证
任务可以被接管,但旧所有者不能污染新 attempt;新 Worker 也不能把旧内存当作可恢复现场。
托管控制面把工作拆成 task / shard / attempt 并持久化到 SQLite WAL。Worker claim 一个 shard 时,会获得完整 assignment 身份:
taskId + shardId + attemptId + deviceId + leaseId + ownerGeneration
Worker 通过 heartbeat 续租。heartbeat 只证明 “当前所有者还活着”,不代表测试成功。租约到期并 recover 后,新 Worker 会获得新的 attempt、lease 和递增的 ownerGeneration。
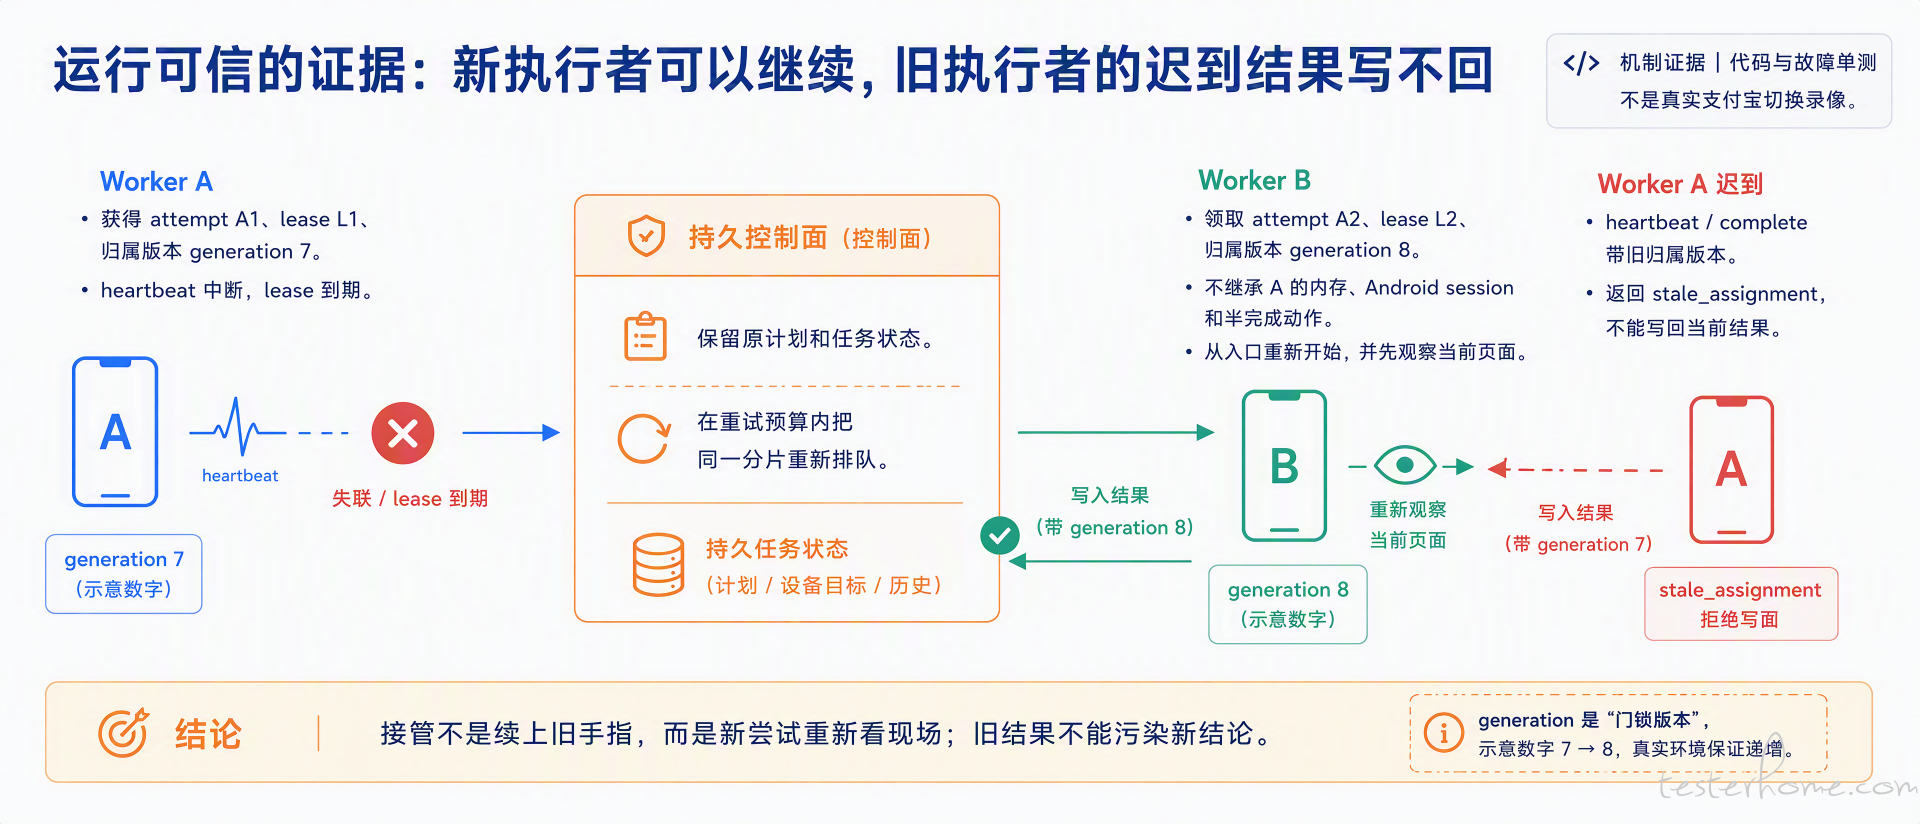
图 5:新 Worker 从测试入口重新开始;旧 Worker 的 heartbeat、完成和释放请求会被 fencing 拒绝。此图为机制示意。
关键限制是:B 不继承 A 的内存、调用栈、Android sessionId、页面 Observation 或半完成动作。它读取持久化的计划、决策输入和目标设备,以新的 attempt 从测试入口重新运行。
单元测试覆盖了这条边界:generation 过期后,旧 assignment 的 heartbeat 和 complete 都返回 stale_assignment;新 assignment 才能形成终态。
这类设计解决的是 “责任归谁” 和 “谁有权写结果”,不能撤销 A 失联前已经发生的点击。新 attempt 必须重新执行前置检查、观察当前页面,必要时先恢复业务状态。
当前开源托管范围是单主机、多 Worker:提供持久队列、设备匹配、lease、heartbeat、有界重试、恢复和 CI 报告。它不是云真机供给,也不宣称多主机 active/active 高可用。
四、证据可信:材料不能跨 attempt 拼接
失败场景
第一次执行成功加购,但清理失败;第二次执行没有加购成功,却把购物车清空了。如果拿第一次的截图、第二次的清理记录,再加一段独立性能数据,完全可以拼出一份 “看起来很完整” 的报告。
但这不是一次通过。
系统保证
每条正式结论只能引用同一计划、同一 assignment、同一 attempt 内产生的材料。
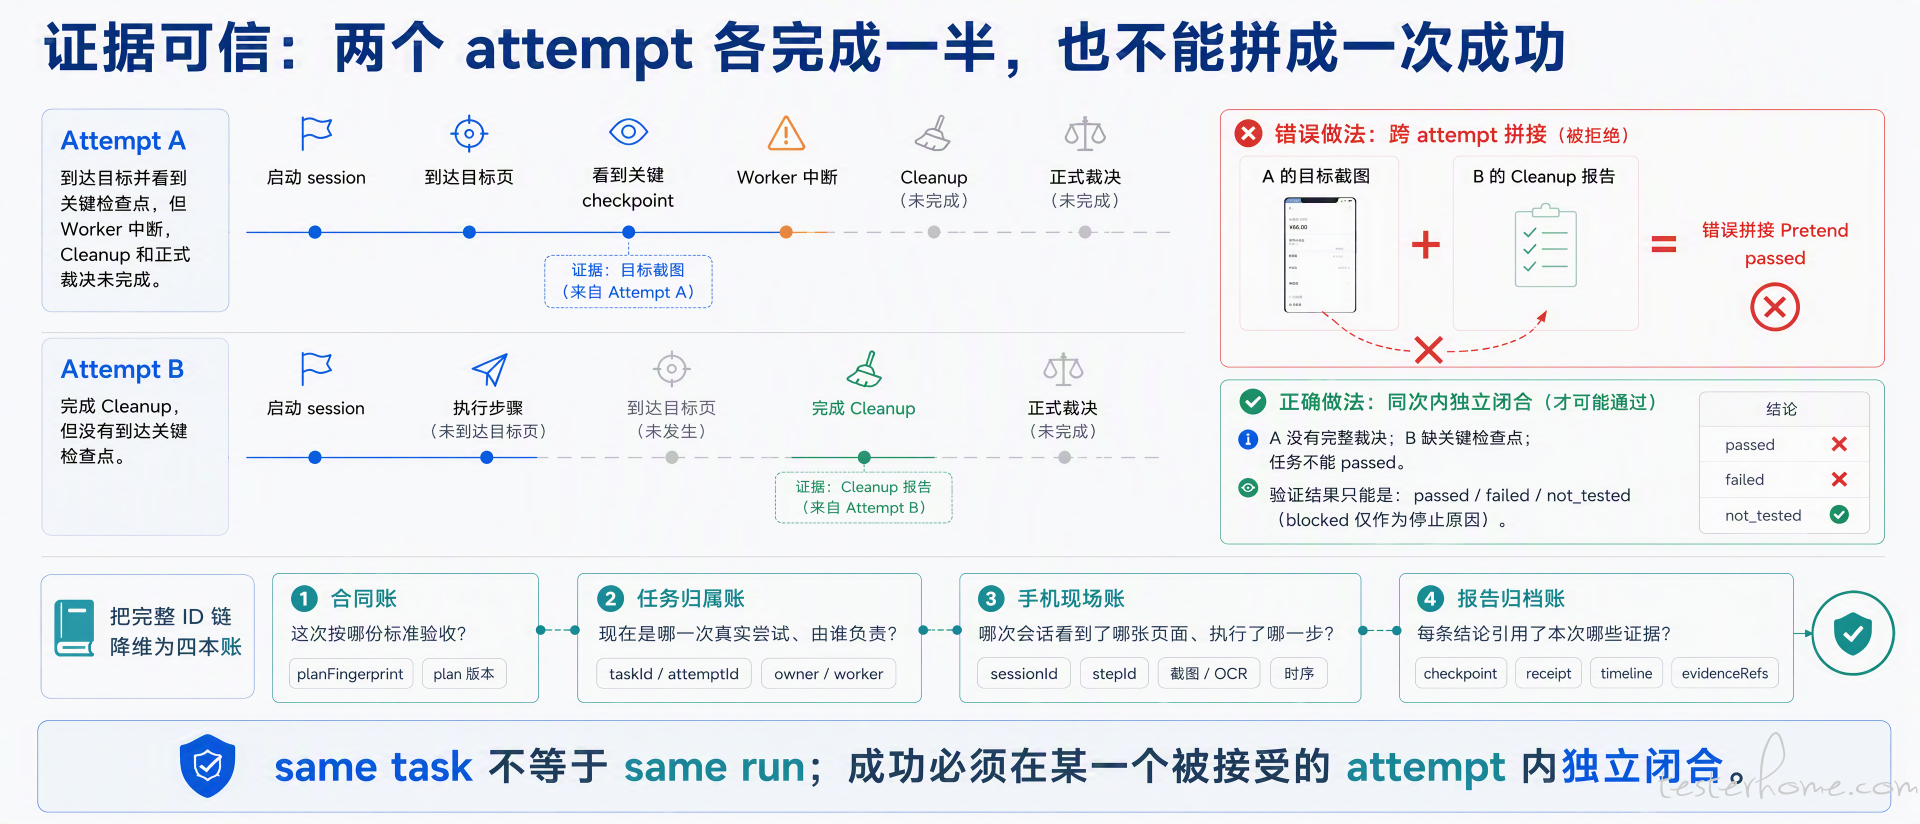
图 6:两个 attempt 各完成一半,也不能合成一次成功。此图为机制示意。
一次结论应当能沿身份链反向定位:
planFingerprint
  -> taskId / shardId / attemptId
  -> sessionId / observationId / stepId
  -> typed receipt / settled observation
  -> append-only timeline
  -> checkpoint / cleanup
  -> Result Judge
  -> report / evidenceDigest
验证目录使用只追加的 events.jsonl,并保存计划副本、固定回放证据、动态会话的脱敏 transcript/timeline,以及统一的 report.json。报告中的 checkpoint 通过 evidenceRefs 指回本次执行材料。
一个便于检查的产物目录可以理解为:
artifacts/cart-run-001/
├── plan.json
├── events.jsonl
├── report.json
├── deterministic/
│   └── replay-result.json
└── dynamic/
    └── <sessionId>/
        ├── transcript.json
        └── timeline.jsonl
evidenceDigest 是证据集合的内容摘要,适合检查材料是否变化、做保留和审计;它不是来源证明,也不能单凭一个 digest 证明两份材料来自同一次运行。
类似地,outcomeFingerprint 只对规范化后的裁决摘要做比较,方便判断同一计划两次运行是否得到一致结果。它排除了时间、run ID 和本机路径,因此不能替代 same-run identity chain。
当前机制防的是旧页面执行、模型自证、旧 Worker 写回和跨 attempt 拼证。它不等于防御被攻陷的宿主机、恶意设备或伪造系统时间,这些属于更上层的环境可信与制品安全问题。
固定回放仍然是底座,Agent 只处理变化部分
可信 Harness 不是把成熟自动化全部改成大模型推理。已知且稳定的步骤继续使用固定回放,成本更低,也更容易复现;只有浮层、首次引导、动态搜索结果等确实变化的局部路径,才交给 Agent 在动作白名单和预算内探索。
下面是仓库已有的历史真机实拍,展示 SoloPi 录制与回放的设备侧基础能力:
录屏 1:历史 UI 的外部相机实拍,用于说明真机录制回放底座,不作为四条可信机制已经完成验证的证据。
对于一条完整业务验证,更推荐混合编排:
固定步骤:启动 App、登录、进入商品页
动态步骤:处理不确定浮层或寻找变化入口
固定检查:读取购物车准确控件并执行 Oracle
固定收尾:清理商品并确认恢复成功
这种方式把模型用在真正需要判断的局部,同时让验收标准、清理和报告继续保持确定性。
一次完整技术演示应该录什么
仅有 “手机被自动点击” 的视频,证明不了本文的四个机制。建议配套录制四段短视频:
-
旧 Observation 被拒绝:观察到按钮后主动刷新页面,提交旧 Proposal,展示
stale_observation;重新观察后再成功点击。 -
done 仍被 Judge 判失败:Agent 输出
done,checkpoint 读取到0,报告为failed;再展示证据缺失时结果为not_tested。 -
Worker 接管:终止 Worker A,等待 lease 过期,由 B 建立新 attempt;A 的迟到 complete 返回
stale_assignment。 -
同次证据反查:从
report.json的 checkpoint 和evidenceRefs,反查到 receipt、settled observation 和 timeline;明确拒绝引用另一 attempt 的截图。
具体镜头、命令占位和验收点见配套的《工程机制录屏分镜与验收清单》。在没有连接测试设备时,不应该伪造一段 “新机制已经真机跑通” 的录屏;先把录制条件和成功标准写清,接入设备后一次性录出可复核材料。
适用边界
SoloPi AI Harness 当前更适合以下场景:
- Android 真机上的关键业务验收;
- 已有固定用例,希望只把变化页面交给 Agent;
- 需要区分产品失败与测试没测成;
- 需要单机多 Worker 持续执行并向 CI 输出稳定三态;
- 需要把结论反查到同一次运行的页面、动作和检查点。
同时要明确:动态 Agent 只有七类受控动作;性能指标以目标设备实际返回为准;网络能力是全局或应用进程的上下行流量与速率采集,不包含弱网、延迟、丢包或限速模拟;端侧模型是可选工程链路,不代表通用 GUI 模型已经在所有真实业务 App 上达到生产质量。
结语
AI 把代码写得更快,并没有自动把工程判断变得更便宜。
真机验证真正困难的地方,不是让手机动起来,而是让每一次动作都属于当前页面,让每一个结果都经过独立验收,让执行者退出后仍有人继续负责,并且让报告中的每份材料只证明它亲自发生过的事。
这四条可信链最终回答的是同一个问题:
我们为什么可以相信,这个 APK 在这台设备上,按照这份计划,得到了这个结论?
当这句话可以被机器检查、被人反查、被 CI 消费,Agent 才真正从 “会操作手机” 进入研发交付流程。