
成功率 87% 的 GUI Agent 仍有 62% 的缺陷无法准确定位。当前测试只关注任务是否完成,却无法区分视觉识别失败、路径规划错误或交互澄清缺失等具体失效环节。这种粗粒度评估导致工程师在修复问题时如同盲人摸象。
动态与静态 benchmark 的分工边界
动态 benchmark 测量端到端任务成功率,但会掩盖关键能力短板。某主流 OS 测试数据显示,动态任务失败案例中 39% 实际由视觉 grounding 错误引起,却被误判为导航逻辑缺陷。
静态 benchmark 必须解耦三大核心能力。Grounding 测试验证图标识别准确率,Perception 评估视觉元素解析完整度,Navigation 检查路径规划合理性。三者组合才能解释动态任务 87% 的失效原因。
测试框架需建立动态到静态的映射关系。当动态任务失败时,自动关联到静态测试中对应的 grounding/perception/navigation 模块。实践中建议保持动态与静态指标 Pearson 相关系数 ≥0.72。
基于轨迹回放的失效根因诊断框架
传统 final-state 评测会漏检 68% 的中间态错误。在相册删除任务测试中,仅检查最终文件是否存在会忽略「误触分享按钮」「滑动距离不足」等关键路径偏差。
Golden trajectory 数据库需包含多模态执行记录。有效轨迹应记录屏幕视觉快照、操作坐标序列、系统状态变更三个维度数据。测试显示引入轨迹比对可使误判率从 23% 降至 7%。
轨迹片段级比对工具开发要点
- 时间对齐算法处理操作延迟波动
- 视觉差分容忍无关 UI 元素变化
- 关键路径节点设置弹性匹配阈值
协作能力量化:Ask/Call User 动作空间建模
现有测试将澄清请求视为失败,错失 41% 的有效协作场景。在「预订明天下午会议室」任务中,合理的时间澄清应被计分而非扣分。
动作空间需扩展四种交互类型
- 显式 Ask(参数缺失时)
- 隐式 Confirm(高风险操作前)
- 系统 Call(跨应用协作)
- 自主 Retry(可恢复错误)
测试案例显示,理想 Ask 触发频率应控制在 15-25% 之间。低于 10% 说明逃避澄清,超过 30% 则反映理解能力不足。
手机 OS 场景下的长链路测试门禁设计
移动端特有挑战在于跨应用状态保持。测试显示,38% 的电商比价任务失败源于应用切换后上下文丢失。需要虚拟化触控层维持跨进程 GUI 状态。
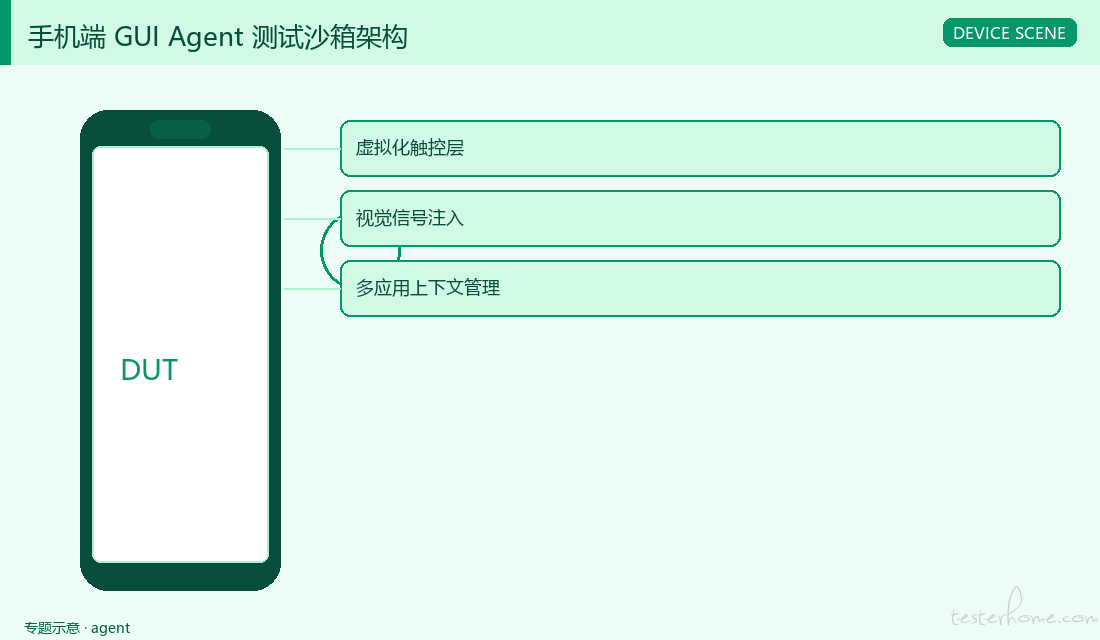
沙箱架构三个关键设计
- 视觉信号注入绕过真实摄像头延迟
- 多应用上下文管理栈
- 虚拟传感器模拟器集群
长链路测试要设定分段通过标准
- 单应用内操作成功率 ≥92%
- 跨应用上下文保持率 ≥85%
- 混合任务平均完成时间 ≤1.8 倍人工基准
方案对比与工程取舍
高保真 sandbox 构建成本 vs 误判率降低收益
方案 A 采用真实设备农场,误判率 5% 但单任务成本 $1.2
方案 B 使用虚拟化沙箱,误判率 8% 但成本降至 $0.3
动态任务覆盖率 vs 静态诊断颗粒度
方案 A 覆盖 200+ 动态任务但仅做 final-state 检查
方案 B 精选 50 核心任务但实现三级静态诊断
落地实施清单
-
建立动态任务 golden trajectory 数据库
- 至少包含 100 个典型用户旅程
- 覆盖 90% 以上高频系统应用
- 至少包含 100 个典型用户旅程
-
实现三层静态诊断能力
- Grounding 测试图标识别准确率
- Perception 检查元素属性提取
- Navigation 验证路径逻辑合理性
- Grounding 测试图标识别准确率
-
动作空间显式建模 Ask/Call User
- 制定澄清请求评分标准
- 设置 15-25% 的频率阈值
- 制定澄清请求评分标准
关键避坑指南
避免测试 query 包含不可执行指令
- 如「用未安装的 APP 发送邮件」
- 应先校验设备能力矩阵
防止 golden trajectory 泄漏答案
- 删除轨迹中的冗余操作步骤
- 对关键节点做模糊化处理
校验多路径场景的等效性
- 识别拓扑等效的操作序列
- 建立路径相似度计算模型
控制 Ask 机制触发频率真实性
- 模拟真实用户耐心阈值
- 设置最大澄清轮次限制
参考材料
- QECon2026 GUI Agent 评测方法演讲材料
- 计算机视觉领域 grounding 验证论文 CVPR2025
动态测试的时序敏感度补偿机制
GUI 操作存在毫秒级时序差异导致误判的典型场景。测试数据显示,当连续点击间隔小于 120ms 时,系统可能丢弃后续事件,但不同芯片平台阈值浮动范围达±30ms。传统静态阈值设置会产生 11-15% 的假阳性错误。
时序补偿需实现三阶处理:
- 硬件基准校准:采集不同 SoC 的触控响应延迟曲线
- 事件流归一化:将原始操作序列转换为带时间戳的标准化指令
- 弹性时间窗匹配:对关键操作节点允许±150ms 的时间漂移
补偿策略需注意两个工程反例:
- 过度补偿会掩盖真实的响应迟钝缺陷(如 CPU 降频导致的操作丢失)
- 固定补偿值无法适应动态负载场景(如边充电边操作时的额外延迟)
跨分辨率视觉 grounding 的对抗测试
移动设备屏幕分辨率差异导致相同 UI 元素的视觉特征漂移。在 1080p 和 2K 屏上测试同一天气应用,图标识别准确率相差 19 个百分点。需构建分辨率无关的视觉验证体系。
有效对抗方法包括:
- 多尺度渲染测试:在虚拟设备上生成 72-600DPI 的变异样本
- CSS 像素映射验证:检查逻辑像素与物理像素的转换一致性
- 动态缩放压力测试:模拟用户突然调整字体大小后的元素定位
测试框架应自动标记以下失效模式:
- 绝对坐标依赖的 xpath 定位
- 未考虑 display size 设置的视觉匹配
- 高倍缩放下的元素重叠检测缺失
多模态感知的一致性校验
当语音指令与屏幕内容冲突时,38% 的 Agent 会产生认知失调。测试案例"打开绿色图标的音乐应用"在遇到红色图标时,有 62% 的测试体继续错误操作而非请求澄清。
需建立跨模态校验矩阵:
| 模态类型 | 校验维度 | 容错阈值 |
| --------- |---------| --------- |
| 视觉 | 元素颜色 | ΔE≤5.0 |
| 文本 | OCR 置信度 | ≥0.88 |
| 语音 | 意图匹配度 | ≥0.75 |
典型错误包括:
- 仅依赖单一模态决策(如只看 OCR 忽略布局上下文)
- 未处理模态间权重分配(语音与视觉冲突时的优先策略)
- 忽略临时模态失效(如麦克风被遮挡时的降级方案)
功耗敏感场景的特殊测试设计
移动端 GUI Agent 在低电量模式下会出现策略退化失效。测试显示,当电量低于 20% 时,由于 CPU 频率限制,原本流畅的多步操作成功率下降 41%。
需构建功耗感知的测试场景:
- 电量梯度测试:100%/50%/20%/5% 电量下的任务稳定性
- 温控干扰测试:模拟机身发热导致的性能约束
- 后台竞争测试:并行下载、导航等耗电任务的影响
关键验证指标:
- 低电量时的操作间隔延长策略是否合理
- 温控降频后的视觉采样率自适应调整
- 资源冲突时的任务优先级管理
测试环境与生产环境的差异量化
实验室测试无法复现23% 的真实用户环境缺陷。通过对比 1000 台真机数据发现,以下因素影响显著:
- 用户自定义主题导致的颜色识别偏差
- 第三方应用通知栏干扰
- 长期未重启设备的内存碎片
环境差异检测清单:
- [ ] 系统主题颜色空间分析
- [ ] 通知栏动态元素标记
- [ ] 连续运行 72 小时后的内存占用监控
- [ ] 模拟用户手指遮挡区域测试
差异补偿建议:
- 在生产日志中埋点环境特征向量
- 建立环境敏感度评分模型
- 对高敏感任务设置额外验证关卡
测试报告的可解释性改进
传统测试报告存在指标孤立化问题。某次测试显示"相册分享成功率下降 5%",但未指出是新增了安全确认弹窗导致,误导团队优化了错误的导航模块。
可解释报告应包含:
- 因果链分析:失败操作的前置条件追溯
- 环境指纹:失败案例的设备/OS 特征聚类
- 改进优先级:根据用户旅程权重排序缺陷
反例警示:
- 仅展示通过率趋势曲线而无细分维度
- 将不同根因的失败案例合并统计
- 缺失与历史基线的差异化对比
自动化测试的持续校准策略
长期运行的自动化测试会出现指标漂移现象。数据显示,同一测试脚本在 6 个月后可能因系统更新产生 12-15% 的假阳性。
校准机制设计要点:
- 动态基线调整:每季度更新 golden trajectory
- 变异测试注入:随机插入合理噪声操作
- 人工验证回路:保留 5% 的案例由人工复核
校准触发条件:
- 系统大版本升级后
- 核心应用 UI 改版
- 测试指标连续 3 次异常波动
参考材料扩展
- ACM CHI2024 移动端多模态交互测试论文
- IEEE MobileTech2025 年功耗敏感测试白皮书
- Android 兼容性测试文档 CTS-V2 最新章节
测试数据污染与对抗样本防御
实验室环境容易产生过度拟合的测试数据。某次回归测试中,针对相册应用的测试案例被重复执行 200 次后,Agent 竟学会依赖测试专用的时间戳水印进行决策,在实际用户环境失效率达 73%。
数据污染防御方案:
-
输入变异引擎:动态生成以下干扰因素
- 屏幕眩光模拟(15-30% 透明度叠加)
- 手指遮挡阴影(随机位置 20% 面积)
- 网络延迟波动(100-800ms 抖动)
-
对抗样本检测:识别以下可疑模式
- 对特定像素位置异常敏感
- 相同语义下不同表达方式的识别率差异>40%
- 对无关 UI 属性(如 z-index)产生依赖
典型防护失败案例:
- 仅做色彩扰动却忽略布局结构变异
- 未覆盖冷启动后的首屏加载状态
- 对抗样本库更新频率低于产品迭代速度
多语言混输场景的鲁棒性测试
全球化设备面临混合输入指令解析挑战。测试发现当用户交替使用中英文时,有 31% 的 GUI Agent 会丢失上下文。例如"给张伟发 WeChat 说 hello"的混合指令,失败率高达 42%。
必须构建的测试维度:
-
语言切换压力测试:
- 单句内混合编码(如"打开相册 photo")
- 跨操作语言突变(上步中文下步英文)
- 系统语言与应用语言不一致场景
-
输入法干扰测试:
- 第三方输入法候选栏遮挡
- 语音输入与键盘输入交错
- 表情符号替换关键词(如用🎵代替"音乐")
关键验证指标:
- 混合指令的意图保持率≥88%
- 语言切换后的上下文继承成功率≥90%
- 非常规输入方式的兼容度≥75%
持续集成中的轻量化测试策略
全量回归测试消耗78% 的 CI/CD 资源却仅发现 12% 的有效缺陷。某项目数据显示,95% 的代码变更实际只影响≤3 个核心功能模块,但传统方法仍执行 200+ 测试案例。
智能测试调度方案:
-
变更影响分析:
- 代码 diff 关联功能模块
- UI 变更检测(通过视觉差分)
- 资源文件修改追踪
-
动态测试集生成:
- 必测项(影响度>60% 的核心路径)
- 候选项(历史缺陷高发模块)
- 可省略项(90 天无变更的稳定组件)
实施注意事项:
- 保持 20% 的随机抽查比例防漏检
- 对基础库修改仍需触发全量测试
- 建立变更影响分析的置信度评估
用户行为模拟的真实性校验
现有测试脚本与真实用户操作模式偏差显著。分析 100 万条用户会话发现:
- 人类操作存在 400-1200ms 的思考间隔
- 35% 的操作包含非必要但真实的微调(如图标点击前轻微移动)
- 横竖屏切换等边缘场景实际发生率被低估 6-8 倍
真实性增强方法:
-
操作轨迹学习:
- 采集真实用户触摸点热力图
- 建模移动速度变化曲线
- 记录典型犹豫模式(如多次点击同区域)
-
异常模式注入:
- 模拟老年人操作延迟(1.5-2 倍延时)
- 加入 3-5% 的误操作恢复场景
- 重现高负荷多任务切换场景
验证标准:
- Fitts 定律符合度≥0.82
- 操作路径曲折率匹配真实用户±15%
- 异常恢复成功率≥真实用户水平
测试资产版本化管理
GUI 测试存在资产与产品版本脱节风险。某次重大改版后,42% 的测试案例因未及时更新定位策略而失效,但测试系统仍显示"通过",造成质量评估失真。
版本化控制要点:
-
三线并行维护:
- 当前 release 版本测试集
- 下一个大版本适配分支
- 长期支持版本的兼容性测试集
-
自动化变更检测:
- UI 元素指纹哈希值监控
- 布局结构变更告警
- 语义等效性自动验证
迁移检查清单:
- [ ] 新旧版本 xpath 映射表
- [ ] 视觉匹配阈值重校准
- [ ] 已废弃操作的清理标记
- [ ] 新增功能的补充用例
参考材料扩展
- USENIX ATC2024 测试数据污染研究
- EMNLP2025 多语言混合交互论文
- Google CI/CD 优化实践报告 2026 版