
接上周《过程决策、踩坑与解法》。
这篇只拆最疼的三个——都是「看起来能保存,打开详情才发现全错」那种。
总判断(贯穿三坑)
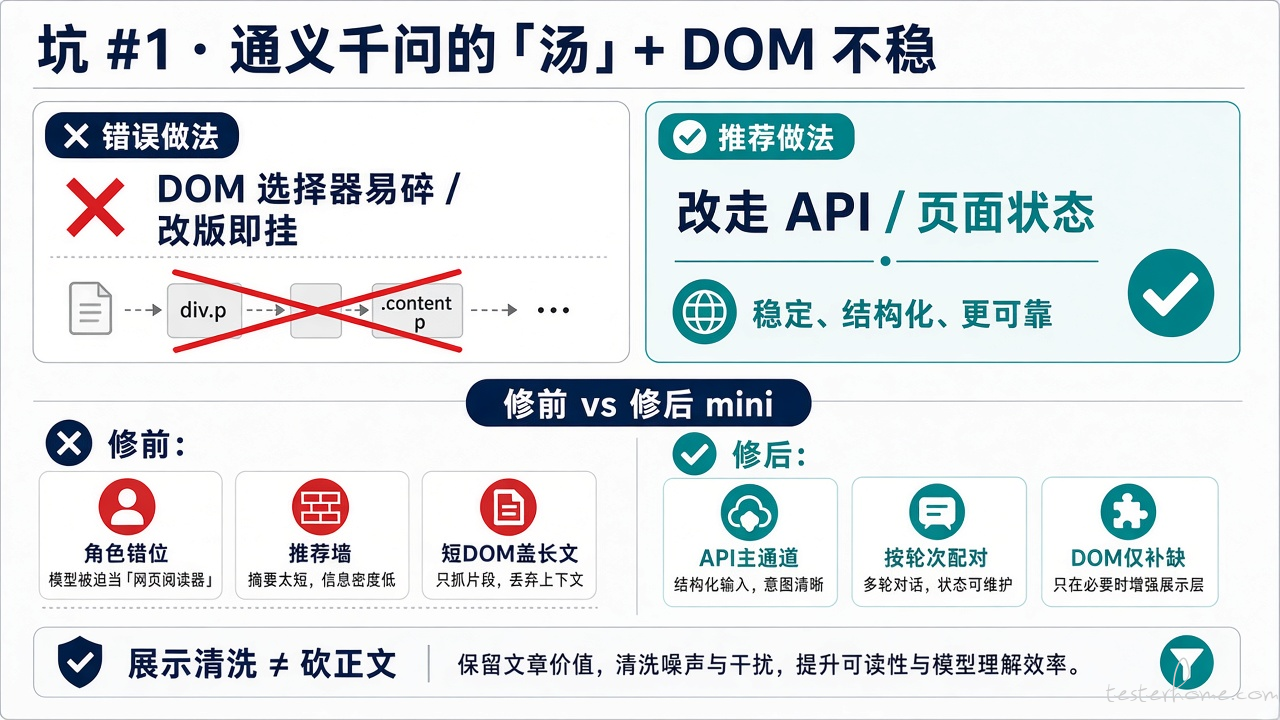
早期靠 DOM 选择器 扒页面,站点一改版就碎。
后来主通道改成 API / 页面内状态,DOM 只做补缺——这是 v0.1.0 能稳住的关键转向。
坑 #1|通义千问的「汤」+ DOM 不稳
现象
- 用户 / AI 角色错位
- 正文被「推荐 / 检索 / 思考过程」顶掉
- 表格、加粗丢失
- 图和 Word 变成一串怪文字,或卡片直接没了
- 同一套 DOM 逻辑,站点小改就抽空 / 抽错
为什么难
千问不是纯 DOM 文本。一页里同时有:思考壳、检索墙、推荐卡、多轮问答、媒体结构。
早期为了「保留格式」,优先拿带 Markdown 的 DOM 碎片—短碎片盖掉完整正文;合并时又「全局取最长一段」,第二轮回答直接消失。
更麻烦的是:class / 结构不契约,DOM 路径本身就不稳定。
怎么拆开的
- 主通道改走 API / 页面状态(如 chatRounds),不再赌选择器
- DOM 降级为补缺:只补缺轮、补格式;短 DOM 不得覆盖长正文
- 结构类型黑名单:
think/planning/ 推荐卡先跳过 - 按轮次配对:用户 A → AI 答 A,用户 B → AI 答 B,禁止跨轮折叠
- 展示层可剥思考壳;存储层不砍原文与媒体
教训
多站点适配,最危险的不是「取不到」,而是:
- 取到了一锅汤,还以为是答案
- 把易碎的 DOM 当成唯一真相
坑 #2|媒体卡片叠罗汉
现象
元宝 / 豆包 / 千问都出现过:
- 生成图根本没卡片
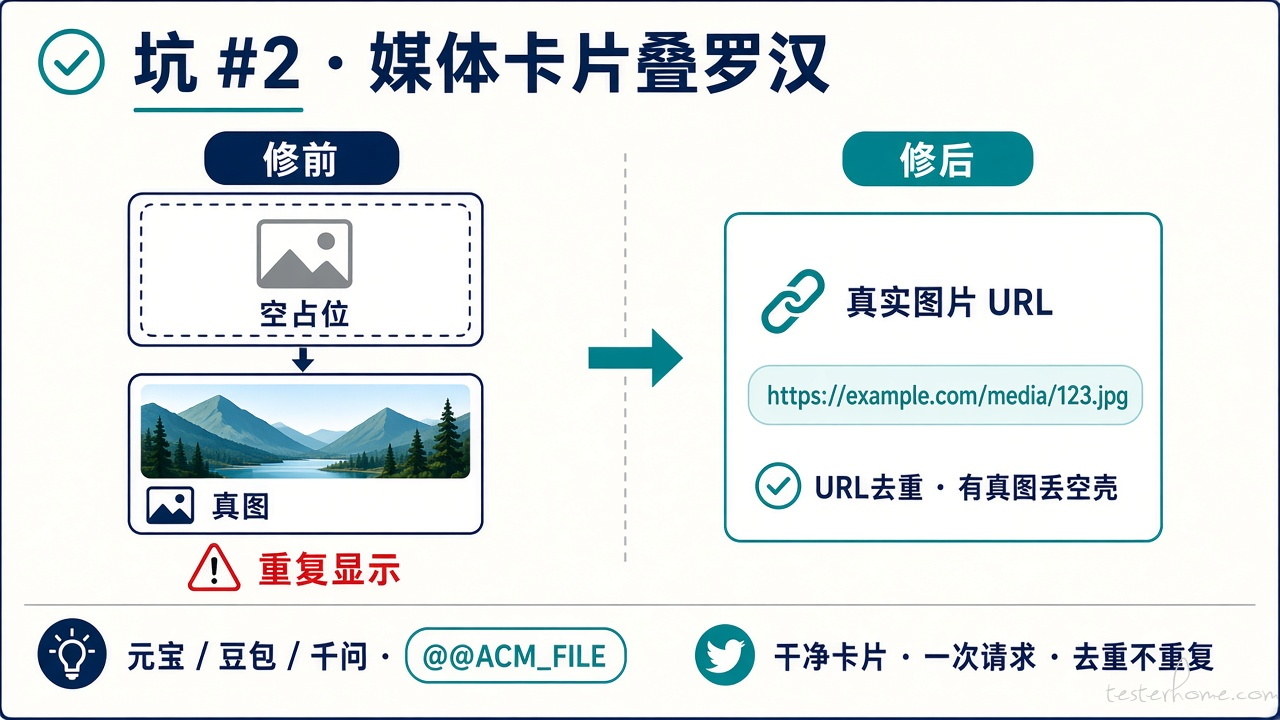
- 空占位卡片和真实图片叠在一起
- 推荐类图片还曾被存成一堆文字
为什么难
各站媒体形态不统一:进度文案(如 0%)、占位 URL、真实 CDN、文件卡片混在一起。
DOM 里「看起来像图」的节点更不可靠;只「有 media 就塞一张卡」,必然重复或假卡。
怎么拆开的
- 尽量从 API / 状态里拿真实资源地址,再渲染卡片
- 统一卡片协议(内部
@@ACM_FILE一类标记) - 有真实 URL 就丢掉空占位;按唯一 URL 去重
- 推荐墙图片:产品决策改为不展示,避免污染正文
教训
媒体是一等公民。去重写进抽取层,别在易碎 DOM 上碰运气。
坑 #3|Kimi:代码变文件卡 + 会话页约束
现象
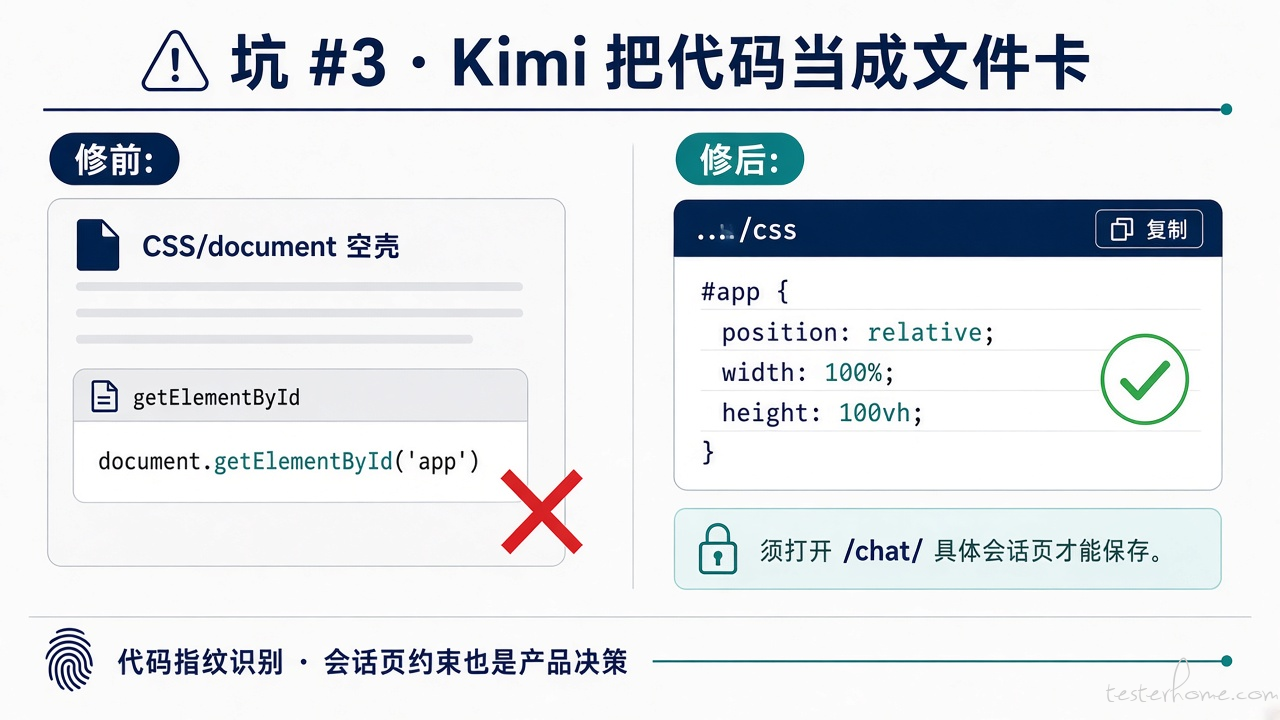
- 计算器等代码被存成空的「CSS / 文档」卡片
- 图片搜索标记没转成卡,有时还挂到用户气泡上
- 不进具体对话页就存不住
为什么难
Kimi 的代码 / 文档 / 图片在结构上容易糊在一起;纯 DOM 更容易把getElementById 误判成「文档 / CSS 附件」。
会话 ID 只在 /chat/… 具体页稳定——这是平台事实。
怎么拆开的
- 能走接口 / 结构化数据的优先走;DOM 代码块只做回填
- 代码指纹:编程代码走代码块,不走文件卡
- 图片标记解析成卡片,并绑到正确角色
- 产品决策:必须打开具体对话再保存(明确提示,不硬猜首页)
教训
「不改」有时也是正确解法——把约束说清楚,比静默存脏数据更负责任。
三个坑的共通解法
- DOM 不稳定 → 主通道改 API / 页面状态,DOM 只补缺
- 按轮次,不按「全局最长」
- 展示清洗 ≠ 存储砍内容
- 媒体卡片化 + URL 去重
- 写不清的边界,就写成产品提示,不要装智能
开源:https://github.com/SantoCc/ai-chat-manager
你做多站点抓取时,是继续加选择器,还是已经切 API 了?
暂无回复。