本期编辑:@ 三水 @ 鲍勃
1、DinoDial 开放多模态 Agent Harness 早期体验:语音与视觉共用实时连接,支持边通话边查看画面
实时语音 Agent 基础设施公司 DinoDial 宣布开放多模态 Agent Harness 早期访问,将视觉输入加入原有语音交互系统,使 Agent 能够在同一次通话中持续聆听用户、查看摄像头画面或照片,并结合视听上下文作出回应。团队表示,其语音基础设施此前已处理超过 100 万次生产环境通话,目前正开展企业私有试点。
语音与视觉共用一条实时处理链路: 不再分别调用语音、视觉模型后拼接上下文,而是通过统一运行时和有序连接,将音频、图像及摄像头帧发送给多模态模型。平台支持接入 Gemini Live 等模型,减少跨模态状态同步的复杂度。
优先保证语音连续性: 摄像头输入限制为每秒最多 1 帧,图像在设备端缩放至 768 或 1024 像素长边。当网络带宽不足时,系统优先传输音频,丢弃过期的视频帧,避免视觉输入阻塞语音对话。
支持视听事件回放与追踪: 通过 Lens 可观测工具,在同一时间线上记录音频、接收的图像及被替换或丢弃的帧,帮助开发者排查 Agent 实际看到的画面与用户展示内容之间的差异。
已开放早期访问申请: 团队正与企业客户开展试点,面向远程设备排障、文档核验及保险理赔等需要边交流边查看现场的场景。目前尚未公布独立开源代码或标准化公开 API 的完整接入说明。
https://dinodial.ai/multimodal-agent-harness
2、语音 Agent 公司 Bland 发布全双工语音模型 Tofu-1:支持区分背景人声、实时打断及边说边推理
语音 Agent 公司 Bland 发布首款自研 Speech-to-Speech 模型 Tofu-1,面向银行、医疗、保险及政务等高要求电话场景。模型不只识别通话文字,还尝试持续理解说话者身份、声音来源、语气和周围环境,并在生成语音时保持聆听与任务推理。目前 Tofu-1 已开放研究预览申请,尚未全面公开提供模型 API。
区分通话对象与背景人声: Tofu-1 针对车内、医院、弱信号和多人同时讲话等复杂环境设计,能够分析声音来自谁、是否在对 Agent 讲话,以及电视、儿童或其他旁人发言是否与当前任务有关。
支持全双工接话与实时打断: 模型在讲话时持续接收音频,可区分用户的简短附和与真正的纠错。例如用户在确认保单号码时说「对」可以继续,而说「不对,是 4 不是 9」则需要停止并修正。
边交流边执行推理任务: 将对话回应与后台任务处理并行,让 Agent 在查询保单、核验身份或检索业务信息时维持交流,同时根据用户最新补充的信息调整执行过程。
面向企业开放研究预览: Bland 已在官网提供包含背景噪声和边说边处理任务的音频演示,目前主要招募处理高风险或复杂电话业务的企业测试,尚未披露独立基准测试成绩、模型权重或推理延迟指标。
https://www.bland.ai/speech-to-speech
3、蚂蚁开源全双工音视频模型 Duo:持续感知并生成视听回应,开放权重与实时推理代码
蚂蚁开源团队 inclusionAI 发布 Duo v1,提出 Reciprocal World Model(双向世界模型)架构,使 AI 能够持续感知用户的音频、视频和文本输入,并实时生成包含声音与画面的回应。与传统先理解指令、再单独生成视频的流程不同,Duo 将交互意图与音视频生成放到统一时间线上,支持自然交谈、用户打断及持续变化的视听互动。
Intent 与 Realization 双模块协同: Intent 通过自回归建模持续判断交互意图、轮次及参与时机,Realization 负责生成与当前上下文一致的音视频内容,使模型能够在理解用户的同时持续产生回应。
统一时间线支持因果流式生成: Duo 对不同时间块的条件信息和 Token 进行对齐,通过模块专属注意力掩码限制对未来输入的访问,并采用双重 Rollout Distillation 缓解自回归交互及生成结果带来的分布偏移。
同步开放多个模型版本与推理实现: 已发布 Duo-1.0 因果基础版、蒸馏版、量化版及 Duo-1.2 因果基础版权重。GitHub 主分支提供离线研究推理代码,另有基于 vLLM-Omni 和 SGLang-Omni 的在线实时流式推理分支。
当前为研究预览版本: 已支持基础音视频对话、连续感知与打断,项目主页提供演示及技术论文。代码采用 Apache 2.0 许可证,团队表示后续还将推出更新版本。
4、Paradigm Machines 发布眼动预测基础模型 Orion:识别用户视线位置,UX 问题发现量提升 2 倍
AI 研究团队 Paradigm Machines 发布基础模型 Orion,尝试让 AI 预测人在使用软件时会看向哪里、如何转移注意力,并将这种视觉行为理解能力用于界面体验分析和计算机操作。模型基于真实眼动追踪数据训练,能够分析用户在界面上的注意力变化。团队已开放在线产品体验,支持连接 PostHog 会话回放识别潜在 UX 问题。
从真实眼动数据学习视觉注意力: Orion 利用用户实际操作过程中的眼动追踪数据训练。团队表示,数据规模较此前的视觉显著性模型扩大约 20 倍,并采用 Transformer 架构建模完整的计算机交互过程。
将视线预测用于 UX 问题分析: 开发者可连接 PostHog Session Replay,让 Orion 分析用户在页面中的注意力分布、操作路径及可能出现的交互阻碍。据团队公布的内部测试,发现的 UX 问题数量约为前沿通用模型的 2 倍。
探索计算机操作与机器人控制: 团队称,借助视线预测能力,其计算机操作任务延迟降低约 31%,并将模型用于无人机控制实验。相关结果尚缺乏公开的完整评测配置和可复现数据。
在线体验已开放: 目前可通过 Paradigm Machines 平台体验 Orion 的 UX 分析能力。尚未确认是否提供独立模型权重、公开 API 或完整技术报告。
https://app.paradigmmachines.ai
5、OpenAI 发布 Agents SDK v0.24.0-alpha.8:Session 支持 Realtime 语音接入,覆盖 WebSocket、WebRTC 与 SIP 通话
OpenAI 发布 Agents Python SDK v0.24.0-alpha.8 预览版本,为原生 Agent Session 新增 Realtime 语音能力,支持将实时音频交互、工具调用和会话历史放到同一个 Session 中管理。开发者可以通过服务端 WebSocket、浏览器 WebRTC 或已有 SIP 电话连接语音 Agent,并在工具执行前设置人工审批机制。
三种方式接入实时语音会话: 服务端可通过 WebSocket 管理音频收发;浏览器可通过 WebRTC 传输音频,由 Python 服务端处理 SDP 信令、Agent 状态及工具;对于已接入的 SIP 通话,可通过 Call ID 将现有 Session 挂接到实时电话连接。
Realtime 与原生 Session 共享上下文: 新增 agents.realtime.native 接口,可通过 session.realtime() 建立实时语音会话,支持音频和文本输入、实时事件订阅、工具调用及后台任务委派,语音连接结束后仍可继续使用原有 Session。
新增函数工具人工审批: 通过 needs_approval=True 在 Python 工具运行前暂停,允许应用检查参数后批准或拒绝,并可将决定保留到当前 Session 的后续调用。新版本还支持保存部分待审批工具请求及恢复执行状态。
当前为 Alpha 预览版本: 官方已在 GitHub 提供对应预发布版本与示例代码。开发者需要注意,浏览器 WebRTC 的媒体采集由客户端负责,Python SDK 提供的是服务端会话和控制能力,而非直接在 Python 中采集浏览器麦克风。
https://github.com/openai/openai-agents-python/releases/tag/v0.24.0-alpha.8
1、医疗 AI 公司 August 获 1200 万美元融资:Voice Agent 代用户致电医院,累计等待接通超 2.4 万分钟
11 月 16 日,医疗 AI 公司 August 宣布获得 Accel 和 Peak XV 投资的 1200 万美元融资,并推出面向美国医疗服务体系的 AI Agent。用户只需说明就医需求,August 就能代为致电医院、确认医生是否接受保险及预约时间,并在获得用户确认后完成预约。公司此前主要提供健康信息问答服务,创始人称已累计帮助超过 1000 万人理解健康问题。
通过电话 Agent 自动寻找医疗资源: August 可以根据用户所在地、保险计划和就医需求,逐一拨打诊所电话,核实医生是否仍在接诊、是否接受指定保险,并查询最早可预约时间。用户选择合适方案后,Agent 再完成预约。
早期测试累计等待接通 24286 分钟: 据创始人 Anuruddh Mishra 披露,过去几周 August 为早期用户寻找医生时,累计在电话中等待超过 2.4 万分钟,其中单名用户的任务就等待了 366 分钟。团队还表示,曾帮助另一名用户在保险理赔中节省 1255 美元。
保存诊所信息,减少重复拨号: August 会记录已核实的医院科室、保险接受情况及接诊状态,供后续任务复用。在旧金山的一次测试中,Agent 根据保险公司名录拨打 30 家诊所电话,发现其中 18 条信息有误,只有 1 家能够接收新患者。
面向美国用户开放 Beta 申请: 电话代办服务目前处于早期测试阶段,官网开放候补申请。除医生预约外,团队还计划扩展处方药库存查询、账单处理及保险理赔跟进等医疗行政事务。
https://x.com/anuruddh_m/status/2122374778074038613
2、Hume 正式停止 EVI 与 Octave TTS API 服务:转向 Audio Decisions 音频评测,定价每百万 Token 0.47 美元
11 月 13 日,美国语音 AI 公司 Hume 按此前公告正式停止提供 Empathic Voice Interface(EVI)和 Octave TTS API。EVI 曾主打根据用户语气和情绪调整语音回应,Octave 则提供富有表现力的语音合成及声音克隆能力。随着两项 API 退出,Hume 将开发者产品重心转向 11 月 2 日上线的 Audio Decisions API,通过直接分析音频,帮助开发者评估语音自然度、用户情绪及对话行为。
EVI 与 TTS API 于 11 月 13 日停止访问: Hume 早在 10 月 2 日发布停服通知,明确两项 API 于美国东部时间 11 月 13 日凌晨 12:01 结束服务。官方同时告知,账号中的相关数据将在该日期之后永久删除。
Audio Decisions 改为输出音频判断结果: 开发者可以上传音频并以自然语言提出问题,例如声音是否自然、通话者是否沮丧,或何时出现特定表达。API 返回概率、分数、选项分布或时间区间,不再负责生成语音回应。
按输入 Token 收费,提供开发者 SDK: Audio Decisions API 定价为每百万输入 Token 0.47 美元,输出结果不额外计费。提供 Python 和 TypeScript SDK,以及用于估算 Token 消耗、查询运行记录的 API。
持续升级低延迟音频分析: 11 月 16 日的更新进一步缩短评测响应时间。据官方测试,分析 10 秒音频、回答一个问题的处理时间中位数由 72ms 降至 42ms;当前支持最短 1 秒的音频输入,并将组织级请求速率上限提高至每分钟 600 次。
https://dev.hume.ai/audio-decisions/docs/overview
3、百度一镜发布自研视频生成模型:成本低至每秒 0.2 元,全画幅实时数字人响应低于 2 秒
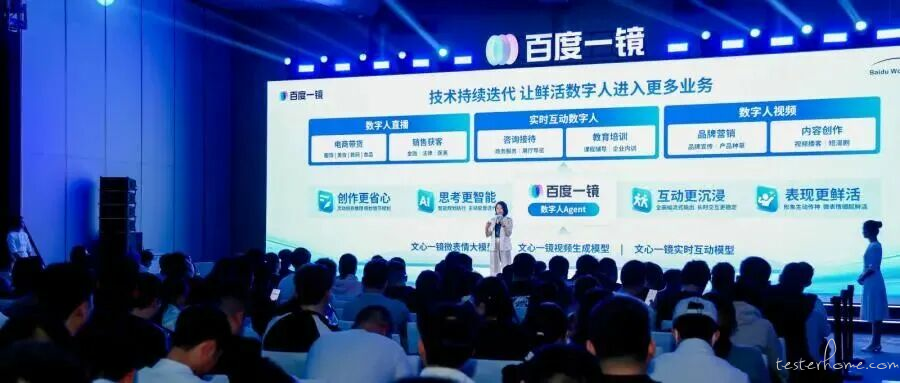
11 月 12 日,在百度世界 2026 大会上,百度一镜宣布视频生成、微表情控制和实时交互三项能力升级。新模型通过混合扩散蒸馏和稀疏化建模降低推理成本,Fast 版本实现视频时长与生成耗时 1:1;实时数字人则支持全画幅流式生成,官方公布的响应延迟低于 2 秒。文心一镜微表情模型已同步上线百度智能云千帆平台。
视频生成成本低至 0.2 元/秒: 采用混合扩散蒸馏与稀疏化建模压缩推理开销,官方称 Fast 版本可在 10 秒内生成 10 秒视频。0.2 元/秒为公布的生成成本指标,不等同于所有 API 的实际调用价格。
微表情模型支持 AU 级控制: 文心一镜微表情大模型采用文本、视觉、语音联合建模,通过 6 个维度及 200 多个子维度刻画面部表情、动作和情绪,每秒最多呈现 8–9 种微表情,并支持篇章级配音和最长 4000 字文本驱动。
全画幅实时交互响应低于 2 秒: 新方案将数字人生成从局部动作扩展至全画幅,通过自回归架构、检索式记忆和流式输出支持持续互动。百度表示,系统可根据用户讲话实时生成表情及动作,面向客服、导购、直播和陪伴场景。
微表情模型 API 已开放: 开发者可通过百度智能云千帆调用 ERNIE-Wizshot-ME 视频生成接口,创建生成任务并查询结果。百度还同步推出「短漫剧 Studio」,通过剧本 Agent 与成片 Agent 协同完成短剧制作及一键转绘。目前公开的视频生成 API 不应直接等同于数字人实时音视频交互接口。
https://cloud.baidu.com/doc/qianfan-api/s/8mwbylac7
https://cloud.baidu.com/doc/qianfan-api/s/Imwc2p4go
https://tech.youth.cn/wztt/202611/t20261113_16965269.htm
1、Sam Altman:没有黄仁勋,AI 行业仍能继续发展
据 TechCrunch 报道,11 月 16 日,OpenAI CEO Sam Altman 在 Semafor 举办的「Silicon Valley & The World」活动上首次公开谈及黄仁勋辞去英伟达 CEO 一事。
他认为,尽管黄仁勋对 AI 行业的发展至关重要,但即使没有他的领导,AI 行业仍能继续发展。Altman 表示,目前 AI 市场需求旺盛,相关收入和需求都在快速增长,因此他相信整个行业不会受到太大影响。不过,他也强调,黄仁勋凭借非凡的雄心推动了行业发展,很难想象没有黄仁勋及其创办的英伟达,AI 革命会是什么样子。谈及黄仁勋是否应该重返英伟达,Altman 则表示,自己对事件了解不够,无法作出判断。
他还称黄仁勋一直是自己心目中的英雄,但「英雄也有缺点」,并提起自己在 2023 年遭 OpenAI 董事会罢免、随后重新出任 CEO 的经历,对黄仁勋目前的处境表示同情。与此同时,据 CNBC 和 CBS News 援引知情人士消息,英伟达董事会目前并未考虑让黄仁勋重返公司。董事会仍将重点放在针对黄仁勋的调查上,即使已有超过 18 万人联署支持其回归,董事会也无意让他重新担任 CEO 或其他职务。
( @APPSO)
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、Bluejay 发布 Voice AI 技术全景图:从级联架构、端到端模型到全双工语音交互
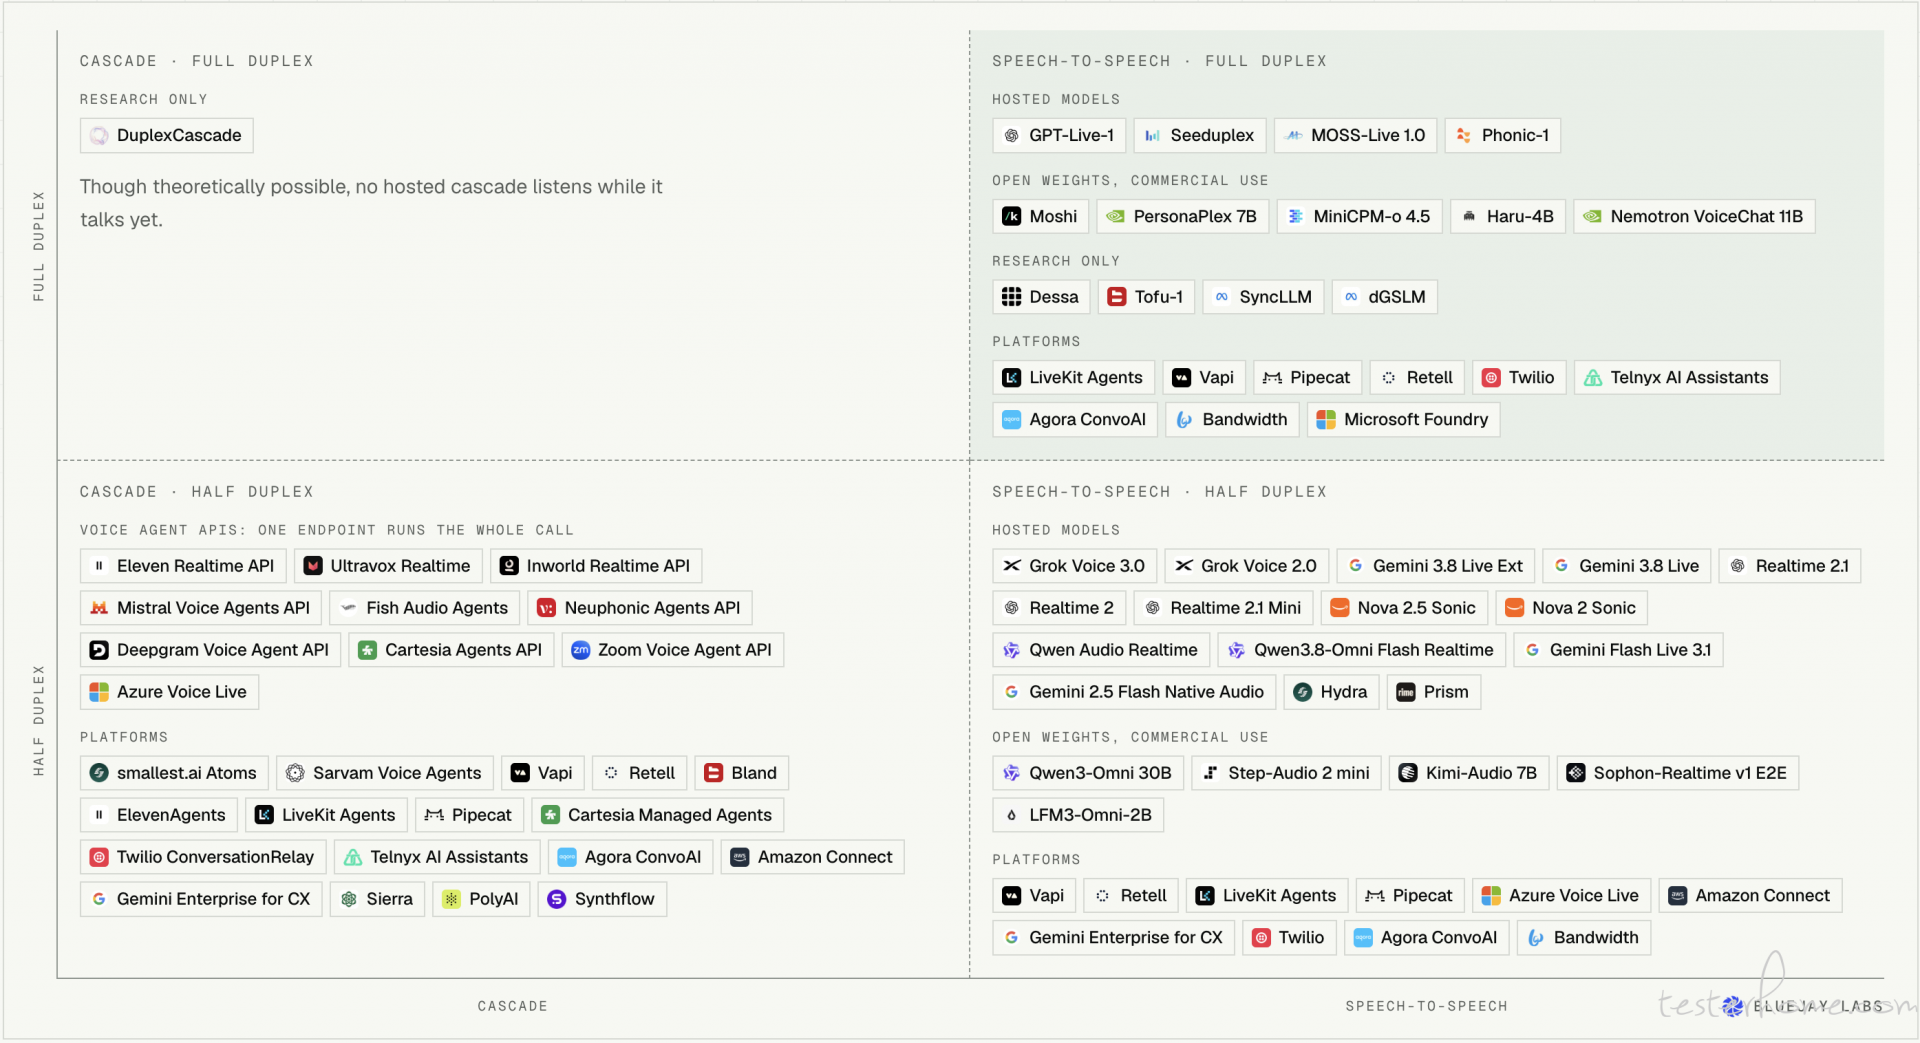
美国 Voice AI 测试与评测公司 Bluejay 整理了一份 Voice AI 技术全景图。
这份图谱从架构角度梳理语音智能体的主要技术路线,涵盖传统 ASR–LLM–TTS 级联方案、端到端 Speech-to-Speech 模型,以及支持边听边说、实时打断和自然接话的全双工语音架构,帮助开发者了解不同方案在流式处理、交互延迟和轮次控制等方面的技术差异。
Bluejay 创始团队来自 AWS Bedrock 和 Microsoft Copilot,也是 YC 2025 春季批次公司,曾获得 400 万美元种子轮融资,主要为语音 Agent 提供对话模拟、自动化评测和生产环境监控。
https://research.getbluejay.ai/whitepapers/voice-ai-landscape
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与 「RTE 开发者日报」 内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考
