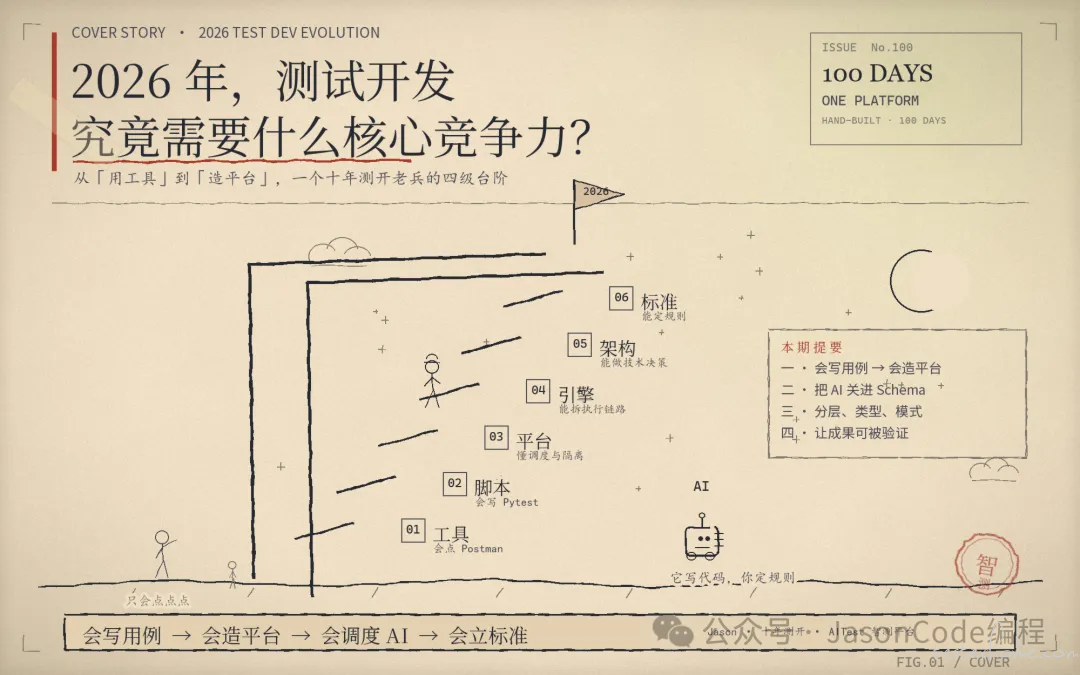
从「用工具」到「造平台」,六级台阶只是一条路,真正的分水岭在第 3 级和第 4 级之间。
导语:最近在整理这套手搓了 100 天的 AITest 全栈测开平台代码,准备去申请国家软著。几十个 G 的工程文件摊在硬盘里,从第一行 main.py,到异步执行引擎、权限模型、前端工作台,一层一层翻下去,翻到凌晨一点。
我突然停下来问了自己一个问题:2026 年了,一个测试开发的核心竞争力, 到底是什么?
大模型满天飞,Cursor 和各类 AI 编程助手正在以肉眼可见的速度接管初级 编码工作。AI 能写接口自动化脚本,能生成 Pytest 用例,甚至能照着截图把 Selenium 代码凑出来。如果你今天问一个测试同学"你的核心竞争力是什么",他 回答"我会用 Postman 调接口"、"我会写 Pytest 脚本"、"我会用 Selenium 点点 点"——那这大概是他在这个行业里埋下的最大一颗雷。
不是这些工具不重要,而是它们正在从"竞争力"变成"基本功"。就像十年前" 会用 Linux"是加分项,今天它只是入场券。入场券不会让你被淘汰,但只拿着入 场券的人,永远坐不到主桌。
结合我 10 年的测开经验,以及这 100 天从零造轮子的实战,我想认真聊聊: 2026 年,一个高级测试开发到底该靠什么立足。
从「用工具」到「造平台」,六级台阶只是一条路,真正的分水岭在第 3 级和第 4 级之间。
以前,我面过一个五年经验的测试工程师。
简历很漂亮:精通 Pytest、熟练 Postman、熟悉 Selenium,做过三个"自动化平台"。我问他 fixture 的生命周期,他答得条理清晰;我问他 Page Object 的边界,他也说得头头是道。
然后我换了个问法:
"如果现在有 500 条用例要并发跑,其中有一条卡住了,不超时、不报错、就是不返回。你在不修改任何一条用例的前提下,怎么在三分钟内定位到它?"
他沉默了大概三十秒,说:"可以……加日志?"
我又问:"日志加在哪里?是加在用例里,还是加在执行器里,还是加在调度层?这 500 条用例共用几个进程、几个数据库连接、几个事件循环?"
他没再说话。
那一刻我其实不是在为难他。我是在确认一件事:他做过的是"用工具跑用例",却从未"造一个能跑用例的系统"。 这两件事在 2020 年可以混为一谈,但在 2026 年,它们之间已经隔了一条很深的沟。
这条沟的名字,叫"AI 把执行层吃掉了"。
我不喜欢贩卖焦虑,所以先把话说平。
大模型确实已经能写出能跑的测试代码了。给它一个 Swagger 文档,它能生成接口用例;给它一段 PRD,它能生成场景用例;给它一张截图,它能生成 Playwright 脚本。这些在两年前还需要一个初级测试写半天,现在几十秒。
所以"会写用例"这件事,正在从技能变成常识。
但请注意"贬值"和"消失"是两回事。计算器普及之后,会计没有消失,只是"会打算盘"不再值钱了。AI 普及之后,测试不会消失,只是"会把需求翻译成 if-else"不再值钱了。
那么什么在升值?我在自己的项目里观察到三个方向:
把不确定的东西变成确定的系统——AI 输出是不确定的,但系统必须是确定的;
把一次性的东西变成可复用的底座——用例是一次性的,平台是资产;
把"我做过"变成"可被验证"——在信息过载的招聘市场,可验证性本身就是稀缺品。
这三件事,恰好对应我下面要讲的四级台阶。
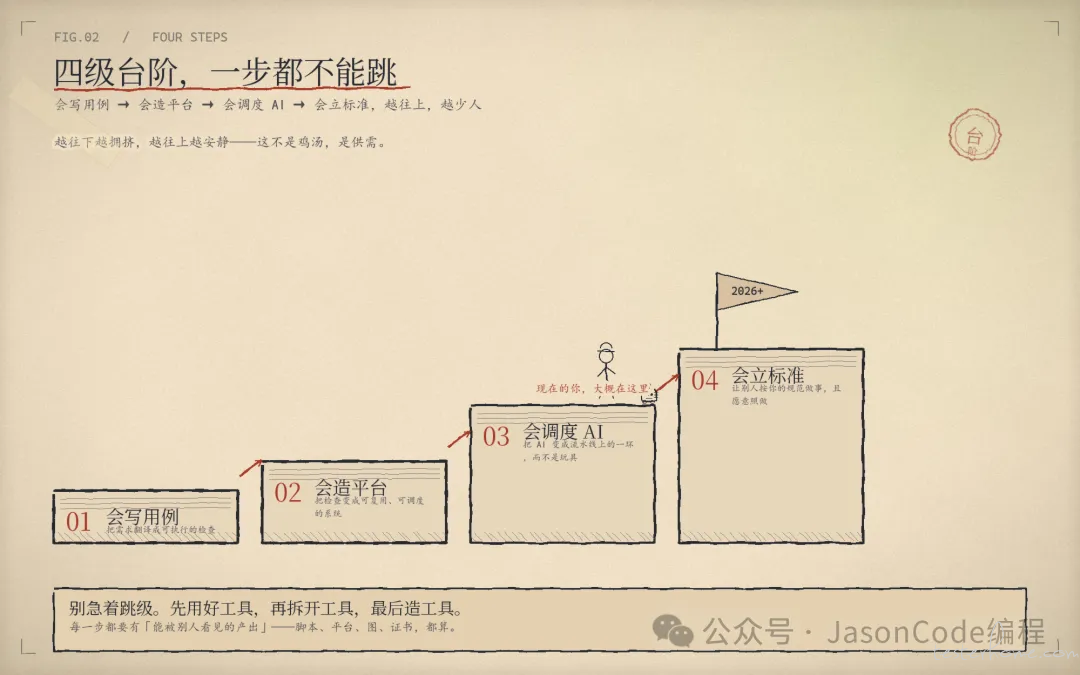
四级台阶:会写用例 → 会造平台 → 会调度 AI → 会立标准。越往上人越少,不是因为它更难学,而是因为它要求你先"做完过"一件完整的事。
我在过去 100 天里,用 FastAPI + Vue3 从零写了一支测试平台,代号 AITest,V1.0 大概几十个 G 的工程文件(含依赖和构建产物,纯代码量没那么夸张,别被这个数字吓到)。
写的过程中最大的感受不是"功能好多",而是:功能是可以堆的,底座是堆不出来的。
什么叫轮子?Postman 是轮子,Pytest 是轮子,JMeter 是轮子。它们各自解决一个很具体的问题,而且解决得很好。
什么叫底座?底座是当这些轮子同时转起来时,谁来管它们的转速、油量和互相咬合。
举个特别具体的例子。
我的平台第一版,执行逻辑是这么写的:接口收到"开始执行"的请求 → 在请求处理函数里直接 asyncio.run(run_suite(...)) → 跑完返回结果。
本地跑十条用例,完美。压测到 50 并发,崩了。
崩的现象很有迷惑性:不是报错,是越来越慢,最后整个服务不响应。查了三个小时,发现是数据库连接数只增不减,直到打满 max_connections。
根因说出来很简单:
asyncio.run() 每次调用都会新建一个事件循环,跑完再销毁。而 SQLAlchemy 的 AsyncEngine 内部维护一个连接池,连接池里的连接是绑定在创建它的那个事件循环上的。第一个循环死了,连接还留在池子里;第二个循环起来,拿到一个"属于死循环"的连接,于是报 attached to a different loop,或者干脆静默挂起。
这不是 Pytest 的错,也不是 Celery 的错,更不是 SQLAlchemy 的错。错在我把"执行"这件事放在了请求线程里,而请求线程的生命周期,比执行任务短得多。
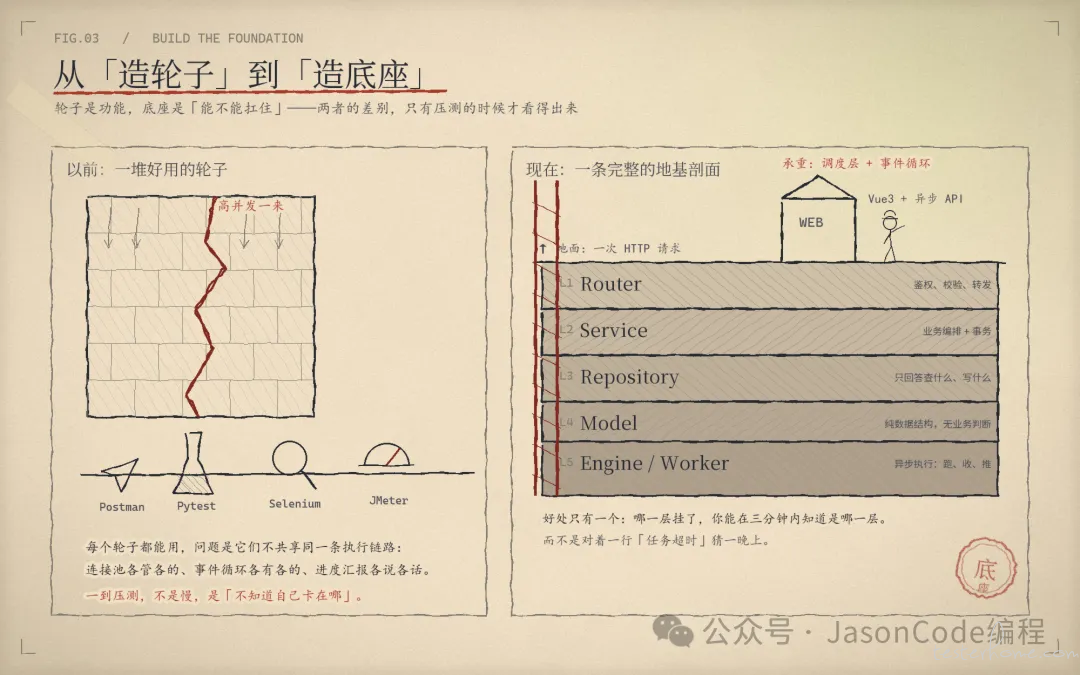
左边是一堆好用的轮子,右边是一条完整的地基剖面。差别不在功能多少,在地基能不能承重。
想通这一点之后,我重写了整条执行链路,做了三个决定。这三个决定后来成了整个平台的骨架。
决定一:执行必须在进程外。
Web 进程只负责"接单"和"查单",不负责"干活"。真正的执行发生在独立的 worker 进程里。这样做的好处不只是不阻塞,更重要的是:执行可以失败、可以重启、可以被 kill,而 Web 服务不受影响。
决定二:事件循环归 worker 所有,连接池跟着 worker 的生命周期走。
worker 启动时建循环、建连接池;worker 退出时一起销毁。绝不跨循环复用连接池,也绝不在调度层调 asyncio.run()。这一条听起来像废话,但我见过至少三个平台在这上面翻车。
决定三:进度靠推送,不靠轮询。
前端不再每两秒问一次 “跑到哪了”,而是建立 WebSocket,服务端在用例级别推送增量事件。
虽然 Redis 的 Pub/Sub 通道本身是有序的,但在真实的弱网环境下,WebSocket 连接的抖动可能会导致消息延迟。为了避免前端因为网络重连导致 “进度条倒退”,我的设计是:前端并不完全依赖推送的消息来累加状态,而是把 WS 推送作为 “触发器”。
每次收到 step 进度事件,前端会带上 execution_id 重新拉取一次最新的 REST 快照数据,确保展示的永远是数据库里最真实的执行状态。这种 “推拉结合” 的兜底机制,彻底解决了弱网下的状态不一致问题。
就这三条,把一个"能跑的脚本集合"变成了"能扛住的执行系统"。
讲完上面三条,很多人以为底座就搭完了。没有。
平台里有一类数据特别讨厌:频繁读取但极少变动的数据。比如:用户的权限矩阵、接口目录树、用例目录树。这类数据每次请求都要读,天然适合放 Redis 缓存。但在高并发下,一旦数据发生变更,缓存该怎么失效?
我第一版的做法是最暴力的:只要改了数据,就把相关的缓存全部 DEL 掉。
这听起来没问题,但在实际跑起来后,遇到了两个极其诡异的坑:
第一种,修改权限后。部分用户依然 “无权访问” 或 “权限过大”。因为我是按用户去删缓存的,如果有 1000 个用户属于这个角色,我难道要循环删 1000 个 key 吗?网络开销极大;而如果只删了当前操作人的缓存,其他已经缓存了旧权限的用户,在 TTL 过期前依然保留着旧权限。
第二种,缓存击穿。如果我把某棵目录树缓存全删了,恰好此时有一波高并发请求涌入,所有请求同时发现缓存 miss,全部打向 PostgreSQL,数据库瞬间被打满。
我的解法不复杂,但极度有效,且是我认为企业级系统必须掌握的:
全量失效用 “全局版本号”:对于 RBAC 权限,不直接删用户的 key,而是在 Redis 维护一个 permissions:version。用户权限的缓存 key 是 user:perm:{uid}:{version}
。一旦角色权限变更,直接 INCR 版本号。所有用户瞬间自动读取新版本的缓存,旧缓存靠 TTL 自然过期。这就是优雅降级。
精准失效配合随机过期:对于目录树这类缓存,写操作后只精准 DEL 对应的 project_id 缓存,并在基础 TTL 上加 0~120 秒的随机抖动,避免同一时刻集体失效;
关键状态不缓存:执行任务的进度条、最终态(成功/失败/取消),绝对不从缓存读。前端 WebSocket 触发更新后,直接查库。宁可慢几十毫秒,也绝对不能因为缓存不一致导致 “进度条往回跳” 或者 “任务假死”。
这里我想强调一个观点:缓存一致性不是 “高级话题”,是平台的及格线。 你可以在面试里大谈分布式,但如果你的平台连 “修改权限后立即生效” 和 “目录树不崩” 都做不到,那说明你还没真正跑过一次高并发。
原稿里"系统 - 组织 - 项目三层 RBAC"这句话太抽象,容易被当成名词堆砌。这里展开一下。
三层不是三张角色表,而是三个权限作用域:
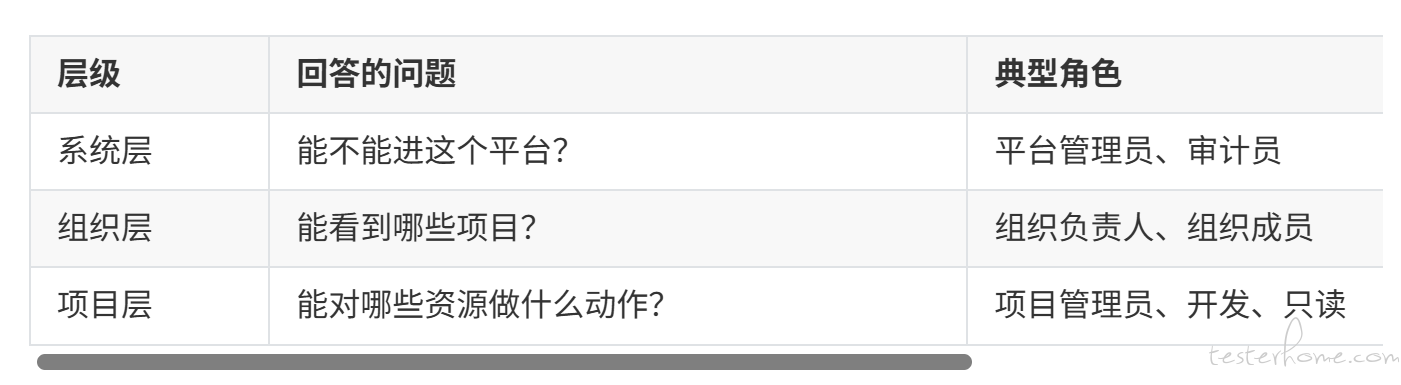
判定顺序是"项目 > 组织 > 系统",并且采用 deny-overrides(显式拒绝优先):任何一层显式拒绝,最终结果就是拒绝。
为什么顺序不能反?因为最常见的 bug 就是"组织管理员把项目管理员挤掉":组织层给了 project:read,项目层没给,如果按"任一允许即通过"的逻辑,这个人就能看项目;但如果项目层明确写了"禁止访问",就应该以项目层为准。
再加两条工程约束:
权限点用常量枚举,不用字符串裸写,否则半年后没人知道 "task:create" 和 "task:add" 是不是一回事;
每次鉴权都记录决策日志(谁、在哪个作用域、命中哪条规则、结果如何),出问题时能复盘,这也是审计要求的底线。
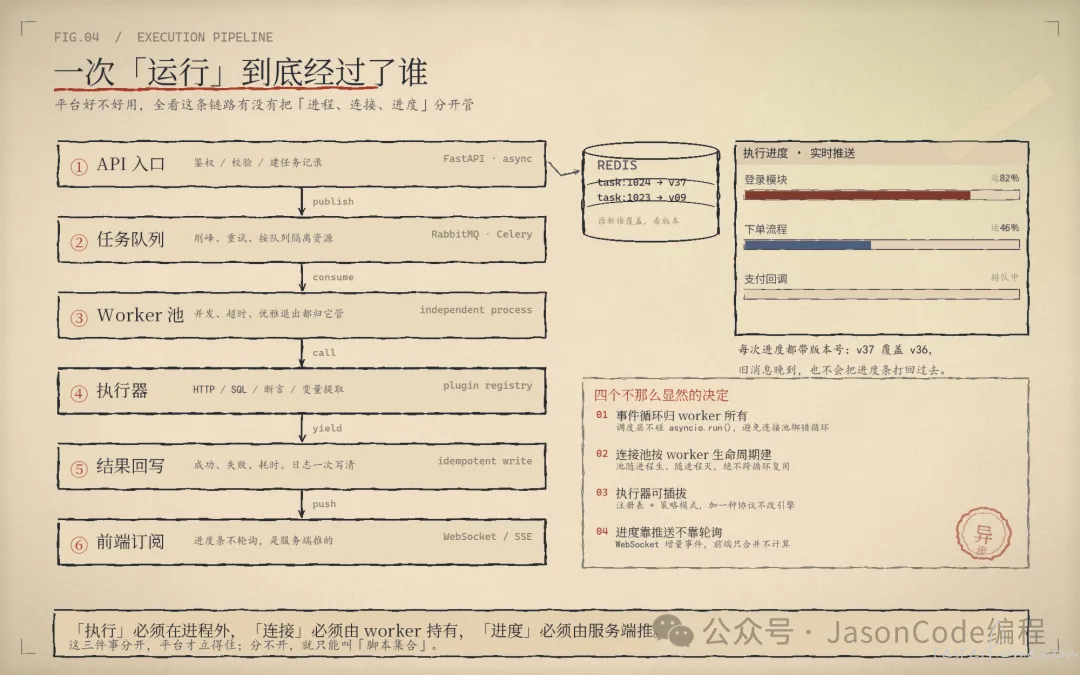
一次"运行"经过的六个环节。注意 ③ 和 ④ 之间是进程边界,⑤ 和 ⑥ 之间是推送而不是轮询——这两条边界,就是平台和脚本的分水岭。
这里我要特别澄清一句,因为原稿里我写的是"放弃 Pytest",这个说法不准确,也容易招骂。
我没有放弃 Pytest,我是把它从"平台的心脏"降级成了"平台的一种执行器"。
Pytest 的设计假设是:执行发生在进程内、同步、短生命周期。它非常适合"在 CI 里跑一遍、出个报告"这个场景,至今依然是我做单机自动化的第一选择。
但一个 Web 化的执行平台,假设完全不同:执行是进程外、异步、可中断、可观测的。这两套假设硬拼在一起,问题不在任何一方,而在"谁来管进程、谁来管连接、谁来管进度"这条边界上。
我手搓引擎,不是为了证明 Pytest 不行,而是为了把这条边界握在自己手里。执行器只做一件事:拿到一个用例,跑完,吐出一个结构化的结果。至于这个执行器内部是用 Pytest、用 Playwright,还是直接 httpx,引擎不关心。
这就是策略模式的价值:引擎负责调度,执行器负责干活,两者通过一个稳定的接口解耦。 加一种新协议,只需要注册一个新执行器,引擎一行不改。
# 执行器接口:引擎只认这个契约
class BaseExecutor(ABC):
    name: str
    @abstractmethod
    async def run(self, case: Case, ctx: RunContext) -> CaseResult:
        ...
class HttpExecutor(BaseExecutor):
    name = "http"
    async def run(self, case: Case, ctx: RunContext) -> CaseResult:
        req = build_request(case, ctx.variables)
        resp = await ctx.client.send(req)
        return evaluate(case.assertions, resp)
# 注册即可,不碰引擎
registry.register(HttpExecutor)
如果你想知道自己是不是"过了这一级",别看自己会不会用框架,看这三个问题能不能答上来:
你的执行任务,跑在哪个进程里?它的生命周期由谁管?
你的数据库连接池,绑定在哪个事件循环上?跨循环复用过吗?
你的用例跑到一半,用户关掉页面,任务会停吗?会污染下一次执行吗?
三个都能答清楚,你就在造底座。答不清楚,说明还在造轮子——这不丢人,但要知道自己在哪。
补一个我真实的翻车记录: 重构之前,我一度以为是"并发太高",所以把 worker 数量从 4 调到 16,结果崩得更快。后来才明白,问题不在并发数,在每个 worker 都各自建了一个连接池,加起来把数据库连接数顶爆了。调参救不了架构,只能重写。
这件事让我记住一句话:性能问题,先看边界,再看参数。
现在很多人有个误区:"AI 都会写代码了,我还学什么编程?"
这句话的问题在于,它把"写代码"等同于"做系统"。
你让 AI 写一个计算器,它一秒生成,还带单元测试。你让 AI 搭一套包含"系统 - 组织 - 项目三层 RBAC、异步执行引擎、多租户隔离"的企业级平台,它会给你生成一堆看起来很像、但跑不起来的东西。
不是因为它笨,是因为它不知道你的约束。
它不知道你的租户隔离是"共享库共享表 + tenant_id"还是"独立 schema";它不知道你的权限判定是"任一允许"还是"显式拒绝优先";它不知道你的任务重试是"幂等重投"还是"补偿事务"。这些都不是代码问题,是设计决策问题。
AI 能写代码,但它不替你做决定。
所以在 2026 年,测开的核心竞争力不是"手写 CRUD 的速度",而是你能不能把"不确定的 AI"塞进"确定的系统"里。
我在 V2.0 里给 AI 加了三道闸门,顺序不能乱。
第一道:Schema 校验。
所有 AI 的输出,必须先过一个强类型的 Pydantic 模型。字段类型不对、枚举值不在范围内、必填项缺失,直接拒绝,连重试都不给。
from typing import Literal
from pydantic import BaseModel, Field, field_validator

class Assertion(BaseModel):
    target: str = Field(min_length=1)
    op: Literal["eq", "ne", "contains", "regex", "lt", "gt"]
    expected: str | int | float | bool

class GeneratedCase(BaseModel):
    name: str = Field(min_length=2, max_length=80)
    method: Literal["GET", "POST", "PUT", "DELETE", "PATCH"]
    path: str = Field(pattern=r"^/")
    assertions: list[Assertion] = Field(min_length=1, max_length=20)
    timeout: int = Field(default=30, ge=1, le=120)
    retries: int = Field(default=0, ge=0, le=2)
    @field_validator("path")
    @classmethod
    def no_template_left(cls, v: str) -> str:
        if "{{" in v:
            raise ValueError("路径里还有未解析的变量")
        return v
这段代码不长,但它做了一件很关键的事:把"AI 可能胡说"这件事,变成了"类型系统会拦住"这件事。
第二道:语义校验。
Schema 只能保证"形状对",保证不了"逻辑对"。比如:断言里引用的变量,前面的步骤有没有提取过?请求的依赖顺序对不对?一个 POST /orders 的用例,前面却没有创建商品?
这一层我用的是规则引擎 + 轻量 LLM 复核:先用确定性规则跑一遍(快、便宜、可解释),规则覆盖不到的模糊地带,再让模型判断,但模型的输出依然要过 Schema。
第三道:兜底。
校验不过怎么办?重试一次;还不过,转人工确认,并且不允许写入用例库。
这一条最容易被忽略,但最重要。幻觉最大的危害不是"生成得烂",而是"烂的东西进了库,被当成资产复用"。 一旦脏数据混进用例库,后面所有的统计、回归、度量全部失真。
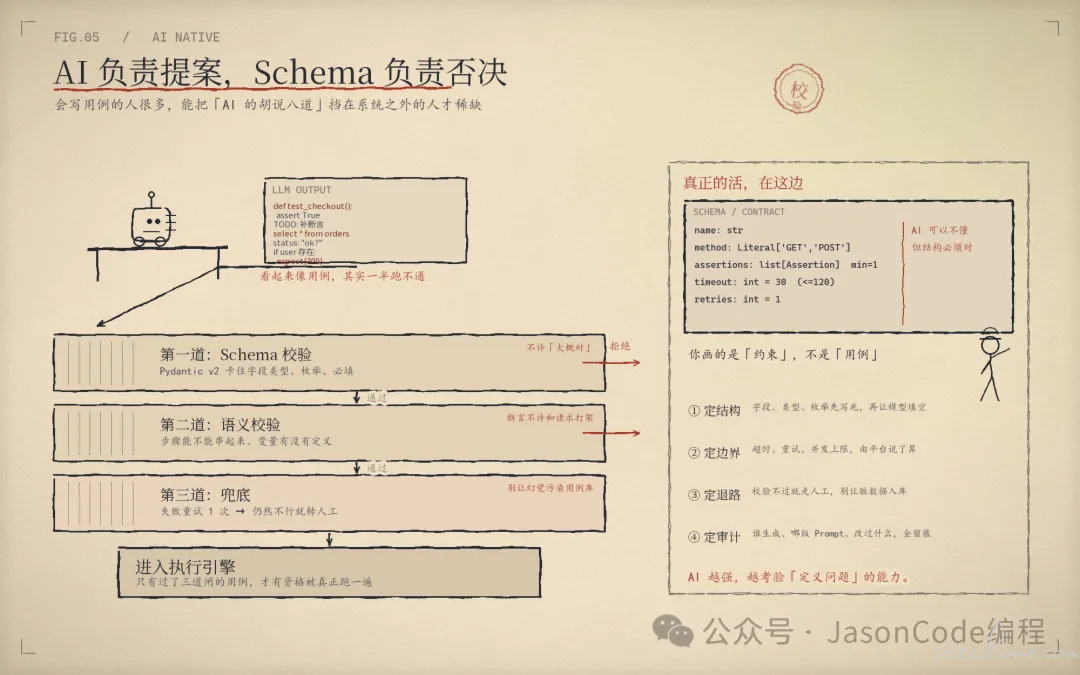
AI 负责提案,Schema 负责否决。真正值钱的不是"让 AI 生成",而是"让 AI 生成的东西能安全地进入系统"。
原稿里我提到 LangGraph 和 MCP,这里补充一点更实际的判断。
LangGraph 这类编排框架,解决的是"多步骤、有状态、可回退"的问题。 它不是银弹。如果你的场景是"给一段需求生成 20 条用例",一次调用就够,上 LangGraph 是过度设计。但如果你的场景是"读需求 → 查历史用例 → 生成 → 跑一遍 → 根据失败原因修正 → 再跑",那它确实比你自己写状态机靠谱。
MCP 的价值在于"把工具标准化"。 它让模型能用统一的方式调用你的执行器、你的用例库、你的环境管理。这件事的意义不在于"炫技",而在于降低接入成本:你写一次 MCP Server,所有支持 MCP 的客户端都能用。
但我要提醒一句:别为了用而用。 我见过太多"AI 测试平台",Agent 编排得很花哨,最后跑出来的用例还不如一个模板生成器。判断标准只有一个:它有没有让你的回归测试更快、更准、更省人。
你的 AI 输出,有没有强类型约束?约束写在哪一层?
校验失败时,你的系统是"重试"、"降级"还是"转人工"?有没有防止脏数据入库?
你的 Prompt 改版之后,有没有回归测试?怎么知道新版本没有变化?
第三个问题,90% 的人答不上来。而这恰恰是"工程化"和"玩票"的分界线。
我先讲一个反例。
我见过一个平台,所有业务逻辑都写在 router 里。一个 create_task 接口,函数体 400 行:参数校验、权限判断、任务落库、消息投递、日志埋点,全在里面。
后来业务要加一个"任务模板"功能,需要复用"创建任务"的逻辑。开发者怎么办?复制粘贴。于是同一段逻辑有了两份,改一处忘一处,两个月后两个入口的行为开始不一致。
这就是不分层的代价:它不是"代码丑",它是"改不动"。
我现在强制自己遵守一条线:Router 只做三件事——鉴权、校验、转发。
router.post("/tasks", response_model=TaskOut)
async def create_task(
    payload: TaskCreate,
    user: User = Depends(current_user),
):
    # 1. 鉴权:这个用户能不能在这个项目里建任务
    await perm.require(user, payload.project_id, "task:create")
    # 2. 校验:payload 已由 Pydantic 完成
    # 3. 转发:业务逻辑一律在 service
    return await task_service.create(payload, operator=user)
Service 层负责编排和事务边界,Repository 层负责数据访问,Model 层只描述数据结构。每一层的职责用一句话能说清,说不清就是设计有问题。
我现在的项目,mypy --strict 是开着跑的,ruff 是提交前强制跑的。
不是为了"显得专业",是因为类型注解是最便宜的一种测试。它不需要你写断言、不需要你 mock、不需要你跑 CI,IDE 在保存文件的那一刻就告诉你了。
举个最小的例子:
# 没有类型:调用方永远不知道会拿到什么
def get_task(task_id):
    ...
# 有类型:调用方、IDE、CI 三方都能检查
async def get_task(task_id: int) -> TaskDetail | None:
    ...
再往上一层,Pydantic v2 是把"运行时校验"和"类型系统"缝在一起的关键。请求体、响应体、配置、AI 输出,全部走 Pydantic 模型。好处是:边界处的数据永远是干净的,内层代码可以放心假设"它是对的"。
测试技能这块特别典型。HTTP 请求、SQL 查询、断言、变量提取、等待、循环……如果写成 if-else,代码会长成这样:
if step.type == "http":
    ...
elif step.type == "sql":
    ...
elif step.type == "assert":
    ...
elif step.type == "extract":
    ...
每加一种技能,就要动一次这个函数。函数越来越长,回归风险越来越大。
用策略模式 + 模板方法,结构会变成:
class StepHandler(ABC):
    type: str
    async def execute(self, step: Step, ctx: RunContext) -> StepResult:
        """模板方法:固定骨架,子类只实现钩子"""
        self.before(step, ctx)
        try:
            result = await self.do_execute(step, ctx)
        except Exception as e:
            result = StepResult.failed(step, e)
        self.after(step, ctx, result)
        return result

    def before(self, step, ctx): ...

    def after(self, step, ctx, result): ...

    @abstractmethod
    async def do_execute(self, step, ctx) -> StepResult: ...
class HttpStep(StepHandler):
    type = "http"
    async def do_execute(self, step, ctx):
        ...
加一种技能 = 加一个类 + 注册。老代码一行不动。
这就是"开闭原则"在测试领域的真实价值:不是学术概念,是"你敢不敢在发版前一天加功能"的底气。
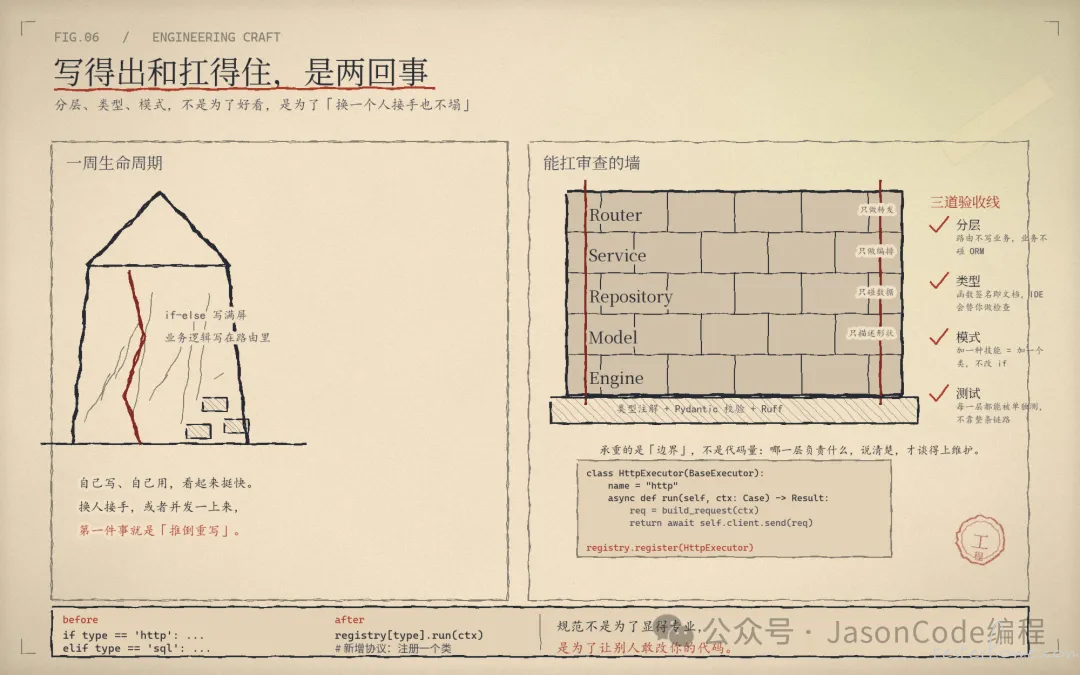
左边是一周就塌的房子,右边是能扛审查的墙。区别不在代码量,在"边界"有没有说清楚。
你的 router 里,有没有超过 100 行的函数?
你的核心链路,mypy --strict 能过吗?
加一种新的测试技能,需要改几个文件?超过两个,就说明抽象没做好。
最近,我耗时 100 天独立研发的 AITest 智测平台 V1.0 已经正式提交了软 著申请。加上我以往工作期间主导产出的 6 项发明专利(其中 3 项已授权)和 1 项软著, 这套知识产权矩阵,是我在这个行业里最硬的底气之一。
为什么我这么看重这件事?因为它解决的是信任问题。
大厂面试官每天看几百份简历,人人都写"独立负责 XX 平台"。他无法验证。 而一张软著、几项授权专利传递的信息是完全不同的:
这个人的产出经过了第三 方机构的审查与登记,他具备从 0 到 1 独立落地企业级系统的完整闭环能力。
这不是培训班三个月包装出来的项目能给你的东西。
这里多说一句掏心窝的:软著的价值不在证书本身,而在准备材料的过程。整理这 60 页代码文档的时候,你被迫重新回答一连串问题——这个模块为什么存在?分层边界在哪?哪些是核心创新点?这个过程本身就是一次全面的架构复盘。证书是副产品,复盘才是收益。
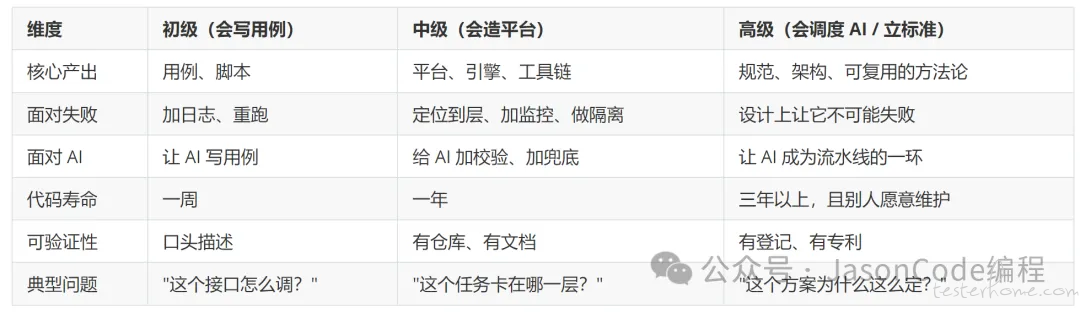
这张表不是用来制造鄙视链的。它的用处是:让你知道自己下一步该补什么,而不是什么都学。
Q1:我不做平台,只做业务测试,是不是就没戏了?
不是。平台的形态很多:一个稳定的测试数据工厂、一套可复用的契约测试方案、一个能自动定位失败的归因工具,都是"底座"。关键不在"平台"两个字,在"你有没有把一次性的劳动变成可复用的资产"。
Q2:前端要不要学?学到什么程度?
要学,但不用学到能写生产级前端。你需要的是能看懂组件、能改交互、能和前端对齐接口。我自己的前端水平大概就是"能写页面、能调样式、性能优化靠查文档",但这已经足够让我设计的平台交互不反人类了。
Q3:AI 都能生成用例了,我还需要手写吗?
需要,但目的变了。手写是为了建立判断力——你得先知道"好用例长什么样",才能判断 AI 生成的是好是坏。就像编辑可以不自己写稿,但必须能改稿。
Q4:软著和专利,对跳槽真的有用吗?
有用,但作用被高估了。它们的真实作用是降低对方的验证成本:面试官不用猜"这个项目是不是买的",他可以顺着证书和代码往下问。但如果你答不上追问,证书反而会加速暴露问题。 所以顺序不能反:先有真东西,再要证书。
如果你现在还在点点点,或者只会用现成的框架,别慌。
转型不是让你明天就去手写一个 Redis,也不是让你辞职去造平台。它是一系列很小的、可积累的动作:
第一件事:读一次源码,只读一个函数。
别一上来就啃 Pytest 全部源码。挑一个你天天用、但从来没看懂的东西,比如 pytest.fixture 的作用域是怎么实现的,或者 FastAPI 的 Depends 是怎么做依赖注入的。读懂一个函数,比收藏十篇"源码解析"有用。
第二件事:给你的脚本加一道校验。
下次用 AI 生成用例,别直接复制粘贴。写一个 Pydantic 模型,让它必须过校验才能入库。你会发现,光是这一道闸,就能挡掉 30% 的垃圾。
第三件事:画一张你自己的架构图。
不用很漂亮,纸上画就行。把"请求从哪进来、经过谁、存到哪、怎么出去"画清楚。画不出来的地方,就是你还没想清楚的地方。
第四件事:做一个小到能做完的东西。
不要一上来就"做个平台"。先做一个"能跑 100 条用例、能看到进度、能导出报告"的最小闭环。做完它,你才算真正跨过第一级台阶。
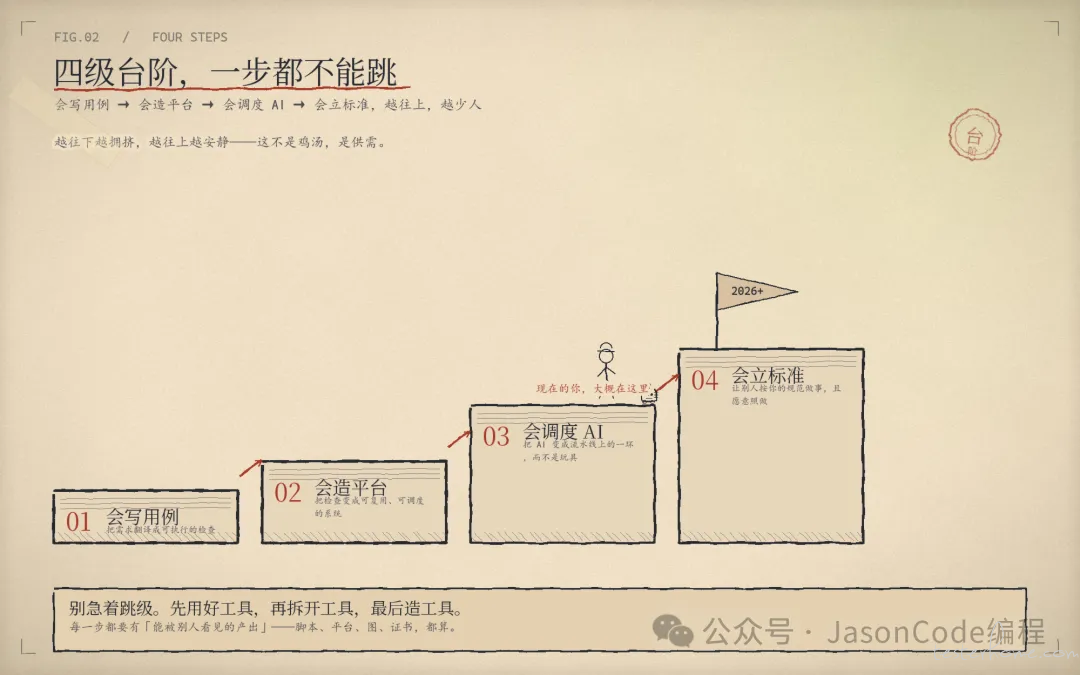
四级台阶。先看清自己在第几级,再决定往哪走——比"什么都学"更重要。
写了这么多,其实我想说的只有一句:
2026 年,测试开发的核心竞争力,不是"会用多少工具",而是"能不能把不确定的事情,变成确定的系统"。
AI 让"写代码"变便宜了,但让"做对的决定"变贵了。因为当生成成本趋近于零时,判断力就成了唯一的稀缺品。
判断什么?
判断哪个问题值得用一个平台去解,判断哪一层该由谁负责,判断 AI 的输出什么时候可以信、什么时候必须拦,判断一个方案在半年后会不会变成技术债。
这些东西,没有一门课能教完,只能靠你亲手做完一件事,然后被它折磨一遍。
我是 Jason,独立开发者,十年测试开发经验老兵,架构师。
2026 年,让我们一起从 “用工具”,进阶到 “造平台”。
Jason,10 年测试开发经验老兵,架构师。曾主导产出 6 项发明专利(3 项已授权)、1 项软件著作权。
耗时 100 天独立研发 AITest 智测平台(涵盖异步执行引擎、三层 RBAC 权限、AI 智能用例、多租户隔离等核心模块),目前 V1.0 版本已整理完毕,正在准备提交国家计算机软件著作权申请。
如果你对这套平台的底层架构设计感兴趣,或者想探讨源码实现的取舍细节,欢迎在评论区留言,或直接在主页联系我交流。2026 年,让我们一起从 “用工具” 进阶到 “造平台”。
