本期编辑:@ 三水 @ 鲍勃
1、NVIDIA 开放语音转录模型 Nemotron 3.5 Transcribe:识别多人重叠发言,统一支持 40 种语言转录与音频理解
NVIDIA 发布开放权重语音模型 Nemotron 3.5 Transcribe,采用混合专家(MoE)架构,总参数约 340 亿、激活参数约 43 亿。模型将语音识别、说话人分离、翻译和音频理解整合到单一模型中,可处理最长 1 小时的录音,并通过自然语言指令控制转录方式。
识别多人重叠发言并标注说话人: 最多区分 8 名说话人,能够在多人同时讲话时识别各自内容,并输出带说话人标签的逐词时间戳。模型在 VoiceArena 的 14 个系统对比中取得最低的说话人归属转录错误率。
支持 40 种语言及指令控制转录: 覆盖 40 种语言的语音转录、31 种语言与英语之间的翻译,以及 13 种语言的说话人归属识别。开发者可通过提示词指定逐字转录、文本规范化、专业术语或音频问答,无需为不同任务分别训练模型。
多语言语音识别平均词错误率为 4.62%: 在 Hugging Face 多语言 Open ASR 评测中取得开放权重模型领先成绩;结合语音编码器与说话人识别模型,在生成过程中同步完成语音内容识别和说话人标注。
开放模型权重与微调工具: 提供 BF16、FP8、NVFP4 等版本,并配套 Granary v2 多语言语音数据集及 NeMo Speech 微调工具,支持开发者针对行业术语、口音和转录格式进行适配。模型面向录音处理,暂不属于实时流式 ASR。
https://huggingface.co/blog/nvidia/nemotron-transcribe-granary
2、Voice AI 评测机构 Voice Arena 推出双声道对话数据集 Joy:10 万小时真实双人通话,保留打断、插话与轮次交替信息
Voice AI 评测机构 Voice Arena 推出对话数据集 Joy,收录 10 万小时无脚本双人通话,覆盖 10 种语言、5 万名说话者。数据集为两名说话者分别保留独立音轨,记录真实对话中的重叠发言、附和与停顿等时序信息,用于训练语音模型学习自然的轮次交替、打断和全双工交互。
10 万小时真实双人对话: 数据来自未经脚本编排的自然交流,每位说话者拥有独立音轨,保留双方同时说话时的原始声音信息。
保留对话中的重叠与附和行为: 数据包含插话、停顿、附和声及轮次切换等现象,平均每小时约发生 350 次重叠发言,帮助模型学习何时倾听、回应或介入对话。
面向全双工语音模型训练: 双声道数据可让模型同时学习两名说话者的语音及时间关系,支持训练自然打断、边听边说和实时轮次管理等交互能力。
https://x.com/shobhitbanga/status/2115862853852995907
3、Deepgram 发布两款 Voice Agent 专用 LLM:Think-Live 管理实时对话,Think-Fast 处理工具调用与任务执行
Deepgram 发布两款专为 Voice Agent 设计的语言模型 Think-Live LLM 和 Think-Fast LLM,将实时对话管理与任务执行拆分为两个独立环节。Think-Live 负责判断何时倾听、等待或回应,Think-Fast 负责遵循业务规则、调用工具和生成口语化回复,使语音 Agent 能够在执行任务的同时持续响应用户。
Think-Live 管理实时对话节奏: 根据用户的停顿、回应和临时修改判断何时接话或继续倾听,减少抢话及工具执行期间的对话空白。目前已通过 Deepgram Voice Agent API 正式开放。
Think-Fast 负责工具调用与任务执行: 遵循业务规则、处理工具调用并生成适合语音播报的回复,可与 Think-Live 配合,也可单独接入现有 Voice Agent 架构。目前通过 Deepgram LLM API 提供早期访问。
引入实时上下文标准 RCS: Deepgram 与 Pipecat 联合提出 Real-Time Context Standard,在现有 Chat Completions 格式中增加三个字段,分别传递用户声音特征、Agent 响应指令和 TTS 播报方式,让语气、犹豫等信息能够跨模型传递。
https://deepgram.com/blog/voice-agents-that-keep-the-thread
4、实时 AI 公司 Inworld 更新语音合成模型 Realtime TTS-2:新增发声前推理,短句生成速度提升约 13%
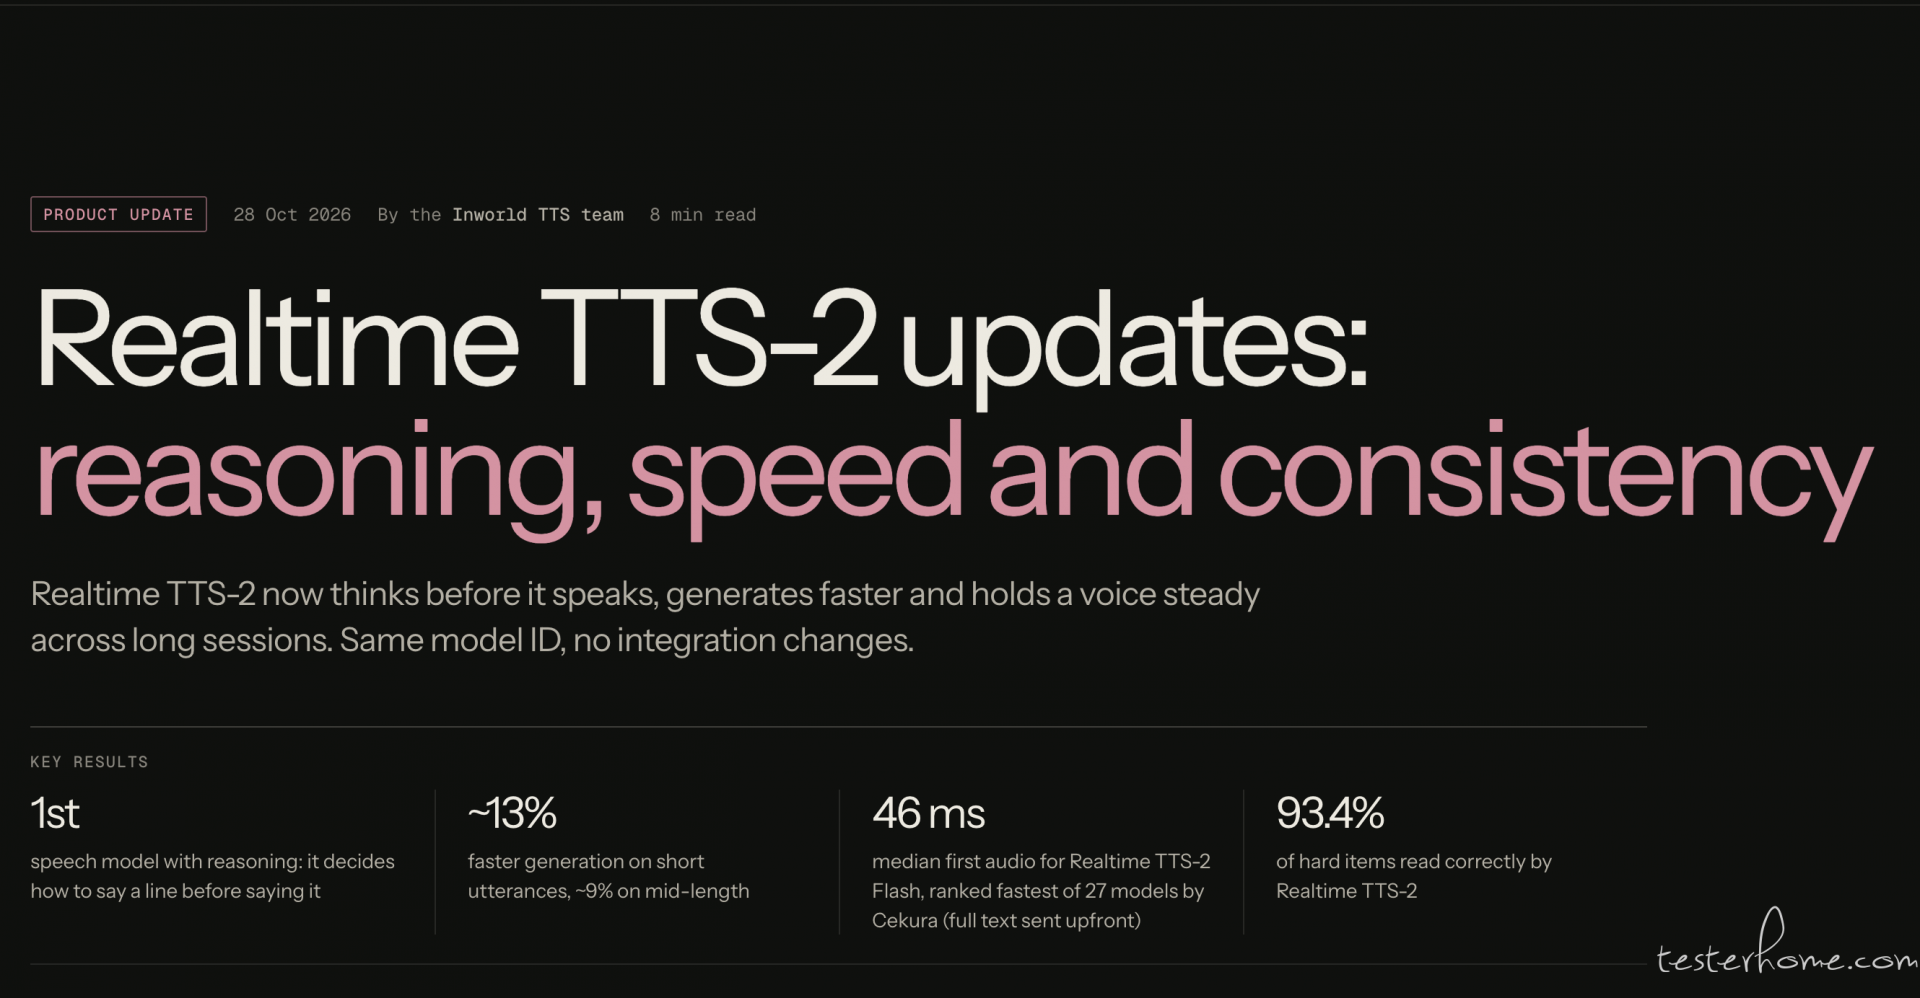
Inworld 发布 Realtime TTS-2 更新,新增 Reasoning 能力,让模型在语音合成前根据文本及上下文自动判断语气、情绪和表达方式,无需开发者逐句设置情绪标签。同时提升语音生成速度、声音一致性和长文本朗读准确性。
新增发声前推理能力: 模型先分析文本与上下文,生成包含情绪、语气及节奏的自然语言指导,再合成语音。同一句话可根据不同对话情境采用不同表达方式,生成的指导也会随 API 响应返回。
短句生成速度提升约 13%: Inworld 官方测试显示,相比上一版本,短句生成速度提升约 13%,中等长度语句提升约 9%,不同文本长度下的生成耗时也更加稳定。
改善声音一致性与长文本准确性: Stable 模式提升克隆声音与参考声音的相似度,减少长时间对话中的音色漂移,并修复长文本漏词及部分词尾辅音缺失问题。
Reasoning 通过现有 API 按需启用: 开发者可在请求中传入上下文,无需更换模型 ID 或额外调用服务。目前支持常规合成、流式响应及异步合成,WebSocket、双工实时 API 和批量合成支持仍在规划中。
https://preview-2025.dev.inworld.ai/blog/realtime-tts-2-reasoning-speed-consistency
5、实时视频 AI 公司 Xmax 发布交互视频模型 X2.1:覆盖十余项视频编辑能力,支持通过拖拽、多点触控和空间手势实时操控生成画面
实时视频 AI 公司 Xmax 发布交互视频模型 X2.1,重点提升视频生成的画质、稳定性和指令遵循能力,在单一模型中支持视频编辑、角色替换、触控交互及虚实交互等功能。新版本支持 1080p 视频生成,官方宣称延迟约 200ms,可用于直播互动、实时视频通话、游戏和虚拟试穿等场景。
统一支持多种实时视频交互: 覆盖十余项视频编辑能力,支持通过拖拽、多点触控和空间手势实时操控生成画面,并可在视频持续生成过程中调整角色、服装、背景及视觉风格。
实现 1080p 画质与约 200ms 延迟: 采用自研帧级自回归扩散架构与极少步去噪训练技术,结合模型压缩、算子加速和 GPU 调度优化,兼顾画面质量与低延迟生成。
提供低成本 API 接入: 官方中文发布稿给出的调用成本约为 0.0056 元/秒,开发者可通过 Xmax 平台接入模型,并在 StreamArena 中对比不同实时视频生成模型的表现。
1、Deepgram 收购 Daily,Pipecat 将保持开源和供应商中立,同步推出实时上下文标准 RCS
语音 AI 公司 Deepgram 宣布收购实时音视频平台 Daily,后者是开源 Voice Agent 框架 Pipecat 的开发方。Daily 团队将加入 Deepgram,双方计划整合语音模型、实时通信基础设施和 Agent 编排能力,构建面向生产环境的 Voice Agent 平台。同时,Deepgram 与 Pipecat 联合推出实时上下文标准 Real-Time Context Standard(RCS),让语气、说话人身份及背景声音等信息能够在语音处理链路中传递。
Daily 团队加入 Deepgram,现有产品继续运营: Deepgram 将继续提供和支持 Daily 的商业产品。Daily 联合创始人兼 CEO Kwindla Hultman Kramer 将担任 Deepgram 开源负责人。
Pipecat 保持开源与厂商中立: 框架继续采用 BSD-2 许可证,双方正推动成立独立的 Pipecat Foundation,由包括 Deepgram 竞争对手在内的企业组成指导委员会,支持开发者自由选择不同厂商的模型与服务。
RCS 跨模型传递实时音频上下文: 通过三类元数据传递用户语气、说话人及环境声音信息、LLM 处理指令和 TTS 表达方式。例如,Agent 可以根据用户的低声说话调整回应音量,或在未听清时主动请求澄清。官方已开放 Pipecat 示例项目。
https://deepgram.com/blog/daily-pipecat-deepgram
2、Cartesia 发布企业 Voice Agent 平台 Managed Agents:语音交互评测 Elo 达 1115,限时定价 0.03 美元/分钟
Cartesia 发布端到端企业 Voice Agent 平台 Managed Agents,将语音识别、对话轮次管理、工具调用和语音生成整合为统一系统。平台基于自研 Ink 语音识别与 Sonic 语音合成模型,支持接入开发者选择的 LLM,在 Artificial Analysis Speech Agent Arena 中以 1115 Elo 排名第一,限时价格为每分钟 0.03 美元。
联合优化语音模型与 Agent 编排框架: 采用语音识别、LLM 推理、语音合成的级联架构,统一协调轮次检测、打断处理和工具调用。Cartesia 内部测试中,85% 的对话未出现用户报告的轮次交替问题,对照系统为 67%。
Speech Agent Arena 排名第一: Artificial Analysis 盲测显示,Managed Agents 的偏好 Elo 达到 1115,工具调用任务成功率为 91.7%。在 ServiceNow EVA-Bench 中,Cartesia 报告任务准确率达 87.4%、交互体验得分达 90.7%,评测使用 GPT-5.5 作为推理模型。
集成企业级工具调用与知识库: 支持对接 CRM、业务 API 和文档知识库,提供批量外呼及个性化通话功能。支持构建 44 种语言的 Agent,目前可在对话中切换英语、西班牙语、印地语、法语和日语。
限时价格 0.03 美元/分钟: 正式开放企业级 Voice Agent 构建与部署,提供 50% 上线折扣,优惠持续至2026年12月31日。
https://www.cartesia.ai/blog/managed-agents
https://artificialanalysis.ai/zh/speech-to-speech/arena
3、Phonic 发布语音到语音模型 Phonic-1:支持边听边调用工具,完成 2750 万美元 A 轮融资
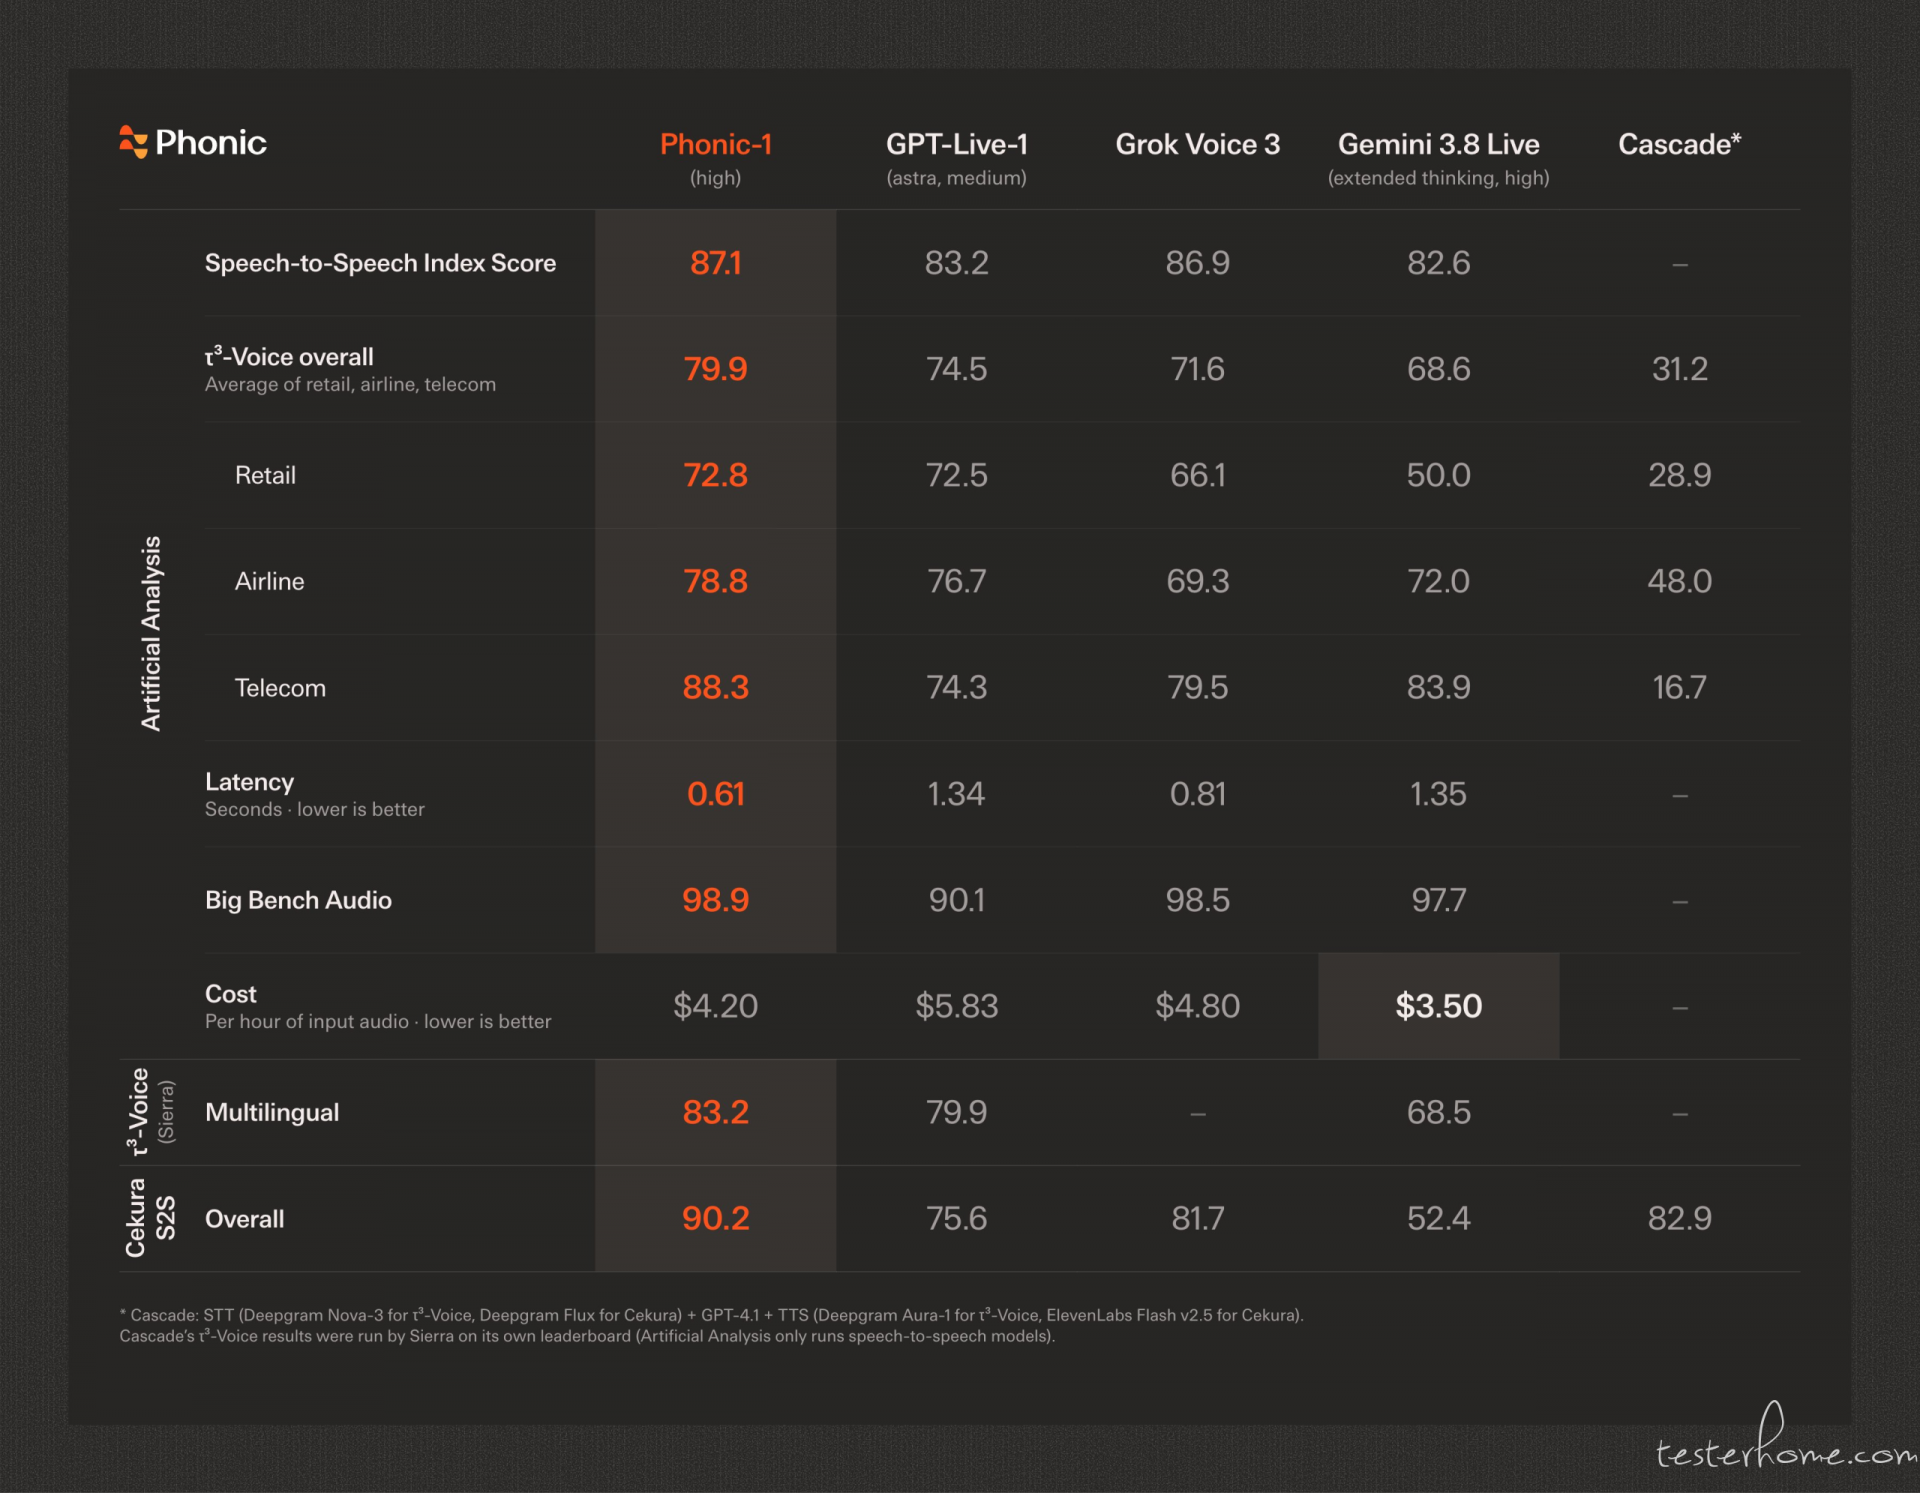
语音 AI 公司 Phonic 发布面向智能体任务的原生语音到语音(S2S)模型 Phonic-1,支持在用户尚未结束发言时提前调用工具,在保持自然对话的同时缩短任务响应时间。模型在 Artificial Analysis 语音到语音综合评测中以 87.1 分位列第一,Phonic 同时宣布完成 2750 万美元 A 轮融资。
边听边执行工具调用: 模型能够在用户说话过程中启动查询和操作。官方旅行预订演示中,Phonic-1 在用户结束发言前完成 5 次工具调用,结束后 1.1 秒给出回复;对照模型耗时 15.7 秒。
语音智能体任务成功率达 79.9%: 在 Artificial Analysis 的 τ³-Voice 评测中取得 79.9% 的任务成功率,首段音频延迟为 0.61 秒。模型还能根据语气、停顿等声音信息处理对话轮次及回应。
支持 50 多种语言及对话中切换语言: 可在英语、西班牙语、日语和中文等语言间切换,同时保持说话人声音一致。官方展示了一段持续 44 分钟、完成 123 次工具调用的酒店预订对话。
完成 2750 万美元 A 轮融资: 由 First Round 领投,Lux Capital、Felicis、Definition 等参投,累计融资达到 3150 万美元。Phonic-1 已正式开放使用。
https://x.com/moinnadeem/status/2115830871014183088
1、李亮谈红果短剧:核心是内容质量,专家自媒体应遵守道德规范
第一财经 10 月 29 日报道,按用户总使用时长计算,红果已成为国内第四大 App,仅次于抖音、微信和抖音极速版;该文援引 QuestMobile 数据称,今年 7 月红果日活跃用户达到 1.68 亿。围绕短剧发展与「字节时间」争议,抖音集团副总裁李亮同日再次发文。
李亮认为,短剧与传统影视剧的差别主要在载体和表现形式,核心仍是内容质量。他以单集时长为例:若改为 45 分钟或 90 分钟一集,短剧与电视剧、电影之间的区别便会缩小。随着更多有知识、有文化的创作者加入,他认为短剧质量正在迅速提升。
他举出红果的非遗题材短剧《鱼皮穿出新花样》:作品围绕赫哲族鱼皮制作技艺,讲述手艺人与返乡年轻人制作鱼皮画、开展直播、传承手艺的故事。李亮还看好 AI 在历史、科幻题材中降低复杂场景制作成本,并称包括腾讯绿泡泡在内的同行正在快速增长,希望各方「在阳光下竞争,共同健康发展」。
谈到与秦朔的争论,李亮表示,专家转型自媒体、收费高于普通自媒体,只要市场接受就是合理的,但应遵循基本道德规范。他反对以部分应用的使用时长数据,对整个中国互联网作出「字节时间」的定性。
( @APPSO )
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与 「RTE 开发者日报」 内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考
