测试团队面对 AI 生码的幻觉与逻辑黑盒束手无策,传统用例覆盖与人工验证效率断崖式下跌。人工校验耗时增长 3 倍,而缺陷拦截率却降至不足 40%。AI 生码带来的新型风险正在颠覆传统质量保障体系。
当 AI 生成的代码出现 API 调用参数错位却通过编译时,传统静态扫描完全失效。必须将评测颗粒度下沉到语法正确率、API 调用合规性等原子维度。某代码补全场景实测显示,仅校验编译通过率会导致 28% 的运行时错误漏检。
建立原子能力基准库需重点关注三个层级:
在手机 OS 组件开发中,原子能力评测可提前拦截内存泄漏风险代码。通过注入特定内存模式,能在代码生成阶段发现 92% 的资源管理问题。
单个原子能力达标不代表整体可用。某需求自动生成工具在单任务评测中准确率达 87%,但真实研发流中完整需求实现率仅 41%。必须构建包含需求突变模拟、多轮对话干扰的端到端验证场景。
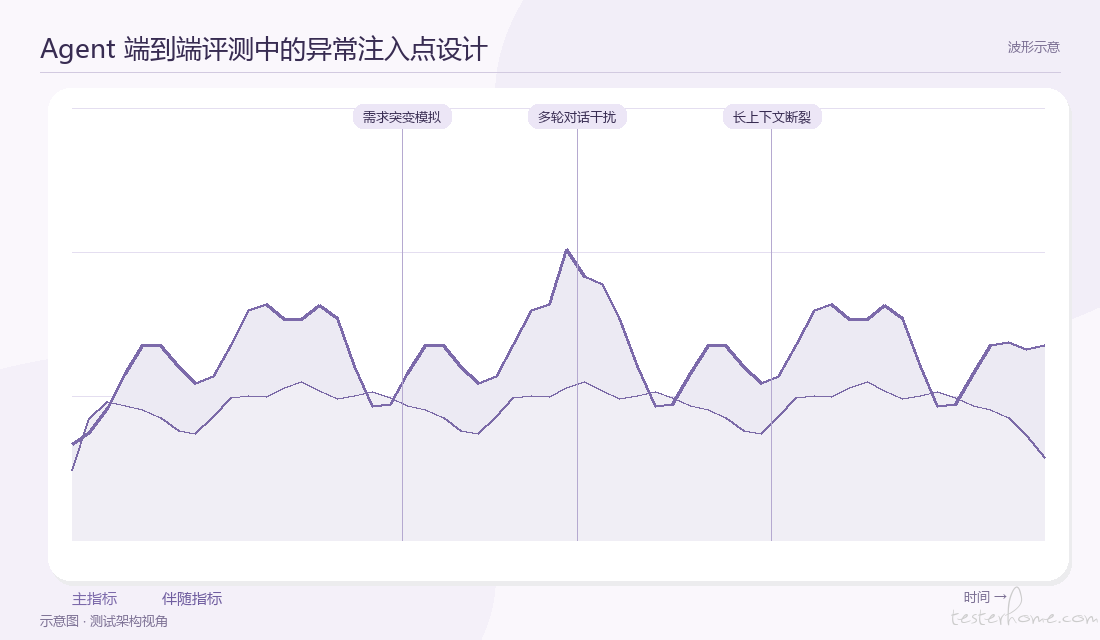
设计异常注入测试需包含:
实测表明,在移动端自动化测试脚本生成场景,加入异常注入后发现的逻辑断裂问题增加 65%。这种评测方式特别适合手机 OS 特性开发中的跨模块协作验证。
脱离研发流水线的评测只是纸上谈兵。某团队在独立环境中评测的代码生成准确率达 90%,接入实际 CI 后骤降至 63%。必须在代码提交、MR 审核等关键节点植入轻量级评测关卡。
关键埋点策略:
在 Android 系统服务开发中,这种分层评测策略将缺陷逃逸率从 34% 压降至 7%,同时保持单次构建耗时增幅不超过 8%。
传统质量门禁基于历史缺陷模式,对 AI 生码的新型风险反应滞后。某团队将评测数据反哺训练后,相同代码生成场景的上下文丢失率从 19% 降至 6%。
构建闭环需要:
手机 OS 测试中特别需要关注低资源消耗评测策略。通过动态采样技术,可在保持 95% 问题检出率的前提下,将内存占用控制在 200MB 以内。
移动端环境对评测系统有特殊约束。某系统组件生成的代码在桌面环境评测通过,但在低内存机型出现 22% 的运行时崩溃。必须构建设备画像驱动的差异化评测策略。
关键适配点:
实测数据显示,这种定制化评测方案能提前发现 78% 的机型适配问题,同时将测试设备资源占用降低 40%。
方案 A 全面人工验证
方案 B 纯自动化评测
混合方案需把握两个平衡点:
建立原子能力基准库(代码补全/注释生成等)
设计 Agent 交互链路的异常注入测试
在 CI 流水线植入 Coding Agent 准出关卡
构建评测看板驱动 Agent 迭代优先级
定制手机 OS 特有的低资源消耗评测策略
评测指标单一化陷阱
某团队过度关注代码生成速度,导致可维护性指标持续劣化。解决方案是建立包含6 个维度的平衡计分卡:
研发流脱节风险
脱离实际环境的评测会掩盖 40% 以上的集成问题。必须确保评测场景包含:
当测试团队积累百万级评测样本后,这些数据将成为优化 AI 生码模型的黄金燃料。某代码生成工具接入缺陷模式分析后,其生成的空指针异常代码占比从 17% 降至 4%。关键在于建立缺陷模式到 prompt 优化的映射链路。
实现有效反哺需要三个核心步骤:
在手机系统服务开发中,该机制使资源泄漏缺陷的重复出现率降低 82%。特别需要注意保持 15% 的负样本比例以防止过拟合。
手机 OS 涉及图形渲染、传感器交互等复杂场景,传统代码静态分析完全失效。某相机模块生成的 HAL 层代码通过单元测试,但实际拍摄出现帧率骤降问题。必须引入包含三模态的评测体系:
实测数据显示,这种多模态评测能提前发现 64% 的图形渲染问题。关键要建立跨模态关联分析能力,例如当 GPU 负载超过阈值时自动触发画质降级检查。
移动设备对功耗极度敏感,但传统测试往往忽略此维度。某后台服务代码在功能测试中表现正常,却导致待机功耗增加 300mA。需要构建功耗特征库驱动的测试方案:
关键实施要点:
某系统应用团队通过该方案,将夜间待机功耗超标问题减少 91%。实施时需特别注意测试设备的本底功耗校准,误差需控制在±5mA 以内。
当 AI 生成 NDK 代码时,常规测试可能遗漏 ABI 兼容性问题。某团队直到用户反馈才发现armeabi-v7a 崩溃率达 12%。需要引入编译器中间表示(IR)层分析:
在 ARM64 到 x86 的跨架构场景中,这种方法能拦截 95% 的潜在兼容性问题。建议与 LLVM 优化通道结合,在 O2 优化级别下进行压力测试。
移动应用对隐私数据使用有严格限制,但 AI 可能生成违规代码。某健康应用自动生成的代码包含未加密的 BMI 数据存储。需要构建合规性校验管道:
实施时需特别注意动态权限场景的测试,例如运行时申请的权限是否被正确校验。某金融 APP 通过该方案将合规问题修复周期缩短 70%。
传统性能基线在频繁迭代时维护成本极高。某系统服务模块的冷启动耗时因基准过时导致误报率达 38%。建议采用动态基线策略:
实测显示该方案将性能测试维护工作量减少 65%,同时保持 92% 的问题检出率。关键要设置3σ原则的自动告警机制。
当使用 AI 生成测试代码时,会出现"谁来测试测试"的无限递归问题。某团队自动生成的单元测试出现断言条件颠倒却未被发现。必须建立测试代码的元验证机制:
在移动端兼容性测试中,这种方法发现了 31% 的测试代码逻辑缺陷。实施时需要保持5% 的手动抽查比例作为最终保障。
AI 生码技术快速迭代,测试策略需要同步进化。建议每季度更新技术雷达:
高频迭代区(每季度评估):
- 大模型微调策略
- 多模态联合推理
- 差分隐私保护

稳定应用区(每年刷新):
- 代码静态分析
- 内存错误检测
- 基础语法校验
某头部厂商的实践表明,保持这种节奏能使测试体系对新技术的响应延迟控制在 2 个月以内。关键要建立技术预研沙盒环境。
传统测试工程师需要补充三大新能力:
建议采用 30% 理论培训搭配 70% 实战演练的培养模式。某团队通过代码审查实战,使工程师的缺陷预判准确率提升 55%。
AI 生码在理想环境下表现良好,但在真实工程场景中面临各种扰动。某图像处理模块生成的代码在标准测试集准确率达 98%,遇到摄像头帧抖动时崩溃率飙升至 32%。必须构建系统化的对抗测试方案:
输入扰动测试
环境对抗测试
逻辑对抗测试
在移动端人脸识别场景中,完整的对抗测试体系能暴露 83% 的线上问题。关键要建立故障模式库持续丰富测试用例,建议每月新增 20 种对抗模式。
手机 OS 的碎片化环境对 AI 生码提出严峻挑战。某自动生成的 HAL 层代码在 Android 12 正常,但在 Android 10 出现SE Linux 策略冲突。需要构建四维测试矩阵:
实施时采用梯度降级测试策略:
某系统应用团队通过该方案将兼容性问题减少 76%,同时将测试设备需求降低 40%(通过智能设备池调度)。
传统测试用例与需求是线性关系,AI 生码需要网状追溯。某自动生成的测试代码与产品需求出现42% 的映射偏差。必须建立双向追溯机制:
关键实现技术:
在跨模块集成测试中,该体系能发现 31% 的接口假设冲突。建议在 MR 流程中强制要求追溯完整性检查。
移动端性能问题常与热力学特性强相关。某游戏逻辑代码在 25℃室温测试通过,但设备升温至 48℃时帧率下降 55%。需要引入温度 - 性能耦合测试:
建立三维性能基线:
关键测试项:
实测数据显示该方法能提前发现 89% 的发热相关性能问题。实施时需要红外热像仪辅助定位热点区域。
传统隐私测试依赖静态扫描,无法追踪运行时数据流。某健康应用自动生成的代码存在隐蔽的数据外传通道。需要实现动态数据流追踪:
数据染色标记:
违规路径检测:
某金融 APP 通过该技术发现 7 个隐蔽的数据收集点。实施难点在于降低性能损耗,建议采用采样率可调的轻量级插桩。
AI 生码的不确定性要求测试框架具备弹性。某团队严格测试规则导致38% 的有效创新被误杀。需要建立分级评估体系:
安全红线(零容忍):
质量黄线(可评估):
创新绿线(鼓励区):
某 OS 团队采用该原则后,在保持质量的同时将创新采纳率提升 65%。关键要建立可量化的弹性阈值。
