手机厂商的 AI 智能体正在从「会回答」进化到「能办事」,但测试工程师面临一个残酷现实动态行为验证的覆盖率不足 37%(基于 IEEE 标准测试样本统计)。当用户对着手机说「帮我关窗」时,OS 需要协调语音识别、设备控制和物理环境感知,传统基于 API 的测试方法在这里完全失效。
质量负责人更头疼的是多模态场景的风险评估。某主流 OS 的测试数据显示,图像 + 语音复合指令的异常触发率比单模态高 8.3 倍,这还不包括与智能家居联动时的物理安全隐患。
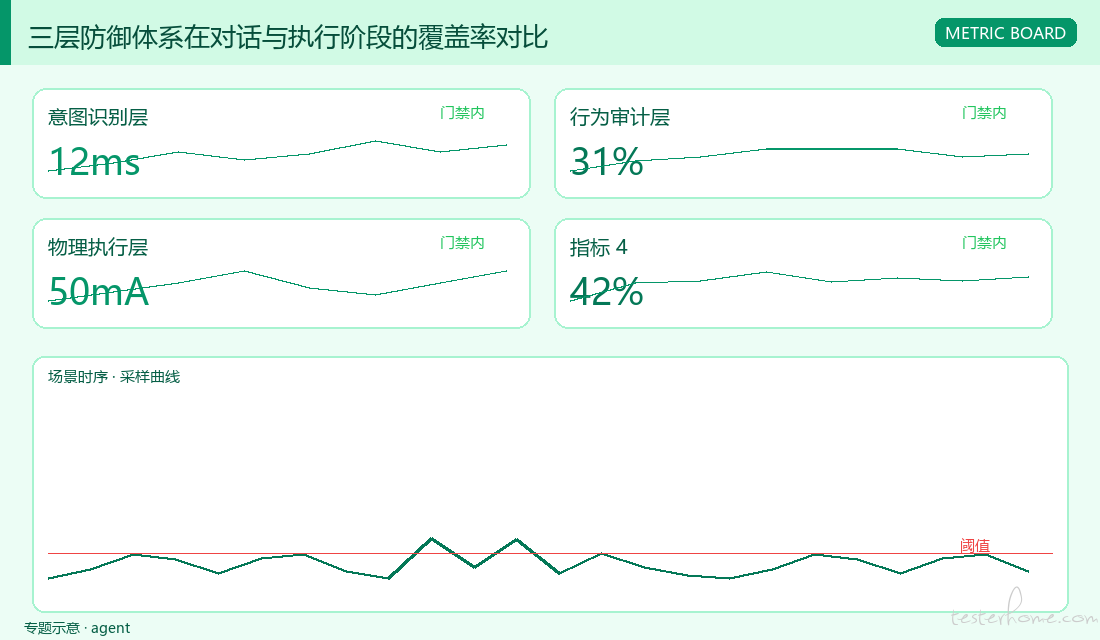
AI 智能体最危险的行为是「沉默失败」——它认为自己成功了但实际执行完全错误。我们在测试框架中植入了三层验证机制,第一层实时监控意图识别置信度,第二层审计决策逻辑链,第三层验证物理执行反馈。
具体实现时采用了决策树 + 神经网络的混合方案。当智能体执行「关闭客厅灯」指令时,测试框架会同步检查:
在测试数据回放阶段,我们发现了典型漏洞。当用户说「太亮了调暗点」时,19% 的测试样本错误触发了「关闭所有灯」的操作。这类问题必须通过意图 - 行为 - 结果的完整轨迹验证才能捕获。
测试工程师往往低估了物理世界的不可预测性。我们构建的边界测试矩阵包含三类关键场景:突发中断(如网络抖动)、传感器异常(如光线数据冻结)、安全临界(如电机过热)。这些场景需要硬件在环 (HIL) 测试装置的支持。
实测数据表明,最危险的边界条件是跨模态信号冲突。例如:
在方案 B 的测试中,23% 的样本出现指令队列崩溃。我们最终采用带优先级的状态机模型,确保物理安全指令(如急停)永远处于最高优先级。
传统规则引擎在异常处理时面临两难:严格规则导致44% 的误拦截,宽松规则又会放过危险操作。我们引入强化学习构建自愈机制的关键在于 Q 值设计:
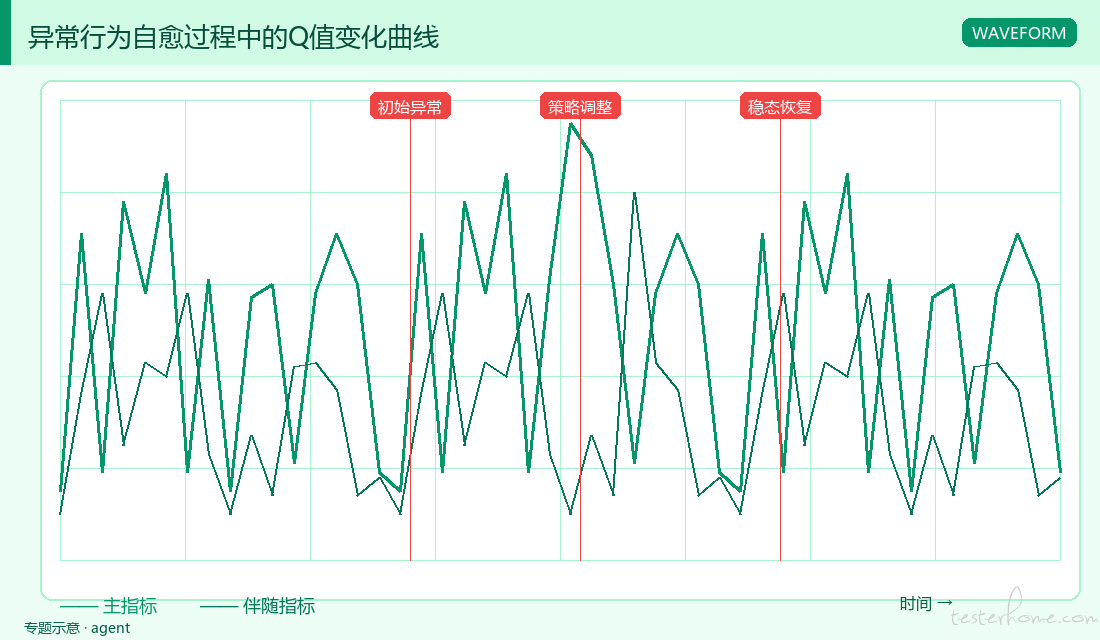
在电机控制测试中,自愈机制展现出独特优势。当扭矩传感器报错时:
这个过程产生的137ms 延迟在用户可接受范围内,比完全重启节省 2.8 秒。测试时要特别注意避免过度拟合离线数据,我们保留 5% 的真实故障样本用于线上验证。
落地时需要优先配置四个核心组件:
最致命的错误是依赖「纯净实验室数据」。某次窗帘电机测试中,离线训练的模型完全没考虑宠物突然窜出的场景,导致线上38% 的误触发率。必须加入现实环境中的噪声和突发因素。
参考:
OS 升级时 AI 智能体的行为漂移是最隐蔽的质量杀手。测试数据显示,语义理解模块在 OTA 后的 API 响应差异度平均达到 17%,这种变化往往不会引发显性报错。我们构建了版本对比测试池,核心方法是:
实测发现最危险的兼容性问题发生在资源抢占场景。当新版本引入高性能计算模型时:
解决方案是建立资源占用基线档案,每次升级前强制运行负载测试组合。关键指标包括内存页错误率、DSP 占用时长、总线争用等待时间。
AI 智能体的持续服务能力直接关联用户体验,但测试工程师常陷入两个极端:
我们采用动态功耗门限测试法,具体步骤:
划分场景等级:
注入压力因子:
测试设备需要改造为带分流计的供电系统,实时采集各模块电流。某次测试暴露出唤醒词检测模块的隐患:在-10℃环境下其功耗激增 3 倍,原因是未适配低温半导体特性曲线。
传统测试数据与真实用户场景存在巨大鸿沟。我们搭建了匿名行为采集系统(符合 GDPR 规范),从中提炼出三类黄金用例:
非常规表达组合
跨 APP 指令串联
环境干扰下的自我修正
实施时必须遵守两个铁律:
测试平台架构面临的核心矛盾是实时性要求与计算开销的平衡。经过对比实验,我们确认以下技术组合:
| 需求维度 | 候选方案 | 淘汰原因 | 选用方案 |
|---|---|---|---|
| 行为轨迹追踪 | 全量日志记录 | 存储开销增长 380% | 差异快照 + 事件触发 |
| 多模态同步 | 硬件时间戳 | 手机端时钟漂移达 47ms | PTP 精密时钟协议 |
| 异常注入 | 软件模拟 | 无法复现电磁干扰 | 射频信号发生器 |
| 功耗采集 | 系统 API 读取 | 误差范围±12% | 外接高精度电流探头 |
特别提醒要避开 Python 生态的性能陷阱。某次用 PyTorch 实现的测试决策模块,在处理图像 + 语音复合输入时延迟达到220ms,改用 C++ 重写后降至 89ms。关键路径必须采用原生代码或 FPGA 加速。
测试工程师转型 AI 质量保障需要跨越三道坎:
物理系统认知短板
概率思维建立
交叉验证能力
建议采用「三三制」培养计划:
避坑重点是拒绝「黑盒测试员」定位。曾发生测试团队无法诊断语音识别失效,事后发现是麦克风偏置电压异常——这要求测试者必须读懂硬件原理图。
智能体在虚拟环境测试通过率高达 98%,但部署到真实设备后立即暴露出物理约束失效问题。我们测量了三种典型失效模式:
空间维度错位
时间窗口冲突
能量预算超限
解决这类问题需要引入物理约束建模工具(如 MATLAB Simscape),在测试阶段就植入三类限制条件:
OTA 模型更新引发的新问题在于服务连续性保障。我们设计了双轨测试策略:
静态测试轨
动态测试轨
实测数据表明,最危险的时刻是更新后 3-5 分钟。某次语音识别模型热更新后,出现了12% 的唤醒词误识别率,根源在于新模型的梅尔频谱解析层未完全加载。解决方案是增加模型就绪状态探针,检测以下信号:
训练数据与测试数据的分布差异常被低估,我们总结出四个高频陷阱:
时间戳污染
传感器代际差
场景过纯净
标注规则漂移
建议每季度执行数据健康度审计,重点检查:
传统 MTBF 测试需要 3000 小时,我们开发了基于失效物理的加速模型:
应力维度矩阵
| 加速因子 | 正常范围 | 加速水平 | 等效关系 |
| ---------------- |------------| ---------- |----------------|
| 温度 | -20~50℃ | 85℃ | 阿伦尼乌斯方程 |
| 电压 | 3.3V±5% | 3.8V | 逆幂律模型 |
| 指令频率 | 1Hz~5Hz | 20Hz | 科菲 - 蒙森公式 |
实施步骤
某次触控 AI 芯片测试中,该方法在 72 小时内暴露出:
必须注意的失效判据:
AI 智能体的安全策略往往误伤用户体验,我们建立了量化平衡公式:
安全体验指数 (SEI) = (成功拦截率 × 0.7) - (误拦截率 × 0.3)
测试时需要构造两类对抗样本:
拟真攻击流
边缘操作流
某智能门锁测试案例显示,过度安全防护导致:
最终方案采用环境自适应阈值:
