本期编辑:@ 三水、@ 鲍勃
1、OpenAI 将全双工语音模型 GPT-Live-1 开放 API:可边听边说,复杂推理交给 GPT-6 Astra 等后端模型
OpenAI 正式将 GPT-Live-1 开放至 API。该模型此前已于 7 月用于 ChatGPT Voice,这次开发者可以直接用它构建全双工 Voice Agent:模型持续同时处理输入和输出音频,不必等待用户明确结束一轮对话,就能决定继续听、回应、等待或处理打断。
从轮次式语音转向持续双向交互: GPT-Live-1 可以一边说一边继续听,并在同一个模型中联合处理用户语音和自身正在输出的语音,更自然地应对停顿、插话、附和和临时改口,而不是依赖「检测用户说完 → 再开始回复」的固定流程。
把「怎么聊」和「怎么思考」拆成两层: GPT-Live-1 主要负责实时语音交互,遇到搜索、复杂推理或工具调用时,可把任务委派给 GPT-6 Astra 等后端文本模型或第三方模型;后台执行期间,前台语音仍可继续与用户保持对话。
开发者可以直接控制语气、节奏和说话风格: 系统 Prompt 可指定语气、语速和对话风格,同时增强了对静音、背景噪声和长时间会话的处理,并支持关键词偏置、ASR 转录以及电话场景部署。
全双工评测相比 GPT-Realtime-2.1 提升 30 个百分点: OpenAI 在 Full Duplex Bench 上报告 GPT-Live-1 相比 GPT-Realtime-2.1 提升 30 个百分点;Speak 的早期测试中,语言学习者思考时被 AI 误打断的次数减少近 80%。
API 按语音前端单独计费: GPT-Live-1 当前价格为 0.05 美元/分钟,开发者再根据任务自行搭配后端推理模型和 Agent 框架。
https://openai.com/index/introducing-gpt-live-1-in-the-api/
https://x.com/OpenAIDevs/status/2098099269551149398
2、HeyGen 开源实时数字人参考框架:GPT-Live-1 负责全双工语音,LiveAvatar 驱动数字人,HyperFrames 动态生成交互界面
HeyGen 与 OpenAI 合作推出并开源一套 GPT-Live-1 × LiveAvatar × HyperFrames 实时 AI 应用参考架构,把全双工语音、实时数字人和动态可视化界面串进同一条交互链路。仓库默认提供一个日语教师 Demo,但核心代码被刻意做得足够精简,开发者可以替换角色 Prompt、工具和界面组件,改造成其他实时 Agent。
GPT-Live-1 直接负责「听和说」: 浏览器麦克风持续向服务器发送音频,没有单独的 VAD 或按键说话流程,由 GPT-Live-1 自己判断用户什么时候说完、什么时候回应,并支持用户中途打断。
LiveAvatar 给 Voice Agent 加上一张实时说话的「脸」: GPT-Live-1 生成的语音经编排服务器直接送入 LiveAvatar,数字人向浏览器实时输出音视频,语音链路不需要绕回浏览器再播放。
工具调用可以同步变成屏幕上的动态界面: 当 Agent 需要展示单词卡片、学习总结等内容时,后台 Responses 模型负责工具调用,编排层再把结构化结果发送到前端,由 HyperFrames 渲染成透明动态组件叠加在数字人视频上。
语音模型和复杂工具调用被拆成两层: 实时模型本身不直接持有工具;需要调用工具时,会把任务委派给后端 Responses 模型,再把生成的文字返回 GPT-Live-1 继续说出来,同时把工具结果送到前端。这延续了 GPT-Live-1「前台实时对话、后台复杂执行」的架构。
项目以 MIT 协议开源,更像可拆改的参考实现而不是完整产品框架: 官方明确将其定位为最小化集成示例,目前默认 Demo 是实时日语教师;修改两份 Prompt 文件即可更换数字人角色,新增一个工具只需补充工具定义、服务端处理和 HyperFrames 组件。
https://github.com/heygen-com/liveavatar-gpt-live-demos
3、Agora 开源 GPT-Live-1 会议助手 Agora Meeting Copilot:AI 可加入多人会议,并通过语音直接操作共享看板
Agora 开源 Agora Meeting Copilot,展示如何把 GPT-Live-1 作为一个真正的 AI 参会者加入多人实时会议。它不仅能听会、回答问题,还可以把语音指令转成工具调用,直接创建、移动和修改共享看板中的任务,同时保存带说话人信息的会议转写并生成会后纪要。
AI 作为独立参会者加入同一个 RTC 房间: Copilot 通过 Agora Conversational AI 接入会议,与真人共享实时音视频通道;默认只有参会者每轮主动点名后才回答,避免 AI 因旁人讨论或简单附和频繁插话。
语音可以直接修改共享看板: 参会者可让 Copilot 创建、更新、分配和移动任务。GPT-Live-1 负责实时语音交互,需要执行操作时再委派给 Responses 模型生成工具调用,由后端校验并修改会议里的共享状态。
会议转写和 AI 对话被拆成两条链路: Agora 实时转写服务持续生成带说话人信息的真人字幕,Copilot 则作为另一个系统参会者输出语音和回复文本;后端再统一归并为会议记录,因此即使不邀请 AI,转写和会议纪要仍可独立工作。
可二次开发的完整会议 Agent 示例: 项目包含 RTC/RTM、实时转写、GPT-Live-1 网关、工具调用、共享看板、会议纪要和 PostgreSQL 持久化等完整链路,业务工具也可以继续替换成工单、CRM、订单等企业系统。
https://github.com/zicojiao/agora-meeting-copilot
GPT‑Live‑1 + Agora 实战教程:做一个能参会、操作看板的 AI 助手
4、Hugging Face 发布 speech-to-speech v1.0.0:统一开源语音 Agent 的 Realtime 服务端,本地可直接接 OpenAI Realtime 客户端
Hugging Face 发布开源语音 Agent 框架 speech-to-speech v1.0.0。首个大版本把原本分散的 VAD、STT、LLM、TTS 和实时通信能力整理成统一 Realtime 引擎,开发者现在可以在本地启动一套兼容 OpenAI Realtime 核心事件集的语音 Agent 服务,并通过 WebSocket 或 WebRTC 接入现有客户端。
语音 Agent 获得统一 Realtime 服务端: 新版把启动方式整理为 serve、talk 和 local 三个命令,分别用于运行 Realtime 服务端、连接麦克风/扬声器客户端,以及在一个终端内启动完整本地语音 Agent;旧的原始 PCM/WebSocket 模式则被统一迁移到 Realtime API。
可以把 OpenAI Realtime 客户端直接指向本地模型栈: 框架实现 OpenAI Realtime GA 的核心事件集,并测试了 OpenAI Agents SDK 的 WebSocket 和 WebRTC 连接。底层仍是可替换的 VAD → STT → LLM → TTS 级联架构,因此语音识别、语言模型和语音合成都能单独更换。
新增更多实时语音后端: v1.0.0 加入 Qwen3-ASR、OpenAI 兼容 STT/TTS、状态化 Realtime 转写、实验性 vLLM Realtime 转写,以及 OmniVoice、Supertonic TTS,同时强化音频、文本与工具调用的输出排序、用户打断、远程请求取消和会话清理。
支持全本地和混合部署: Apple Silicon 可通过 MLX 在本机运行 STT、4-bit Qwen3-4B 和 6-bit Qwen3-TTS;NVIDIA GPU 也可运行完整本地模型栈。开发者还可以只把 STT/TTS 留在本地,将转写后的文本交给托管 LLM,从而避免麦克风原始音频上传云端。
https://github.com/huggingface/speech-to-speech/releases/tag/v1.0.0
5、Hume AI 发布语音复制排行榜:11 款模型克隆同一批 25 个声音,真人盲评「到底像不像本人」
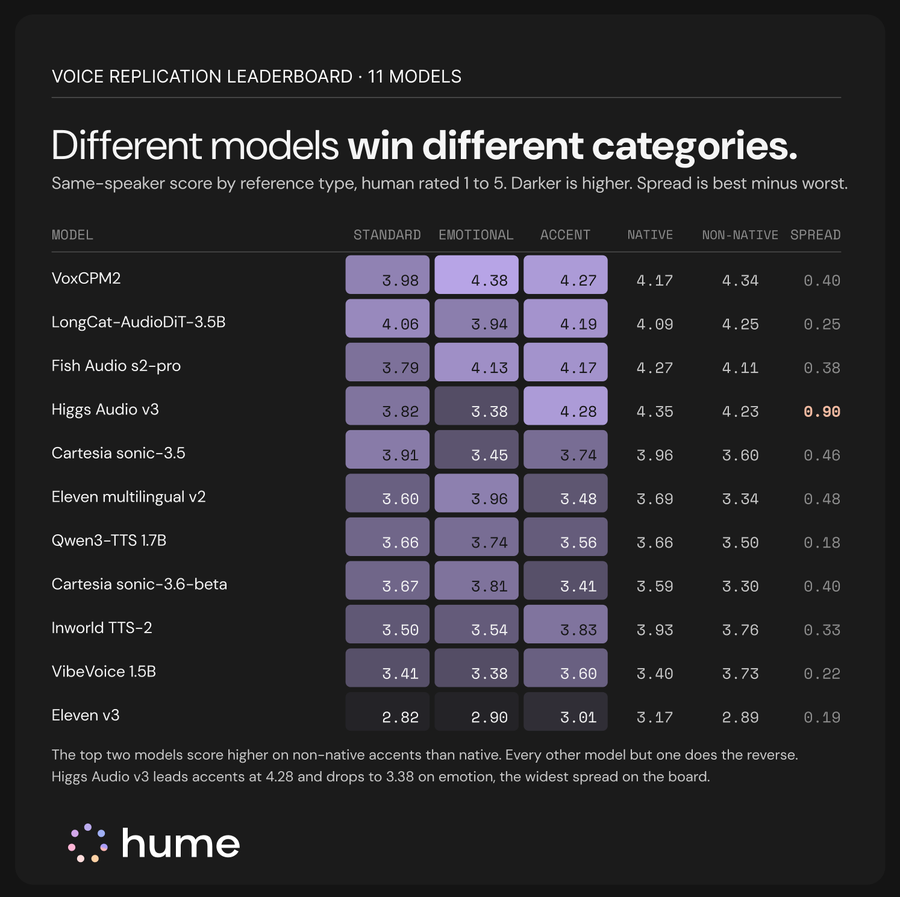
Hume AI 推出公开的 Voice Replication Leaderboard,专门评估声音克隆模型能否保留原说话人的身份特征。团队让 11 款声音克隆模型分别复制相同的 25 个声音,再由真人听众判断生成声音与原始声音是否「像同一个人」,排行榜和音频样本已在 Hugging Face 开放试听。
不再只看语音自然度,而是单独测「像不像本人」: 传统 TTS 评测常关注自然度、清晰度或整体音质,但一个声音即使非常自然,也可能已经不像参考说话人。Hume 将「说话人身份相似度」单独拿出来做真人评测。
「最像真人」不等于「最像本人」: Hume 特别指出,在 11 款候选模型中,听起来最自然、最像真人的克隆模型,在语音复制排行榜中仅排 第 8,说明自然度和声音身份保真度并不存在简单对应关系。
所有模型复制完全相同的一组声音: 11 款系统都以同样的 25 位说话人为参考进行克隆,再把生成结果交给真人评审,从而减少不同测试声音带来的比较偏差。
排行榜直接开放音频对比: Hugging Face 页面提供原始声音与不同模型克隆结果,开发者可以直接试听。
https://huggingface.co/spaces/HumeAI/voice-replication-leaderboard
https://hume.ai/blog/introducing-the-hume-voice-replication-leaderboard
1、KAIST 提出流式音频 - 视觉语音令牌增强框架 AV-STE:用唇动修复噪声中的语义令牌,无需重训语音模型
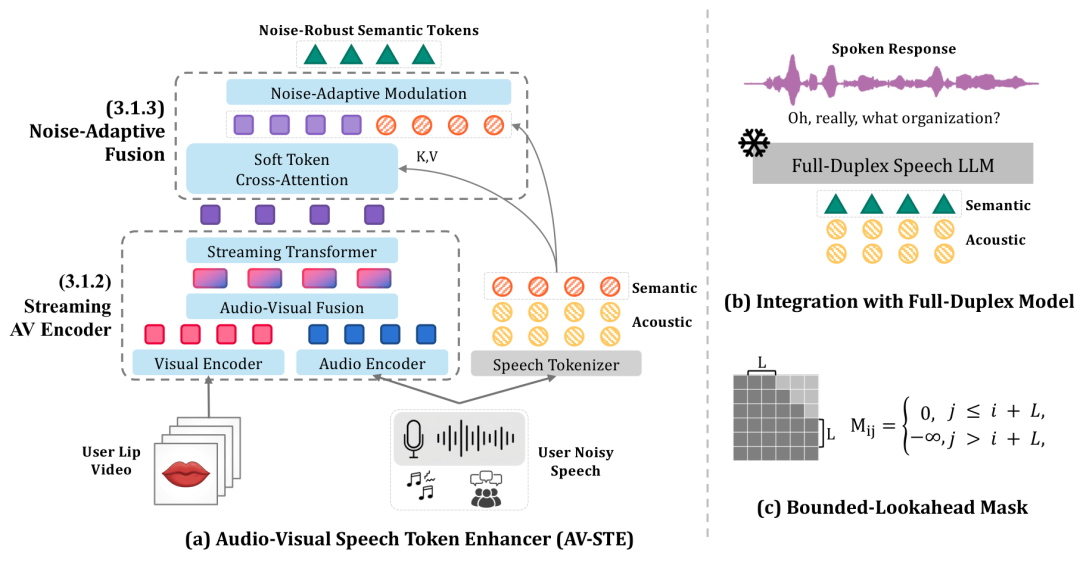
KAIST 团队提出 AV-STE,面向全双工语音对话模型的流式音视频前端。它不直接重建更干净的语音波形,而是结合噪声音频和说话人的唇部视频,恢复被背景噪声或其他说话人干扰破坏的 Mimi 语义令牌,再把修复后的令牌直接送入 Moshi 等语音模型;下游模型本身保持冻结,无需重新做多模态训练。
修复的是语音令牌,而不是先做传统降噪: AV-STE 输入 16 kHz 噪声音频和嘴部视频,输出增强后的 Mimi 语义令牌,可直接替换原本受污染的令牌送入基于 Mimi 的 TTS 或语音语言模型。
声音越不可靠,就越依赖「看嘴型」: 系统基于 AV-HuBERT 融合音频和唇动特征,并通过噪声自适应门控动态决定两种信息的权重;音频清晰时更多相信语音编码结果,受到噪声或重叠说话人干扰时则增加视觉唇动信息的作用。
不需要把原有全双工模型重新训练成音视频模型: 传统做法往往需要修改大型语音对话模型并重新进行音视频联合训练;AV-STE 被设计成独立前端,Moshi 全程冻结,因此可以把视觉抗噪能力外挂到已有语音模型前面。
重叠说话人场景下,Moshi 回复连贯度从 1.42 提升至 1.91: 在同数据集说话人干扰测试中,接入 AV-STE 后,GPT-4o 评估的 Moshi 回复连贯度平均分从 1.42 提升至 1.91,同时基本保持原有轮次交互行为;效果也迁移到未参与训练的 Seamless Interaction 数据。
代码和训练权重已开放: 项目提供两个 AV-STE Checkpoint、推理和训练代码,并附带将唇部视频处理成输入、输出增强令牌以及接入 Moshi 流式生成的完整流程。
https://github.com/bellagodiva/av-ste
2、开源 ESP32 Voice Agent 框架 ElatoAI 接入 Boson Higgs Realtime:支持端到端实时语音与用户打断
开源实时语音 Agent 框架 ElatoAI 新增对 Boson AI Higgs Realtime 的支持。开发者现在可以让 ESP32 等硬件通过 ElatoAI 的边缘服务器接入 Higgs Realtime,在原有 OpenAI、Gemini、Grok、ElevenLabs 和 Hume 等后端之外,再增加一套端到端实时 Speech-to-Speech 模型。
ESP32 可直接接入 Higgs Realtime 会话: 设备通过安全 WebSocket 将实时音频发送到 ElatoAI 的 Deno Edge 服务,再由服务端连接 Boson Realtime API;模型生成的 PCM 音频随后转换为 Opus 返回设备播放,AI 模型本身并不运行在 ESP32 本地。
支持服务端 VAD 和用户打断: 接入实现使用 Higgs Realtime 的服务端语音活动检测,当检测到用户重新开始讲话时,ElatoAI 会向设备发送 RESPONSE.INTERRUPTED,用于停止当前回复并切回用户输入。
Higgs Realtime 本身为端到端实时语音模型: Boson AI 公布其典型 speech-in 到 speech-out 延迟约 700ms,支持 100+ 种语言、工具调用和中途打断,并兼容 OpenAI Realtime API 的事件与协议格式。
ElatoAI 继续把硬件层与语音模型解耦: 同一套 ESP32 客户端目前可切换 OpenAI Realtime、Gemini Live、Grok Voice、ElevenLabs、Hume EVI 和 Boson Higgs Realtime 等服务,不需要为每个实时语音模型重新开发一套硬件通信链路。
https://github.com/akdeb/ElatoAI
https://www.boson.ai/higgs-realtime
3、时空壶发布 W4 Plus AI 翻译耳机:一副耳机同时做面对面对话、电话/会议双向翻译和媒体字幕
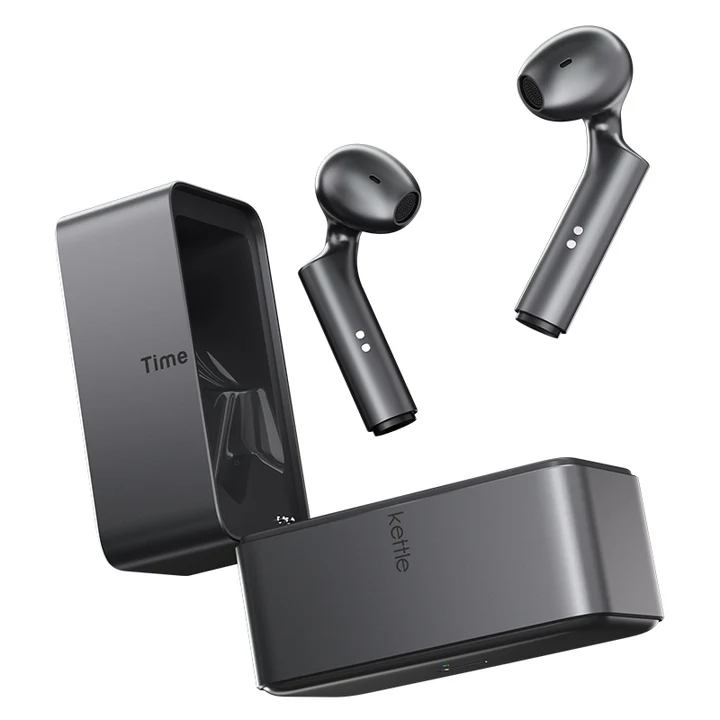
时空壶(Timekettle)推出 W4 Plus AI 翻译耳机。相比上一代 W4 主要服务面对面对话和现场听译,新款把系统电话、视频会议和音视频内容翻译纳入同一设备:用户只需自己佩戴耳机,即可在电话、Zoom、Microsoft Teams、微信、WhatsApp 等场景进行双向实时翻译,对方无需安装 App 或佩戴额外设备。
从面对面翻译扩展到完整沟通链路: W4 Plus 提供双人对话、现场听译、电话翻译和音视频翻译四种模式。面对面交流时两人可各戴一只耳机;电话和线上会议只需一方佩戴,手机同步显示双语转写;观看 YouTube、Netflix 等内容时则可生成实时翻译字幕。
VoiceFocus 专门强化嘈杂和低音量场景拾音: 新款在原有骨传导拾音基础上加入双麦克风和 VoiceFocus 降噪算法,用于机场、展会和会议等环境。官方称,相比原版 W4,其低音量语音拾取错误率降低 32%–47%。
Babel OS 3.0 开始处理长对话上下文和专业术语: 系统会根据语言对自动选择翻译引擎,并加入上下文优化;同时提供行业术语翻译、对话记忆和实时会议摘要,面向科技、制造、新能源、生物医药等专业交流场景。
支持 52 种语言、106 种口音和 13 组离线语言包: W4 Plus 可在线覆盖 52 种语言、106 种口音,并在提前下载语言包后进行部分离线翻译;耳机连续翻译超过 3 小时,充电盒可将总翻译时间延长至约 12 小时。
W4 Plus 已于 9 月 6 日通过 Timekettle 官网和 Amazon 开售,完整功能版售价 379 美元;另有 299 美元订阅版,电话、媒体翻译和高级 AI 功能需订阅解锁。
https://www.timekettle.co/products/w4-plus-ai-interpreter-earbuds
4、企业语音服务公司星语智能完成千万级天使轮融资:AI 400 热线日服务超 10 万分钟,部分项目完成率超 90%
聚焦企业 AI 400 热线的星语智能完成千万级天使轮融资。公司将端到端语音模型与多智能体协作应用到传统企业客服热线,让 AI 不只负责问答,还可以继续完成业务判断、流程办理和工单闭环;目前已在餐饮、出行、家电、快消、保险和政务等行业落地。
把 Voice Agent 从「回答问题」推进到「办完事情」: 星语的 AI 400 热线覆盖咨询答疑、投诉处理、业务办理、回访和销售运营等流程,并可在对话过程中读取业务系统数据、执行后续操作,而不是把复杂问题继续转给人工。
自研端到端语音模型面向客服沟通做垂直训练: 星语大模型已于今年 2 月通过生成式人工智能服务备案,重点处理实时语音中的情绪、角色、上下文和服务流程;公司同时通过多智能体协作拆解需要跨系统执行的长链路任务。
已经进入规模化运营阶段:其部分上线项目的 AI 服务完成率超过 90%,单日 AI 服务时长超过 10 万分钟;此前已服务滴滴、海底捞、鱼跃医疗、松下等企业。
十余人团队已跑通企业热线商业化: 星语智能由曾任西湖心辰 CEO、CTO 的赵盈和赵俊创立,此前公司成立约 8 个月即实现盈利,项目交付周期可压缩到 1–2 周。
(@36 氪)
1、AI 客服公司 Fin 的《2026 AI Sentiment Report》:AI 客服的信任不能靠用户「习惯」,而要主动设计
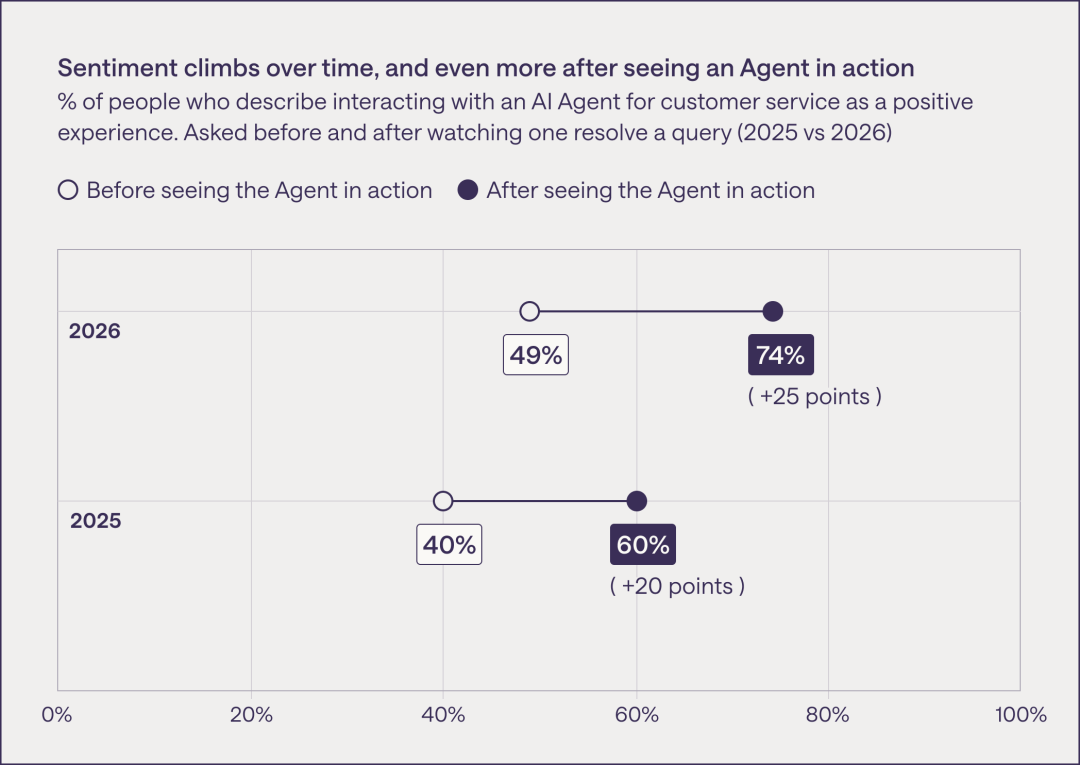
Fin 的《2026 AI Sentiment Report》发现,人们确实正在变得更接受 AI 客服:49% 的受访者表示自己对 AI 的整体体验积极,比 2025 年提高 9 个百分点;在看到 AI Agent 实际解决一个客服问题后,这一比例进一步升至 74%。但作者 Maia Bridi 提醒,因为接触越来越多而产生的接受,并不等于企业真正赢得了信任。
用户真正担心的,是 AI 出错后谁负责、复杂问题能否灵活判断,以及需要时能不能迅速找到真人。调查中,最能提高信任的两个设计分别是:需要时可以轻松升级给人工,以及一开始就明确告知正在与 AI 交互。
AI 客服的信任不是一个等待用户慢慢适应的问题,而是一个产品设计问题。 身份披露、人工兜底、责任机制和例外处理能力,都应该直接被设计进 Agent 的工作流里。
https://www.intercom.com/blog/the-2026-ai-sentiment-report/
招聘、项目分享、求助……任何你想和社区分享的信息,请联系我们投稿。(加微信 creators2022,备注「社区黑板报」)
1、📣 iRTE2026 定档啦!Voice Agent Builder 们,10 月北京集合~
今年从对话式 AI 一路聊到实时智能,现场有 15+ 论坛、100+ 场深度演讲,汇聚 150+ 全球技术领袖和行业专家,全双工 + 交互式模型、实时互动世界模型、AI 硬件、AI Coding 工具等方向都会集中开聊。
🔥 贾扬清也将返场 iRTE 大会,带来对 AI 行业前沿趋势和技术演进的最新观察~
🎫 目前大会门票限时免费开放!
想来现场听技术、认识同行的开发者,可以先把票薅上
📅 时间:10 月 23–24 日
📍 地点:北京悠唐皇冠假日酒店
限免结束后将恢复收费,建议先报名占位 👇
定档!从对话式 AI 到实时智能,Voice Agent Builder 的年度春晚 iRTE2026 来了丨 10 月 23-24 日,北京见!
阅读更多 Voice Agent 学习笔记:了解最懂 AI 语音的头脑都在思考什么
写在最后:
我们欢迎更多的小伙伴参与 「RTE 开发者日报」 内容的共创,感兴趣的朋友请通过开发者社区或公众号留言联系,记得报暗号「共创」。
对于任何反馈(包括但不限于内容上、形式上)我们不胜感激、并有小惊喜回馈,例如你希望从日报中看到哪些内容;自己推荐的信源、项目、话题、活动等;或者列举几个你喜欢看、平时常看的内容渠道;内容排版或呈现形式上有哪些可以改进的地方等。
作者提示: 个人观点,仅供参考
